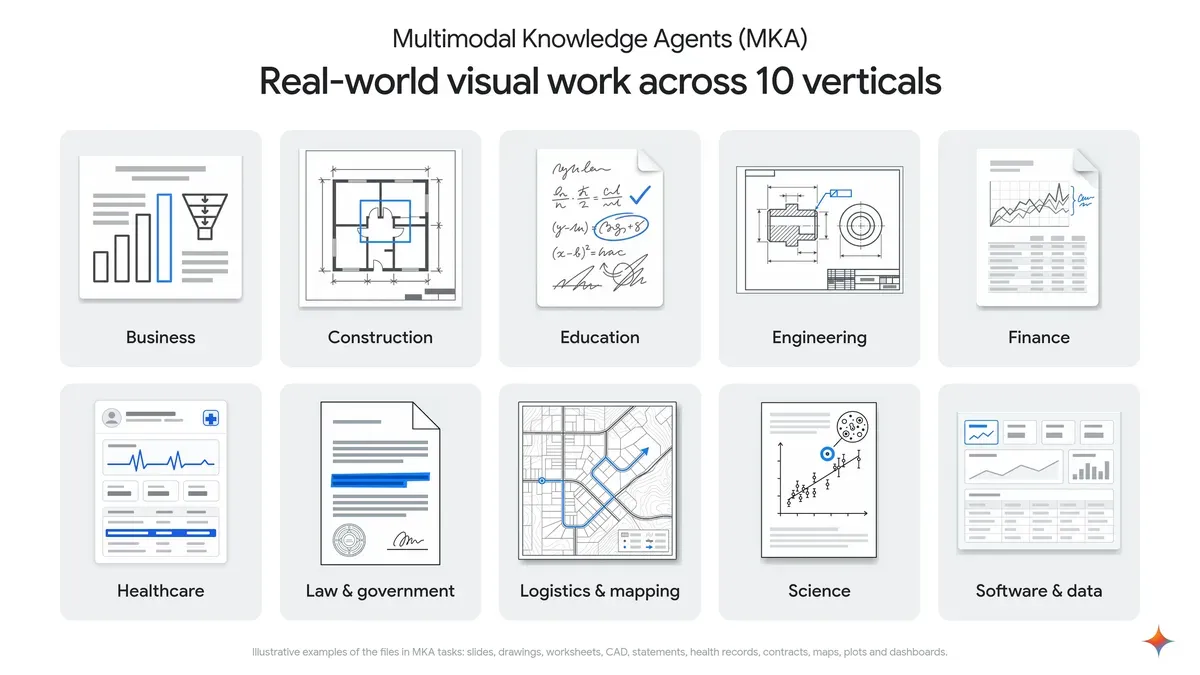
O Google DeepMind e a Artificial Analysis apresentaram o MKA, o benchmark Multimodal Knowledge Agent, projetado para testar o quanto os agentes de IA lidam bem com tarefas profissionais cuja evidência decisiva está dentro de blueprints, esquemas, digitalizações, gráficos e arquivos visuais semelhantes. O relatório argumenta que, uma vez removido o layout, muitos benchmarks de agentes existentes colapsam em problemas apenas de texto que os modelos conseguem resolver somente a partir dos tokens extraídos. O MKA, em vez disso, pontua o raciocínio visual em combinação com a qualidade do entregável, o custo de execução e o uso de ferramentas.
Por dentro da avaliação de 200 tarefas
Em cada tarefa do MKA, o agente recebe um espaço de trabalho com arquivos de origem e precisa produzir um entregável finalizado, como um relatório, uma planilha, uma apresentação de slides ou um desenho anotado. As tarefas reproduzem projetos em múltiplas etapas que profissionais experientes executam como parte de seu trabalho habitual.
- Tarefas: 200 atribuições pontuadas
- Cobertura: 10 verticais da indústria e 83 ocupações
- Esforço de especialista: três a oito horas por atribuição
- Saídas típicas: relatórios, planilhas, apresentações e desenhos anotados
- Ênfase da pontuação: 75% de precisão factual e 25% de design visual
Especialistas de cada área escreveram as atribuições, combinando prompts realistas com arquivos de origem multimodais e uma rubrica contendo cerca de 70 verificações ponderadas de sim-ou-não. A pontuação, portanto, julga o artefato submetido por seus próprios méritos, em vez de compará-lo a uma resposta de referência fixa.
Verificações difíceis conduzem a pontuação
Os critérios da rubrica são divididos em dois grupos: Climb e Regression. Os requisitos mais difíceis ficam no Climb e produzem a métrica principal, a taxa ponderada de satisfação do Climb (Climb WSR). Os critérios de Regression medem a competência de base, uma área em que os modelos de topo geralmente se agrupam.
A pontuação é feita por um agente de avaliação automatizado que carrega cada arquivo submetido, renderiza suas páginas, examina as fórmulas dentro das planilhas e confere o resultado contra a rubrica escrita por especialistas. A Artificial Analysis usa o GPT-6 Luna, um modelo que não é do Google, em sua configuração média como juiz. Na validação reportada, suas decisões de avaliação coincidiram com as de especialistas de domínio em 96% das vezes.
Um sandbox, 250 turnos
Cada tarefa é executada por meio do harness público Stirrup dentro de um sandbox Linux limitado a 250 turnos. Nesse ambiente, os agentes podem executar código, acessar a internet, pesquisar na web e buscar páginas; modelos que aceitam entrada de imagem também recebem um visualizador de imagens. As imagens de origem mantêm suas dimensões nativas, a menos que um provedor imponha seus próprios limites.
Para reduzir o vazamento do benchmark, o Google mantém as 200 tarefas pontuadas privadas. Uma amostra pública de 10 tarefas ilustra a estrutura dos arquivos, os prompts e os formatos de entregável esperados sem expor o conjunto de avaliação.
Pequenas diferenças de pontuação, contas grandes
Apenas quatro pontos percentuais separam os três líderes no ranking reportado de Climb WSR, mas seus custos médios de execução divergem muito mais fortemente:
- Claude Fable 5.2 (Max): 57% de Climb WSR, cerca de US$ 32 por tarefa em média
- Gemini 4 Carbon (High): 54% de Climb WSR, cerca de US$ 6 por tarefa em média
- Claude Opus 5.5 (Max): 53% de Climb WSR, custo não especificado
Várias configurações menores ou mais econômicas registraram os menores custos por tarefa:
- GPT-6 Luna (Max): US$ 0,18 por tarefa
- Claude Haiku 5.5 (Max): US$ 0,32 por tarefa
- MiMo-V2.6-Pro: US$ 0,32 por tarefa
- GPT-6.1 Sol: cerca de US$ 1 por tarefa
Uma tarefa de auditoria arquitetural mostra como o uso de ferramentas impulsiona a diferença de custo. O Claude Fable 5.2 alcançou 87% após 224 turnos, 203 visualizações de imagens, cerca de três horas de execução e aproximadamente US$ 68 em custos de execução. O Gemini 4 Carbon alcançou 72% após 76 turnos, cerca de uma hora e aproximadamente US$ 8.
Especialistas dividem o campo
O desempenho muda consideravelmente de uma indústria para outra, de modo que cada vertical tem um líder diferente:
- Claude Fable 5.2: Software & Data, Engineering, Logistics & Mapping, Business e Finance
- Claude Opus 5.5: Education e Construction
- Gemini 4 Argon: Science
- Gemini 4 Carbon: Healthcare
- Claude Sonnet 5.5: Law & Government
Os rankings também se movem com o formato de saída. As pontuações são mais fracas para documentos do Word e arquivos de texto puro, sem que nenhum modelo avaliado ultrapasse 52% em nenhum dos dois, enquanto PDFs, planilhas e apresentações produzem resultados mais altos. A escolha de um modelo para um produto de agente, portanto, depende da indústria-alvo e do artefato que ele precisa produzir, e não apenas da posição agregada no leaderboard.
Onde o MKA ajuda
Como a evidência necessária para concluir cada atribuição está embutida em material visual, o benchmark testa diretamente se um agente consegue interpretar esse material e transportá-lo para um entregável profissional utilizável. O relatório técnico que o acompanha também investiga como o desempenho muda quando os modelos perdem o acesso visual, o que ajuda a isolar a contribuição da percepção multimodal.
As contagens de turnos destacam outra restrição de implantação. Os modelos avaliados têm média entre 30 e 130 turnos por tarefa, produzindo amplas diferenças de latência e custo total de inferência. Para agentes em produção, observa o relatório, essas diferenças podem importar mais do que lacunas modestas nos preços de API por token.
O que as pontuações deixam em aberto
Várias decisões de design determinam até que ponto os resultados se estendem a sistemas em produção:
- O conjunto privado de 200 tarefas não pode ser inspecionado de forma independente, embora mantê-lo oculto reduza o risco de contaminação.
- O avaliador automático concorda com os especialistas em 96% das decisões de pontuação, de modo que uma pequena parcela das notas permanece incerta.
- O limite de 250 turnos, o sandbox e as ferramentas fornecidas descrevem um ambiente operacional específico que pode não se parecer com uma pilha de agente implantada.
- Os números de custo refletem configurações de modelo, uso de ferramentas, preços do provedor e comportamento em tempo de execução, e qualquer um deles pode mudar.
A Artificial Analysis publica o leaderboard completo junto com saídas de exemplo, e modelos adicionais podem ser avaliados nas mesmas condições por meio do repositório público Stirrup.