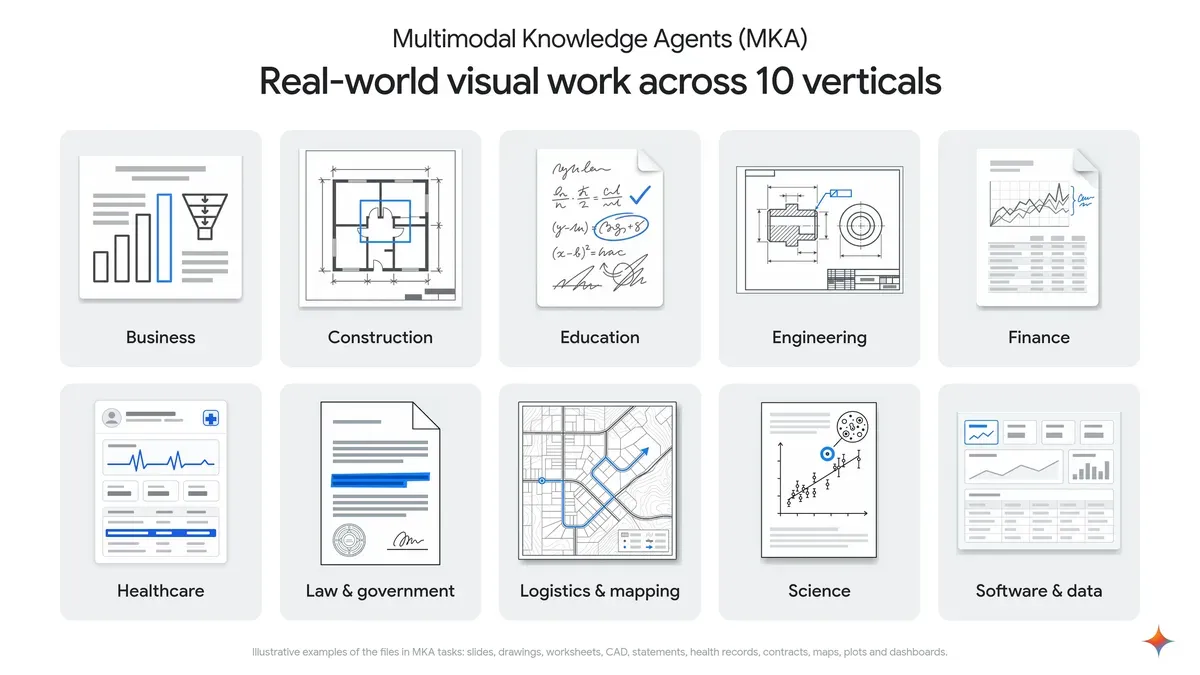
Google DeepMind y Artificial Analysis han presentado MKA, la evaluación Multimodal Knowledge Agent, diseñada para comprobar con qué eficacia los agentes de IA resuelven tareas profesionales cuya evidencia decisiva se encuentra en planos, esquemas, escaneos, gráficos y otros archivos visuales. El informe sostiene que, una vez eliminado el diseño visual, muchas evaluaciones de agentes existentes se reducen a problemas de solo texto que los modelos pueden resolver a partir de tokens extraídos. MKA, en cambio, puntúa el razonamiento visual junto con la calidad del entregable, el costo de ejecución y el uso de herramientas.
Dentro de la evaluación de 200 tareas
En cada tarea de MKA, el agente recibe un espacio de trabajo con archivos de origen y debe producir un entregable terminado, como un informe, una hoja de cálculo, una presentación o un dibujo con anotaciones. Las asignaciones reproducen proyectos de varios pasos que profesionales con experiencia realizan como parte de su trabajo habitual.
- Tareas: 200 asignaciones puntuadas
- Cobertura: 10 sectores industriales y 83 ocupaciones
- Esfuerzo experto: de tres a ocho horas por asignación
- Entregables típicos: informes, hojas de cálculo, presentaciones y dibujos anotados
- Énfasis de puntuación: 75% de precisión factual y 25% de diseño visual
Especialistas de cada campo redactaron las asignaciones, combinando instrucciones realistas con archivos de origen multimodales y una rúbrica que contiene unas 70 comprobaciones ponderadas de sí o no. La puntuación, por tanto, juzga el artefacto entregado por sus propios méritos en lugar de cotejarlo con una única respuesta de referencia.
Las comprobaciones difíciles determinan la puntuación
Los criterios de la rúbrica se dividen en dos grupos: Climb y Regression. Los requisitos más exigentes corresponden a Climb y generan la métrica principal, la tasa ponderada de satisfacción Climb (Climb WSR). Los criterios Regression evalúan la competencia básica, un terreno en el que los modelos líderes suelen agruparse.
La puntuación corre a cargo de un agente de calificación automatizado que carga cada archivo entregado, renderiza sus páginas, examina las fórmulas de las hojas de cálculo y coteja el resultado con la rúbrica redactada por expertos. Artificial Analysis emplea como juez GPT-6 Luna, un modelo ajeno a Google, en su configuración media. En la validación reportada, sus decisiones de calificación coincidieron con las de los expertos del dominio el 96% de las veces.
Un entorno aislado, 250 turnos
Cada tarea se ejecuta a través del arnés público Stirrup dentro de un entorno aislado de Linux con un tope de 250 turnos. En ese entorno, los agentes pueden ejecutar código, acceder a internet, buscar en la web y obtener páginas; los modelos que aceptan entrada de imágenes reciben además un visor de imágenes. Las imágenes de origen conservan sus dimensiones nativas salvo que el proveedor imponga sus propios límites.
Para reducir la filtración de la evaluación, Google mantiene en privado las 200 tareas puntuadas. Una muestra pública de 10 tareas ilustra la estructura de archivos, las instrucciones y los formatos de entregable esperados sin exponer el conjunto de evaluación.
Pequeñas diferencias de puntuación, grandes facturas
Solo cuatro puntos porcentuales separan a los tres líderes de la clasificación reportada de Climb WSR, pero sus costos medios de ejecución difieren de forma mucho más acusada:
- Claude Fable 5.2 (Max): 57% de Climb WSR, unos $32 por tarea en promedio
- Gemini 4 Carbon (High): 54% de Climb WSR, unos $6 por tarea en promedio
- Claude Opus 5.5 (Max): 53% de Climb WSR, costo no especificado
Varias configuraciones más pequeñas o económicas registraron los costos por tarea más bajos:
- GPT-6 Luna (Max): $0.18 por tarea
- Claude Haiku 5.5 (Max): $0.32 por tarea
- MiMo-V2.6-Pro: $0.32 por tarea
- GPT-6.1 Sol: alrededor de $1 por tarea
Una tarea de auditoría arquitectónica muestra cómo el uso de herramientas genera esa diferencia de costos. Claude Fable 5.2 alcanzó el 87% tras 224 turnos, 203 visualizaciones de imágenes, unas tres horas de ejecución y aproximadamente $68 en costos. Gemini 4 Carbon llegó al 72% tras 76 turnos, cerca de una hora y unos $8.
Los especialistas dividen el campo
El rendimiento cambia considerablemente de una industria a otra, de modo que cada sector tiene un líder distinto:
- Claude Fable 5.2: Software y Datos, Ingeniería, Logística y Cartografía, Negocios y Finanzas
- Claude Opus 5.5: Educación y Construcción
- Gemini 4 Argon: Ciencia
- Gemini 4 Carbon: Salud
- Claude Sonnet 5.5: Derecho y Gobierno
Las clasificaciones también varían según el formato de salida. Las puntuaciones son más bajas en documentos de Word y archivos de texto plano, donde ningún modelo evaluado supera el 52%, mientras que los PDF, las hojas de cálculo y las presentaciones producen mejores resultados. Elegir un modelo para un producto de agente depende, por tanto, de la industria objetivo y del artefacto que deba generar, no solo de la posición agregada en la clasificación.
Dónde ayuda MKA
Dado que la evidencia necesaria para completar cada asignación está integrada en material visual, la evaluación comprueba directamente si un agente puede interpretar ese material y trasladarlo a un entregable profesional utilizable. El informe técnico que lo acompaña examina además cómo cambia el rendimiento cuando los modelos pierden el acceso visual, lo que ayuda a aislar la contribución de la percepción multimodal.
Los recuentos de turnos ponen de relieve otra restricción de despliegue. Los modelos evaluados promedian entre 30 y 130 turnos por tarea, lo que genera amplias diferencias de latencia y de costo total de inferencia. Para los agentes en producción, señala el informe, esas diferencias pueden pesar más que las modestas brechas en el precio por token de las API.
Lo que las puntuaciones dejan abierto
Varias decisiones de diseño condicionan hasta qué punto los resultados se trasladan a sistemas en producción:
- El conjunto privado de 200 tareas no puede inspeccionarse de forma independiente, aunque mantenerlo oculto sí reduce el riesgo de contaminación.
- El evaluador automático coincide con los expertos en el 96% de las decisiones de calificación, por lo que una pequeña parte de las puntuaciones queda en duda.
- El tope de 250 turnos, el entorno aislado y las herramientas suministradas describen un entorno operativo concreto que puede no parecerse a la infraestructura de un agente desplegado.
- Las cifras de costo reflejan la configuración del modelo, el uso de herramientas, los precios del proveedor y el comportamiento en tiempo de ejecución, cualquiera de los cuales puede cambiar.
Artificial Analysis publica la clasificación completa junto con salidas de ejemplo, y es posible evaluar modelos adicionales bajo las mismas condiciones a través del repositorio público de Stirrup.