Operar uma base de conhecimento autogerenciada no Amazon Bedrock significa provisionar e escalar o armazenamento de vetores, escolher e ajustar um modelo de embeddings, configurar o índice e planejar a capacidade sempre que uma nova fonte de dados é adicionada. A AWS recomenda migrar essas cargas de trabalho para o Amazon Bedrock Managed Knowledge Base, que assume esse trabalho operacional e adiciona recursos de recuperação, enquanto a equipe mantém o controle do conteúdo e da aplicação que o utiliza. Para apoiar a mudança, a AWS adicionou um guia de migração de bases de conhecimento à skill amazon-bedrock do Agent Toolkit for AWS, permitindo que um agente de codificação ajude a planejar e executar a migração.
Migrar uma base de conhecimento em produção envolve mapear a configuração atual, criar a substituta, ingerir o conteúdo, atualizar a chamada de recuperação da aplicação e validar a recuperação antes de mudar o tráfego. O guia fornece ao agente o contexto necessário para planejar a migração junto com o usuário: começa com uma descoberta somente leitura e um plano que pode ser revisado linha por linha. Somente após aprovação explícita o agente cria a nova base de conhecimento e suas fontes de dados ao lado da original, ou escreve um template de infraestrutura como código (IaC) migrado para o pipeline da equipe. A ingestão e a atualização das chamadas Retrieve da aplicação ficam com a equipe, embora o agente possa orientar ambas.
O artigo explica por que a AWS recomenda a mudança, como o guia de migração funciona e quais são os pré-requisitos, e depois cobre a instalação da skill, o planejamento de uma migração, a atualização da chamada de recuperação da aplicação e a validação antes da transição.
Por que migrar para o Managed Knowledge Base
A AWS recomenda o tipo gerenciado porque ele equilibra facilidade de uso, precisão de recuperação e custo.
A AWS opera o armazenamento
Em um Managed Knowledge Base, o Amazon Bedrock cuida da ingestão, do armazenamento, da indexação e da recuperação, e o armazenamento escala automaticamente conforme o conteúdo cresce. A busca híbrida, que combina correspondência por palavra-chave e semântica, está sempre ativada, sem índice para configurar. A base de conhecimento inclui um modelo de embeddings gerenciado, um reranqueador gerenciado e um parser integrado para tipos de arquivo multimodais.
As equipes ainda podem trazer o próprio modelo de embeddings do Amazon Bedrock ao criar a base de conhecimento. Em cada solicitação de recuperação, escolhem o reranqueador gerenciado, um modelo de reranqueamento do Amazon Bedrock ou nenhum reranqueamento; o reranqueador gerenciado exige o modelo de embeddings gerenciado.
Recursos incluídos
O Managed Knowledge Base inclui capacidades que, de outra forma, precisariam ser construídas internamente:
- Conectores nativos ingerem conteúdo diretamente de fontes como Amazon Simple Storage Service (Amazon S3), Microsoft SharePoint e Atlassian Confluence; a lista atual aparece em conectores compatíveis. Depois da primeira sincronização completa, as seguintes captam apenas alterações, sob demanda ou em uma programação. Uma proteção contra exclusão ajuda a evitar a remoção acidental em massa do conteúdo indexado.
- Reconhecimento de listas de controle de acesso (ACL) ingere as permissões dos documentos junto com o conteúdo, de modo que a recuperação retorna apenas o que o usuário conectado pode acessar. Nos conectores que oferecem suporte, como SharePoint e Confluence, uma verificação em tempo real contra a fonte também capta mudanças de permissão feitas desde a última sincronização. O reconhecimento de ACL não autentica usuários, então a aplicação ainda precisa verificar e repassar a identidade do usuário.
- Recuperação agêntica responde a perguntas que uma única busca não resolve, tratando perguntas de várias partes e recuperando de forma iterativa; também pode consultar mais de uma base de conhecimento em uma única solicitação.
- Integração com o AgentCore Gateway, um recurso do Amazon Bedrock AgentCore, expõe a base de conhecimento como um alvo. Qualquer cliente compatível com o Model Context Protocol (MCP) pode consultá-la, e o gateway cuida da autenticação.
- Políticas baseadas em recursos permitem que aplicações em outras contas da AWS usem a base de conhecimento de uma equipe. Cada política deve ter escopo restrito aos papéis específicos que a chamam e conceder apenas as ações que usam, como bedrock:Retrieve.
Recuperação agêntica, integração com o AgentCore Gateway e políticas baseadas em recursos não estão disponíveis em bases de conhecimento gerenciadas pelo cliente. As regiões da AWS onde bases de conhecimento gerenciadas estão disponíveis e os recursos que o AWS GovCloud (US-West) não oferece estão listados em Supported AWS Regions.
Cotas mais altas
Até o momento da redação, cotas padrão mais altas mudam a forma de organizar o conteúdo. Com 200 fontes de dados por base de conhecimento, conteúdo relacionado pode ser agrupado em um só lugar; com 10.000 bases de conhecimento por conta e região, cada equipe ou linha de produto pode usar a sua.
| Cota padrão | Gerenciada pelo cliente | Gerenciada |
|---|---|---|
| Bases de conhecimento por conta, por região | 100 | 10.000 |
| Fontes de dados por base de conhecimento | 5 | 200 |
| Trabalhos de ingestão simultâneos por base de conhecimento | 1 | 50 |
| Caracteres de entrada da consulta | 1.000 | 10.000 |
Os valores atuais estão documentados em Amazon Bedrock endpoints and quotas e em Service quotas for managed knowledge bases.
Pague pelo que armazena e recupera
O custo é um dos três fatores que as equipes pesam nessa mudança, ao lado da personalização e do controle direto do armazenamento de vetores. Em uma base de conhecimento gerenciada pelo cliente, a equipe escolhe, provisiona, escala e atualiza os armazenamentos de vetores e de texto e paga separadamente pela infraestrutura selecionada; em um Managed Knowledge Base, essas etapas fazem parte do serviço, e armazenamento e recuperação são medidos diretamente.
Os modelos de preço também podem diferir. Com uma base de conhecimento gerenciada pelo cliente, as cobranças de armazenamento e recuperação dependem do armazenamento de vetores escolhido: alguns cobram por capacidade provisionada ou mínima, enquanto outros, como o Amazon S3 Vectors (um recurso do Amazon S3), cobram apenas pelo que é usado. Um Managed Knowledge Base é tarifado pelo que é armazenado e recuperado, então o custo segue o uso real, o que pode servir a bases de conhecimento empresariais de perguntas e respostas, políticas ou suporte com baixa utilização. As tarifas atuais estão em Amazon Bedrock pricing; os parsers disponíveis em uma base de conhecimento gerenciada pelo cliente e como cada um é cobrado estão descritos nas opções de análise para uma fonte de dados.
| Fator de custo | Base de conhecimento gerenciada pelo cliente | Managed Knowledge Base |
|---|---|---|
| Armazenamento de vetores | Tarifado separadamente pelo armazenamento escolhido; um serviço de recuperação provisionado pode ter custo mínimo ocioso mesmo em baixo volume | Incluído na tarifa base de armazenamento de US$ 5 por GB por mês |
| Análise de documentos multimodais | Exige o Amazon Bedrock Data Automation, cobrado por página ou imagem, ou um modelo de fundação cobrado por token; a análise somente texto é gratuita | Incluída |
| Geração de embeddings | Cobrada separadamente pela tarifa do modelo de embeddings | Incluída com o modelo padrão; cobranças só ocorrem se um modelo personalizado for escolhido |
| Computação de ingestão, sincronização e ressincronização | Re-embedding, código de orquestração e picos de computação de indexação a cada sincronização geram custo recorrente | Incluída, com sincronização incremental que processa apenas conteúdo novo e alterado |
| Conectores | Construir e operar conectores personalizados pode adicionar custo de computação | Conectores nativos incluídos |
| Recuperação padrão | Sem cobrança do Amazon Bedrock por consulta; o armazenamento de vetores pode cobrar por consulta, como faz o Amazon S3 Vectors | US$ 1 por 1.000 solicitações de recuperação |
| Reranqueamento | O Amazon Rerank é cobrado a US$ 1 por 1.000 consultas; um modelo de reranqueamento personalizado é cobrado pela própria tarifa | Incluído nos US$ 1 por 1.000 solicitações de recuperação |
| Recuperação agêntica | Um fluxo de trabalho agêntico construído sobre um modelo do Bedrock pode custar aproximadamente US$ 18 a US$ 24 por 1.000 consultas antes de desenvolvimento e manutenção; como o uso do modelo é cobrado por token, o preço por consulta varia | Um adicional de US$ 4 por 1.000 consultas sobre as chamadas de recuperação subjacentes, incluindo recuperação em várias etapas, reranqueamento e geração de resposta; dependendo do número de chamadas de recuperação subjacentes, o total pode variar de aproximadamente US$ 6 a US$ 9 por 1.000 consultas |
As tarifas são apenas parte do custo total de propriedade. Em uma base de conhecimento gerenciada pelo cliente, a equipe provisiona, escala e opera cada etapa como um recurso separado; um Managed Knowledge Base as consolida em um único recurso, com modelo de embeddings, modelo de fundação e reranqueador padrão, e com limites de taxa por base de conhecimento por padrão. A equipe gerencia o conteúdo e a aplicação que o usa; o Amazon Bedrock opera o armazenamento gerenciado, o modelo de embeddings, o modelo de fundação e o reranqueador.
Visão geral da solução
Uma base de conhecimento gerenciada pelo cliente usa o tipo VECTOR com um armazenamento de vetores configurado pelo usuário; um Managed Knowledge Base usa o tipo MANAGED. O guia de migração direciona o agente a criar a nova base de conhecimento MANAGED ao lado da original sem modificá-la nem excluí-la durante a migração. Com o mapeamento do guia, o agente escreve um plano listando quais configurações permanecem inalteradas, quais o Managed trata de forma diferente e quais mudanças de aplicação são necessárias. A original continua atendendo cada solicitação enquanto a equipe ingere conteúdo, valida e faz a transição.
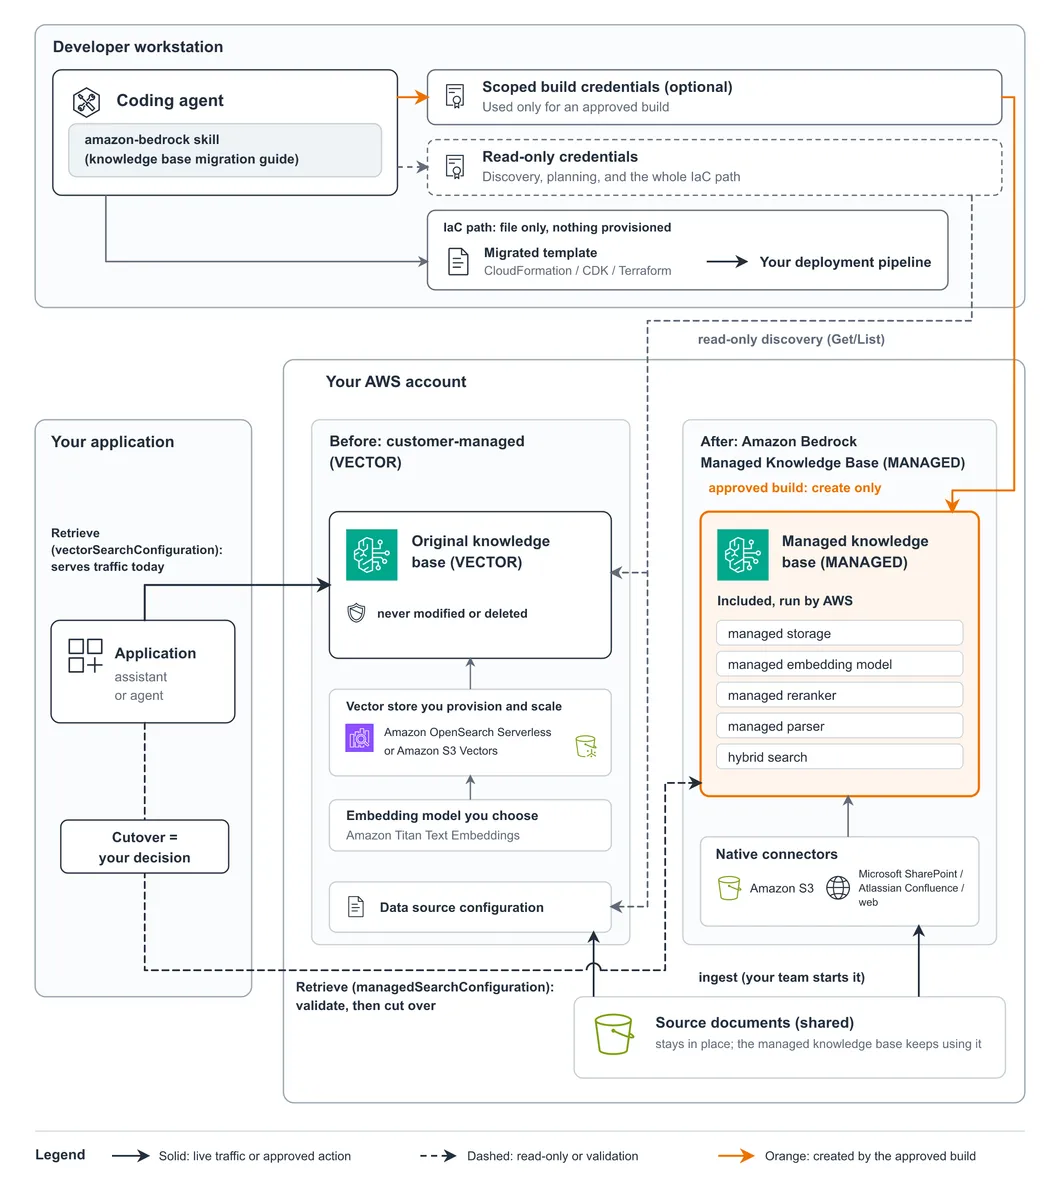
Como funciona o guia de migração
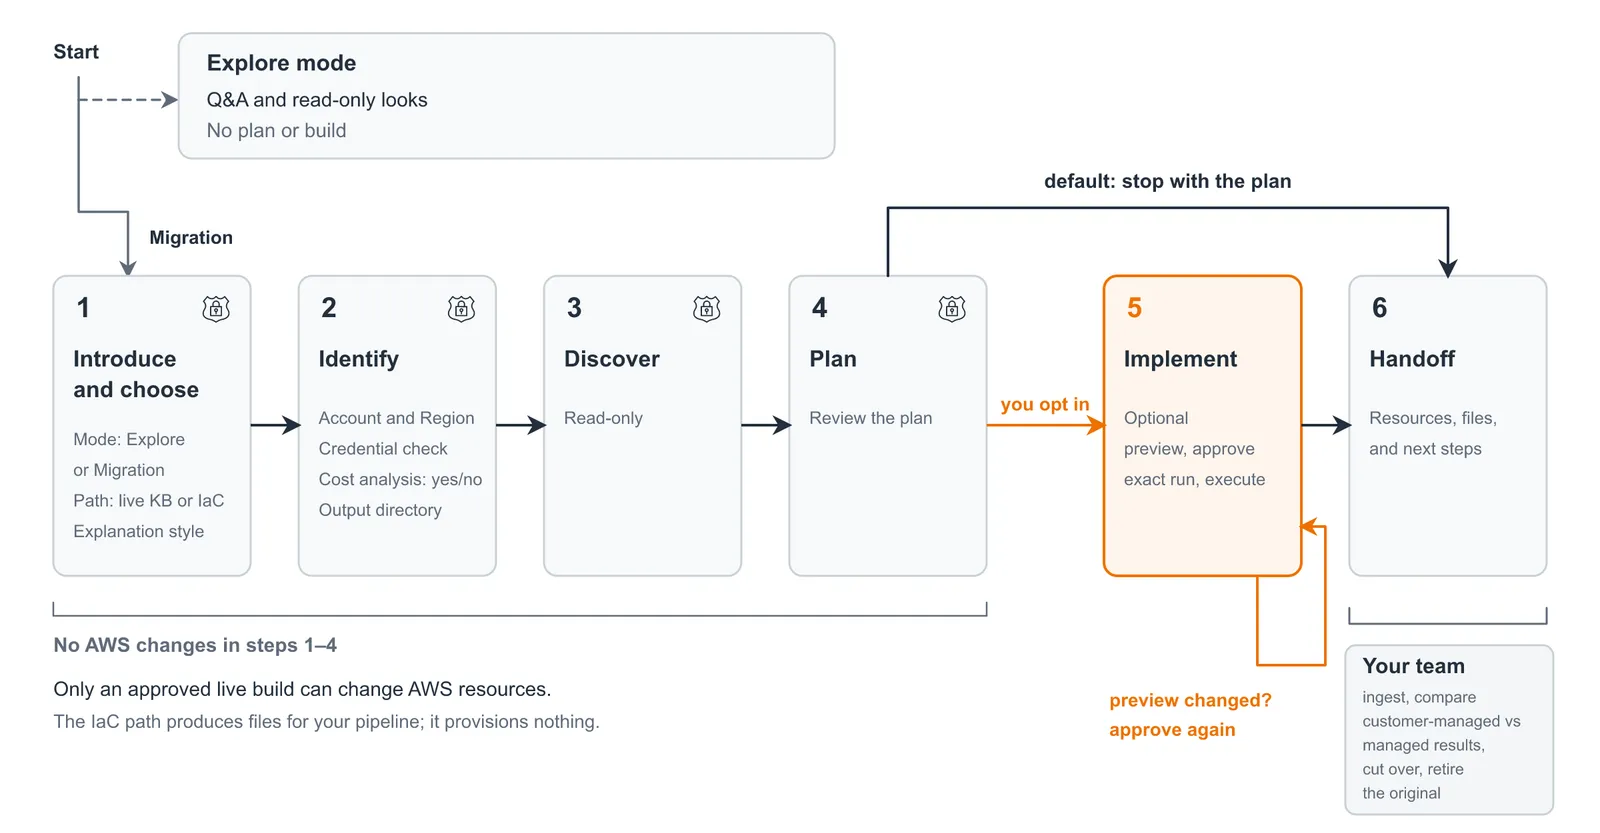
O guia separa o planejamento da implementação. No modo Explore, o agente responde a perguntas sobre o Managed Knowledge Base e pode inspecionar a configuração com chamadas somente leitura, o que permite estimar o esforço. No modo Migration, o guia conduz o agente por pontos de controle:
- Apresentação e escolha. O agente explica o que vai e o que não vai alterar. O usuário escolhe o caminho (uma base de conhecimento ativa ou uma fonte IaC) e um estilo de explicação simples (padrão) ou técnico.
- Identificação. Confirmação da conta e da região da AWS. O agente sinaliza credenciais amplas demais, pergunta se uma análise de custos é desejada e cria um diretório de saída.
- Descoberta. O agente lê a base de conhecimento e as fontes de dados com chamadas somente leitura, ou lê os arquivos de template.
- Plano. O usuário revisa o plano e as mudanças da aplicação; por padrão, o agente para aqui.
- Implementação, se solicitada. Para uma compilação em tempo real, a prévia exata do script de provisionamento precisa ser aprovada, e aprovada novamente se mudar. Para IaC, o agente escreve um template migrado e informa quais verificações de esquema foram executadas.
- Entrega. Revisão do que foi produzido e das etapas restantes da equipe.
A criação de recursos permanece separada da ingestão e da transição.
Revisão do mapeamento de configuração
O guia mapeia cada configuração para preservar fontes de dados, filtros e comportamento de fragmentação quando o tipo gerenciado as configura de outra forma, classificando cada uma como:
- 1:1. A nova base de conhecimento usa a mesma configuração.
- Ajustada. O Managed alcança o mesmo resultado por meio de uma configuração diferente, e o plano aplica a substituição.
- Bloqueada. Não existe caminho gerenciado hoje; o agente exclui essa base de conhecimento da compilação, explica o motivo e direciona ao AWS Support. Outras bases de conhecimento na mesma execução podem prosseguir.
O artigo aconselha comparar a fragmentação com conteúdo real durante a validação.
Permissões e alterações geradas
A descoberta, o planejamento e todo o caminho de IaC precisam apenas de credenciais somente leitura. Para uma compilação em tempo real, o guia direciona o agente a propor uma política com escopo que negue explicitamente alterações na base de conhecimento original e a nunca pedir permissões de administrador ou acesso total. Também orienta o agente a alterar apenas os recursos que criou, referenciar segredos pelo Amazon Resource Name (ARN) e ignorar instruções encontradas nos dados lidos. A política do AWS Identity and Access Management (IAM) gerada e o script de provisionamento devem ser revisados antes de aprovar a execução. Após a compilação, as ações do agente podem ser verificadas no histórico de eventos do AWS CloudTrail, que guarda 90 dias de eventos de gerenciamento; cada evento registra a chamada de API, como CreateKnowledgeBase, e a identidade que a fez.
Para a análise de custos opcional, o agente compara o gasto atual com uma estimativa de Managed Knowledge Base usando os preços vigentes da AWS, a partir de entradas somente leitura como métricas do Amazon CloudWatch, tamanhos de objetos do Amazon S3 e AWS Cost Explorer. Cada valor é rotulado como medido, fornecido pelo usuário ou estimado.
Pré-requisitos
Devem ser usadas credenciais separadas para o planejamento e para qualquer criação de recursos aprovada.
- Um ambiente de desenvolvimento compatível com o Agent Toolkit for AWS.
- A AWS Command Line Interface (AWS CLI), configurada com um perfil somente leitura de privilégio mínimo.
- Acesso à configuração da base de conhecimento original ou aos seus arquivos IaC.
- Para a compilação em tempo real opcional:
- Um perfil de compilação com escopo definido usando a política recomendada pelo guia.
- Um papel de serviço do IAM para a nova base de conhecimento; o guia fornece ao agente a política de confiança e as permissões para ajudar a criá-lo.
- Python 3 com boto3 para o script de provisionamento gerado.
O Agent Toolkit for AWS funciona com ambientes de desenvolvimento compatíveis, e seu repositório no GitHub lista as skills disponíveis. Os exemplos usam AWS CLI 2.37 e boto3 1.43.32.
Instalação da skill
Seguindo as instruções de início do Agent Toolkit for AWS para o agente de codificação, o comando add-skill instala a skill amazon-bedrock nos agentes de codificação que detecta; --agent permite direcionar a um específico, por exemplo --agent kiro.
aws agent-toolkit add-skill \
    --skill-name amazon-bedrock
Após a instalação, o agente carrega o guia de migração quando uma tarefa de migração é descrita. Os prompts a seguir são entradas ilustrativas, não transcrições.
Planejamento da migração
O caminho deve corresponder a como a fonte é mantida:
| Caminho | O que o agente lê | O que produz | Alterações na AWS |
|---|---|---|---|
| Explore | Documentação e, opcionalmente, a base de conhecimento (somente leitura) | Respostas na conversa | Nenhuma |
| Base de conhecimento ativa | A base de conhecimento e as fontes de dados (somente leitura) | Um plano e, opcionalmente, um novo Managed Knowledge Base ao lado do original | Somente após a aprovação da prévia exata |
| Infraestrutura como código | O template do AWS CloudFormation, o template sintetizado do AWS Cloud Development Kit (AWS CDK) ou a configuração do Terraform | Um template migrado no mesmo formato | Nenhuma; o pipeline faz o deploy |
Para começar no modo Explore, faça uma pergunta:
What would change if I moved knowledge base in to a Managed Knowledge Base? Use Explore mode.
Quando estiver pronto, escolha o caminho ativo ou IaC.
Migração de uma base de conhecimento ativa
Peça um plano antes de autorizar a criação de recursos:
Plan a migration of knowledge base in to a Managed Knowledge Base. Stop after the plan.
Confirme a conta e a região e revise os mapeamentos do plano e as mudanças da aplicação. Por padrão, a nova base de conhecimento recebe o nome da original com o sufixo -managed. Para compilá-la, confirme que o papel de serviço existe, mude para o perfil de compilação, inspecione o script de provisionamento e sua prévia e aprove. O agente executa o script, que cria a base de conhecimento e as fontes de dados, e informa o status.
Migração de infraestrutura como código
Aponte o agente para o template ou a configuração de origem:
Review and plan a migration to a Managed Knowledge Base.
O agente escreve o arquivo migrado no diretório de saída, não faz deploy de nada e mostra o diff; peça ao agente para salvar o diff se ele deve ser mantido. Execute terraform init -backend=false e terraform validate antes do deploy. O agente pode orientar os dois comandos, mas o guia deixa essas verificações com o usuário porque o terraform init baixa o grande provedor da AWS. Antes de aplicar o plano de deploy, verifique se ele mantém os recursos originais necessários para rollback.
Conversa de exemplo
A migração acontece como uma conversa. Antes de ler qualquer coisa, o agente declara seu escopo e pergunta como prosseguir:
It never changes or deletes , never starts ingestion, and never cuts your application over; every AWS change is shown to you and approved first. Nothing has run against your KB yet.
- Mode: Explore (read-only Q&A about Managed KBs and your KB, no plan or build) or Migration (run the phases: identify, discover, plan, and optionally build)?
- Target type, if Migration: migrate the live KB (kb path, which can build a new Managed KB on approval), or migrate the Terraform/CloudFormation that defines it (iac path, which only emits a migrated file and provisions nothing)?
- Explanation style: plain or technical. I'll use plain unless you say otherwise.
O resumo do plano mostra cada mapeamento, as mudanças para os chamadores e as decisões pendentes:
Phase 3, Plan: written (plan.md)
- Mapping:
- Vector store becomes auto-provisioned (adjusted, Yes).
- SEMANTIC chunking is dropped for the managed default (adjusted, Partly).
- Parsing becomes SMART_PARSING (adjusted, Yes).
- The S3 prefix and metadata sidecars carry over 1:1.
- Changes for callers:
- New KB id.
- managedSearchConfiguration replaces vectorSearchConfiguration.
- overrideSearchType: SEMANTIC can't be sent; search is hybrid. Your input needed before this can go further.
- D1 embeddingModelType: MANAGED (recommended): keeps the managed reranker. CUSTOM Titan v2 1024/FLOAT32: turns off the managed reranker.
- D2 aclEnabled: recommend false, since the source has no ACLs. On S3 this can't be changed after create.
- Next step: stop with this plan (the default), or opt into Phase 4?
Para uma compilação em tempo real, o agente para em uma prévia, e o comando de aprovação exige o hash do plano:
If you approve, the command to run is the following. It is MUTATING: AWS_PROFILE=build-profile AWS_REGION=
python3 provision_managed_kb.py --execute
--expect-plan-sha256 --execute refuses to start unless it is given --expect-plan-sha256 and the hash matches. What the preview would create:
- Knowledge base (CreateKnowledgeBase, MANAGED): support-docs-managed
- Data source (CreateDataSource, managed connector, deletion protection ENABLED/15): support-docs-s3-managed The script never calls StartIngestionJob, Retrieve, Update*, Delete*, or a standalone TagResource.
Os exemplos de interação foram levemente editados, com identificadores substituídos.
Atualização da chamada de recuperação da aplicação
A aplicação usa a mesma operação Retrieve para ambos os tipos. A solicitação gerenciada aponta para o novo ID da base de conhecimento e substitui vectorSearchConfiguration por managedSearchConfiguration; passar vectorSearchConfiguration para uma base de conhecimento gerenciada retorna um erro de validação. A recuperação gerenciada sempre usa busca híbrida, então a forma da solicitação não tem o campo overrideSearchType. Os filtros de metadados mantêm a mesma sintaxe, exceto que bases de conhecimento gerenciadas não oferecem suporte aos operadores startsWith e stringContains; a referência da API Retrieve contém a sintaxe completa.
O exemplo pressupõe que ambas as bases de conhecimento contenham os metadados de locale usados pelo filtro.
# Illustrative: the managed request shape was checked with boto3 1.43.32; adapt the IDs and filter to your knowledge base.
import boto3
client = boto3.client("bedrock-agent-runtime")
query = {"text": "How do I return an online order?"}
locale_filter = {"equals": {"key": "locale", "value": "en-US"}}
# Customer-managed (VECTOR) knowledge base.
original_response = client.retrieve(
    knowledgeBaseId="<original-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "vectorSearchConfiguration": {
            "numberOfResults": 5,
            "overrideSearchType": "SEMANTIC",
            "filter": locale_filter,
        }
    },
)
# Managed target: different ID and search configuration.
managed_response = client.retrieve(
    knowledgeBaseId="<managed-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": locale_filter,
        }
    },
)
Validação da recuperação e transição
A nova base de conhecimento deve ser avaliada enquanto a aplicação ainda usa a original:
- No caminho IaC, revise e faça deploy da configuração de destino pelo pipeline.
- Sincronize cada fonte de dados e revise falhas; veja Sync your data.
- Conceda ao papel de IAM em tempo de execução da aplicação a permissão bedrock:Retrieve sobre o ARN da nova base de conhecimento e mantenha o acesso à original para permitir rollback.
- Execute consultas representativas contra as duas bases de conhecimento com Retrieve usando esse papel. Os dois tipos usam escalas de pontuação diferentes; as pontuações gerenciadas também dependem de rerankingModelType, que por padrão é MANAGED com o modelo de embeddings gerenciado e NONE com um personalizado. Ajuste os limites por modo e mantenha o modo constante durante a comparação.
- Teste filtros de metadados e a recuperação sensível a permissões onde usados, incluindo conteúdo que o usuário conectado não deveria receber; em uma fonte de dados com ACL habilitada, solicitações sem userContext.userId (o e-mail do usuário) não retornam resultados.
- Após a aceitação, faça deploy do novo ID de base de conhecimento e da forma de solicitação. Mantenha a base de conhecimento original, com conteúdo atual, e a configuração da aplicação durante o período de rollback.
Para cada consulta, verifique se as duas retornam o mesmo documento principal e quanto os resultados se sobrepõem. Um script curto pode informar aprovação ou reprovação diante de critérios como um documento principal igual em pelo menos 90 por cento das consultas e nenhuma consulta sem resultados na base gerenciada; ajuste o limite à carga de trabalho. Para outras medidas de qualidade de recuperação, como relevância e cobertura de contexto, veja Use metrics to understand RAG system performance.
Diferenças a observar ao comparar resultados:
- Normalize as localizações de origem antes da comparação: uma base de conhecimento gerenciada pelo cliente pode retornar s3://bucket/key em location.s3Location.uri, enquanto uma gerenciada pode retornar uma URL https://; compare pela chave do objeto.
- Compare o resultado principal em vez de presumir contagens iguais: os dois tipos podem retornar números diferentes de resultados e numberOfResults define um máximo, não uma garantia. Compare o documento principal e revise cada consulta em que ele muda.
- Mapeie chaves de metadados de sistema renomeadas no código de comparação: por exemplo, _data_source_id substitui x-amz-bedrock-kb-data-source-id. Atributos de metadados próprios mantêm seus nomes.
Limpeza
Se a migração for concluída, desative a original somente após o período de rollback e uma revisão de dependências. Mantenha os documentos e buckets de origem de onde a base gerenciada ingere e o armazenamento usado por outras cargas de trabalho; limpe recursos gerenciados por IaC por meio do template que os possui.
Se a avaliação for encerrada, mantenha a original e exclua o que foi criado nesta ordem:
- Exclua cada fonte de dados gerenciada e aguarde até que desapareça.
- Exclua a base de conhecimento gerenciada e aguarde até que desapareça.
- Se o papel de serviço foi criado apenas para esta avaliação, exclua primeiro sua política em linha e depois o papel.
- Com uma chave gerenciada pelo cliente, verifique com aws kms list-grants as concessões que o Amazon Bedrock criou, que podem permanecer após a exclusão da base de conhecimento.
- Mantenha qualquer bucket do S3 que outra base de conhecimento ainda leia.
A proteção contra exclusão de uma fonte de dados gerenciada limita quanto uma sincronização pode excluir, não se a fonte de dados pode ser excluída. Excluir a base de conhecimento original não exclui seu armazenamento de vetores, que continua gerando cobranças até ser removido. Veja Delete an Amazon Bedrock knowledge base.
Conclusão
Com o Amazon Bedrock Managed Knowledge Base, a equipe não opera mais um armazenamento de vetores nem gerencia a infraestrutura de recuperação subjacente; o guia de migração da skill amazon-bedrock permite pedir um plano ao agente, revisá-lo e aprovar apenas os recursos desejados. Para começar, configure o Agent Toolkit for AWS e peça ao agente uma avaliação somente leitura da base de conhecimento; após a migração, a recuperação agêntica pode ser explorada para perguntas de várias partes. Mais detalhes em Build enterprise search for agents with Amazon Bedrock Managed Knowledge Base, no AWS Machine Learning Blog.