Operar una base de conocimiento autoadministrada en Amazon Bedrock implica aprovisionar y escalar el almacén de vectores, elegir y ajustar un modelo de incrustaciones, configurar el índice y planificar la capacidad cada vez que se agrega una nueva fuente de datos. AWS recomienda trasladar estas cargas de trabajo a Amazon Bedrock Managed Knowledge Base, que asume ese trabajo operativo y añade capacidades de recuperación, mientras el equipo conserva el control del contenido y de la aplicación que lo utiliza. Para respaldar el cambio, AWS incorporó una guía de migración de bases de conocimiento a la habilidad amazon-bedrock del Agent Toolkit for AWS, de modo que un agente de programación pueda ayudar a planificarla y ejecutarla.
Migrar una base de conocimiento en producción implica mapear la configuración actual, crear el reemplazo, ingerir el contenido, actualizar la llamada de recuperación de la aplicación y validar la recuperación antes de conmutar el tráfico. La guía proporciona al agente el contexto necesario para planificar la migración junto con el usuario: comienza con un descubrimiento de solo lectura y un plan que se revisa línea por línea. Solo tras la aprobación explícita, el agente crea la nueva base de conocimiento y sus fuentes de datos junto a la original, o escribe una plantilla de infraestructura como código (IaC) migrada para el pipeline del equipo. La ingesta y la actualización de las llamadas Retrieve de la aplicación quedan a cargo del equipo, aunque el agente puede guiar ambas tareas.
El artículo explica por qué AWS recomienda el cambio, cómo funciona la guía de migración y cuáles son los requisitos previos, y luego cubre la instalación de la habilidad, la planificación de una migración, la actualización de la llamada de recuperación de la aplicación y la validación antes de la conmutación.
Por qué pasar a Managed Knowledge Base
AWS recomienda el tipo administrado porque equilibra facilidad de uso, precisión de recuperación y costo.
AWS opera el almacén
En una Managed Knowledge Base, Amazon Bedrock se encarga de la ingesta, el almacenamiento, la indexación y la recuperación, y el almacén escala automáticamente a medida que crece el contenido. La búsqueda híbrida, que combina coincidencia por palabra clave y semántica, está siempre activada, sin ningún índice que configurar. La base de conocimiento incluye un modelo de incrustaciones administrado, un reclasificador administrado y un analizador integrado para tipos de archivo multimodales.
Los equipos aún pueden traer su propio modelo de incrustaciones de Amazon Bedrock al crear la base de conocimiento. En cada solicitud de recuperación eligen el reclasificador administrado, un modelo de reclasificación de Amazon Bedrock o ninguna reclasificación; el reclasificador administrado requiere el modelo de incrustaciones administrado.
Capacidades integradas
Managed Knowledge Base incluye funciones que de otro modo habría que construir internamente:
- Conectores nativos que ingieren contenido directamente desde fuentes como Amazon Simple Storage Service (Amazon S3), Microsoft SharePoint y Atlassian Confluence; la lista actual figura en los conectores compatibles. Después de la primera sincronización completa, las siguientes solo recogen cambios, a pedido o según una programación. Una protección contra eliminaciones ayuda a evitar la eliminación accidental masiva del contenido indexado.
- Conocimiento de listas de control de acceso (ACL) que ingiere los permisos de los documentos junto con el contenido, de modo que la recuperación solo devuelve lo que el usuario autenticado puede ver. En los conectores que lo admiten, como SharePoint y Confluence, una comprobación en tiempo real contra la fuente también detecta los cambios de permisos posteriores a la última sincronización. El conocimiento de ACL no autentica a los usuarios, por lo que la aplicación debe seguir verificando y transmitiendo la identidad del usuario.
- Recuperación agéntica que responde preguntas que una sola búsqueda no puede resolver, manejando preguntas de varias partes y recuperando de forma iterativa; además puede consultar más de una base de conocimiento en una misma solicitud.
- Integración con AgentCore Gateway, una capacidad de Amazon Bedrock AgentCore, que expone la base de conocimiento como un destino. Cualquier cliente compatible con el Model Context Protocol (MCP) puede consultarla, y el gateway se encarga de la autenticación.
- Políticas basadas en recursos que permiten que aplicaciones de otras cuentas de AWS usen la base de conocimiento de un equipo. Cada política debe limitarse a los roles específicos que la invocan y conceder solo las acciones que usan, como bedrock:Retrieve.
La recuperación agéntica, la integración con AgentCore Gateway y las políticas basadas en recursos no están disponibles en las bases de conocimiento administradas por el cliente. Las regiones de AWS donde están disponibles las bases de conocimiento administradas, y las funciones que AWS GovCloud (US-West) no admite, se enumeran en Supported AWS Regions.
Cuotas más altas
Al momento de redactar este artículo, cuotas predeterminadas más altas cambian la forma de organizar el contenido. Con 200 fuentes de datos por base de conocimiento, el contenido relacionado puede agruparse en un solo lugar; con 10.000 bases de conocimiento por cuenta y región, cada equipo o línea de producto puede usar la suya.
| Cuota predeterminada | Administrada por el cliente | Administrada |
|---|---|---|
| Bases de conocimiento por cuenta, por región | 100 | 10.000 |
| Fuentes de datos por base de conocimiento | 5 | 200 |
| Trabajos de ingesta simultáneos por base de conocimiento | 1 | 50 |
| Caracteres de entrada de consulta | 1.000 | 10.000 |
Los valores actuales están documentados en Amazon Bedrock endpoints and quotas y en Service quotas for managed knowledge bases.
Pago por lo almacenado y recuperado
El costo es uno de los tres factores que los equipos sopesan en este cambio, junto con la personalización y el control directo del almacén de vectores. En una base de conocimiento administrada por el cliente, el equipo elige, aprovisiona, escala y actualiza los almacenes de vectores y de texto y paga por separado la infraestructura seleccionada; en una Managed Knowledge Base esas etapas forman parte del servicio, y el almacenamiento y la recuperación se miden directamente.
Los modelos de precios también pueden diferir. Con una base de conocimiento administrada por el cliente, los cargos de almacenamiento y recuperación dependen del almacén de vectores elegido: algunos cobran por capacidad aprovisionada o mínima, mientras que otros, como Amazon S3 Vectors (una capacidad de Amazon S3), cobran solo por lo que se usa. Una Managed Knowledge Base se tarifa por lo almacenado y recuperado, de modo que el costo sigue el uso real, lo que puede convenir a bases de conocimiento empresariales de preguntas y respuestas, políticas o soporte con baja utilización. Las tarifas vigentes figuran en Amazon Bedrock pricing; los analizadores disponibles en una base de conocimiento administrada por el cliente y cómo se factura cada uno se describen en las opciones de análisis para una fuente de datos.
| Factor de costo | Base de conocimiento administrada por el cliente | Managed Knowledge Base |
|---|---|---|
| Almacenamiento de vectores | Se tarifa por separado según el almacén elegido; un servicio de recuperación aprovisionado puede tener un costo mínimo en reposo incluso con bajo volumen | Incluido en la tarifa base de almacenamiento de 5 USD por GB al mes |
| Análisis de documentos multimodales | Requiere Amazon Bedrock Data Automation, facturado por página o imagen, o un modelo de fundación facturado por token; el análisis de solo texto es gratuito | Incluido |
| Generación de incrustaciones | Facturada por separado según la tarifa del modelo de incrustaciones | Incluida con el modelo predeterminado; solo se cobra si se elige un modelo personalizado |
| Cómputo de ingesta, sincronización y resincronización | La re-incrustación, el código de orquestación y los picos de cómputo de indexación en cada sincronización añaden costo recurrente | Incluido, con sincronización incremental que procesa solo contenido nuevo y modificado |
| Conectores | Construir y operar conectores personalizados puede añadir costo de cómputo | Los conectores nativos están incluidos |
| Recuperación estándar | Sin cargo de Amazon Bedrock por consulta; el almacén de vectores puede cobrar por consulta, como hace Amazon S3 Vectors | 1 USD por 1.000 solicitudes de recuperación |
| Reclasificación | Amazon Rerank se cobra a 1 USD por 1.000 consultas; un modelo de reclasificación personalizado se factura a su propia tarifa | Incluida en el cargo de 1 USD por 1.000 solicitudes de recuperación |
| Recuperación agéntica | Un flujo de trabajo agéntico construido sobre un modelo de Bedrock puede costar aproximadamente de 18 a 24 USD por 1.000 consultas antes de desarrollo y mantenimiento; como el uso del modelo se factura por token, el precio por consulta varía | Un cargo adicional de 4 USD por 1.000 consultas sobre las llamadas de recuperación subyacentes, que incluye recuperación de múltiples pasos, reclasificación y generación de respuestas; según el número de llamadas de recuperación subyacentes, el total puede ir de aproximadamente 6 a 9 USD por 1.000 consultas |
Las tarifas son solo una parte del costo total de propiedad. En una base de conocimiento administrada por el cliente, el equipo aprovisiona, escala y opera cada etapa como un recurso separado; una Managed Knowledge Base las consolida en un solo recurso, con un modelo de incrustaciones, un modelo de fundación y un reclasificador predeterminados, y con límites de tasa por base de conocimiento de forma predeterminada. El equipo administra el contenido y la aplicación que lo usa; Amazon Bedrock opera el almacenamiento administrado, el modelo de incrustaciones, el modelo de fundación y el reclasificador.
Descripción general de la solución
Una base de conocimiento administrada por el cliente usa el tipo VECTOR con un almacén de vectores configurado por el usuario; una Managed Knowledge Base usa el tipo MANAGED. La guía de migración indica al agente que cree la nueva base de conocimiento MANAGED junto a la original sin modificarla ni eliminarla durante la migración. Con el mapeo de la guía, el agente redacta un plan que enumera qué configuraciones permanecen sin cambios, cuáles Managed maneja de forma distinta y qué cambios de aplicación se necesitan. La original sigue atendiendo cada solicitud mientras el equipo ingiere contenido, valida y conmuta.
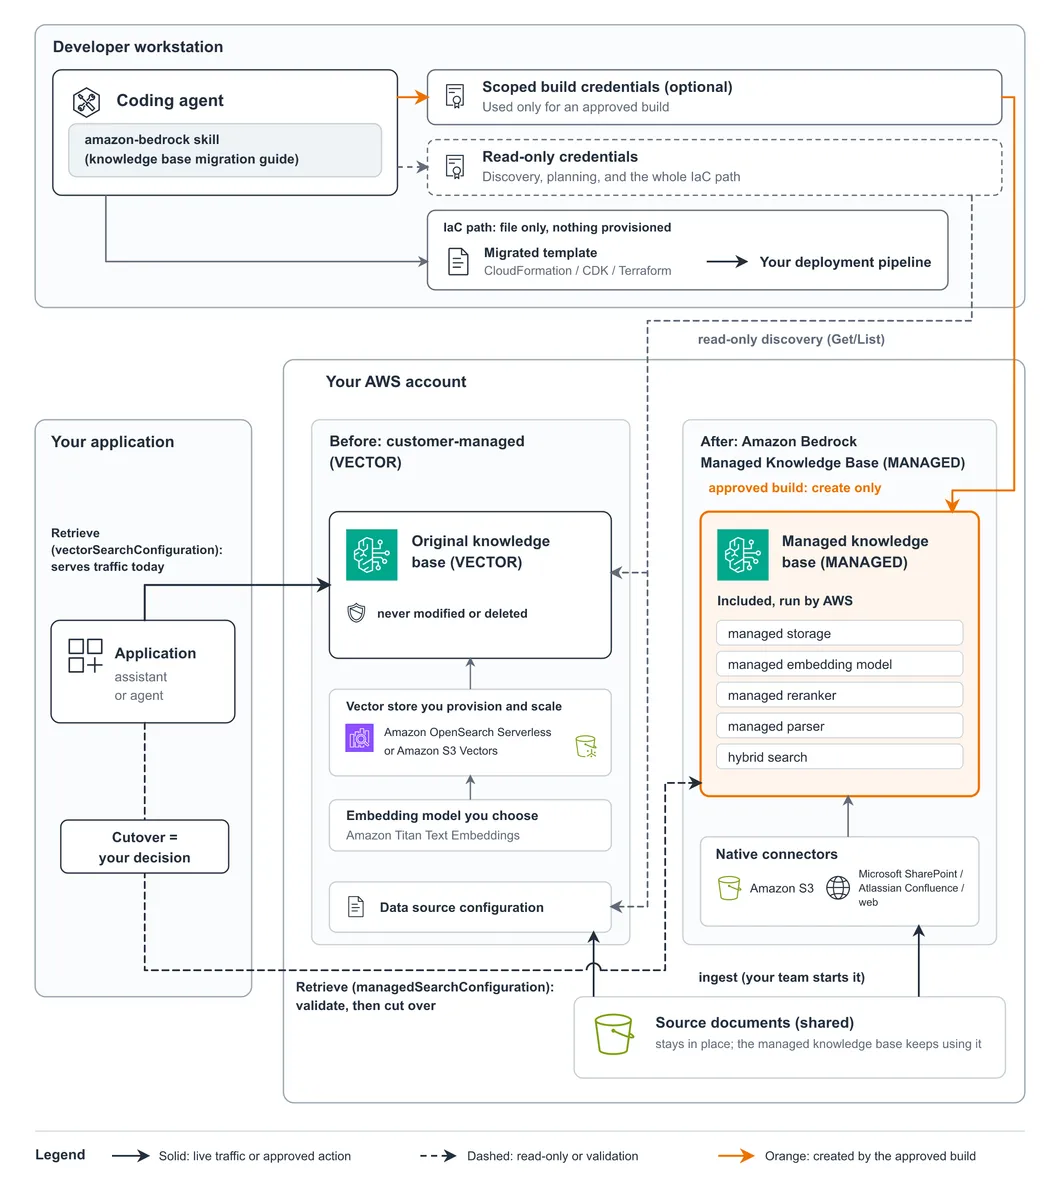
Cómo funciona la guía de migración
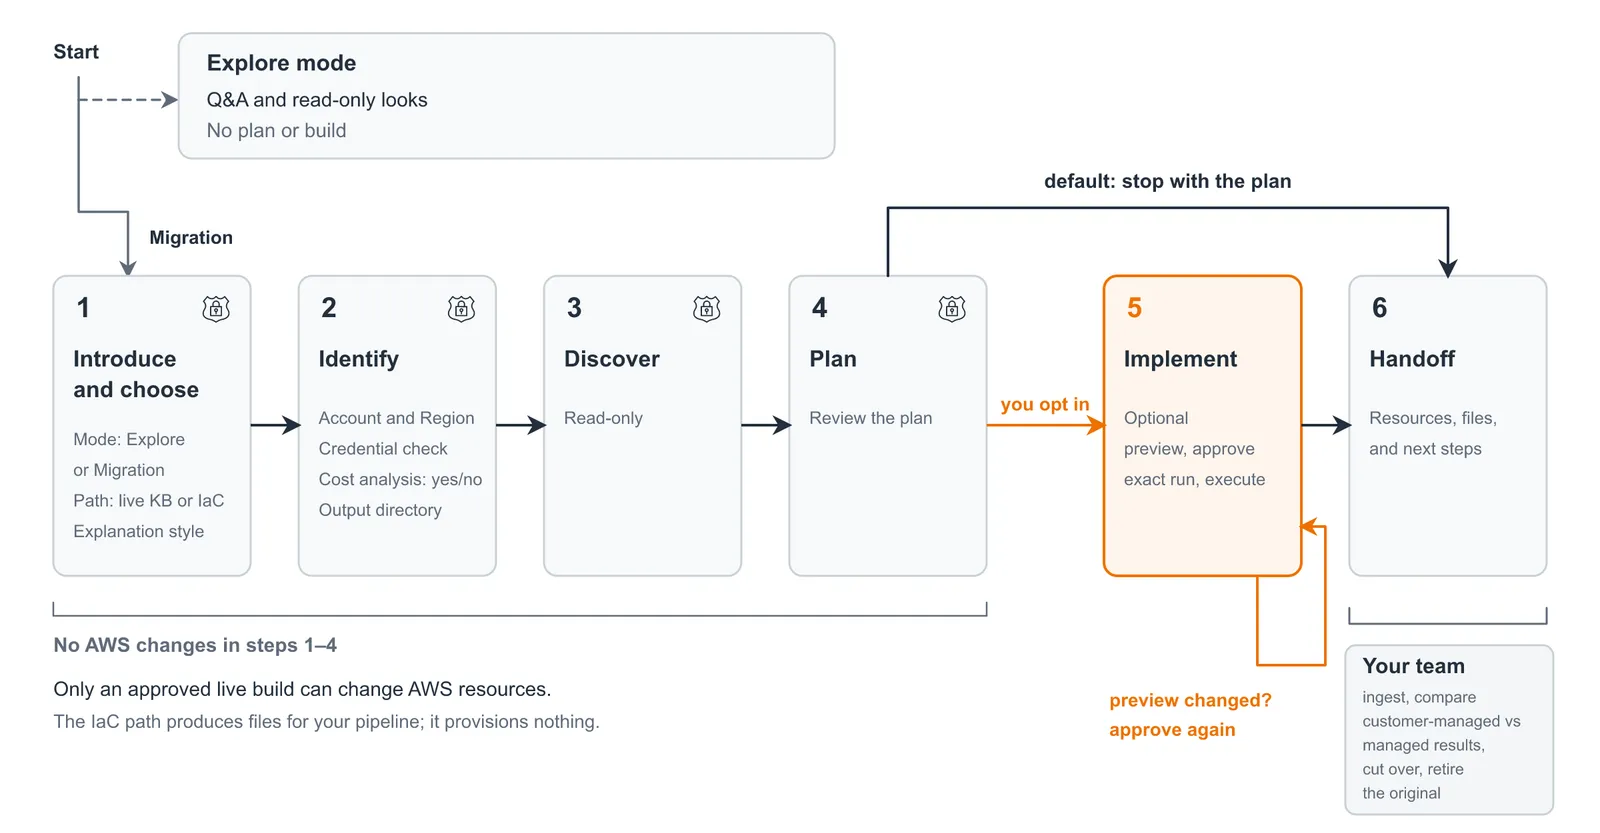
La guía separa la planificación de la implementación. En el modo Explore, el agente responde preguntas sobre Managed Knowledge Base y puede inspeccionar la configuración con llamadas de solo lectura, lo que permite estimar el esfuerzo. En el modo Migration, la guía lleva al agente por puntos de control:
- Presentación y elección. El agente explica qué tocará y qué no. El usuario elige la ruta (una base de conocimiento activa o una fuente IaC) y un estilo de explicación sencillo (predeterminado) o técnico.
- Identificación. Se confirman la cuenta y la región de AWS. El agente señala credenciales demasiado amplias, pregunta si se desea un análisis de costos y crea un directorio de salida.
- Descubrimiento. El agente lee la base de conocimiento y las fuentes de datos con llamadas de solo lectura, o lee los archivos de plantilla.
- Plan. El usuario revisa el plan y los cambios de la aplicación; de forma predeterminada, el agente se detiene aquí.
- Implementación, si se solicita. Para una compilación en vivo hay que aprobar la vista previa exacta del script de aprovisionamiento, y aprobarla de nuevo si cambia. Para IaC, el agente escribe una plantilla migrada e informa qué comprobaciones de esquema ejecutó.
- Entrega. Revisión de lo producido y de los pasos restantes del equipo.
La creación de recursos se mantiene separada de la ingesta y la conmutación.
Revisión del mapeo de configuración
La guía mapea cada configuración para preservar las fuentes de datos, los filtros y el comportamiento de fragmentación cuando el tipo administrado las configura de otro modo, y clasifica cada una como:
- 1:1. La nueva base de conocimiento usa la misma configuración.
- Ajustada. Managed logra el mismo resultado mediante una configuración distinta, y el plan aplica la sustitución.
- Bloqueada. Hoy no existe una ruta administrada; el agente excluye esa base de conocimiento de la compilación, explica por qué y remite a AWS Support. Las demás bases de conocimiento de la misma ejecución pueden continuar.
El artículo aconseja comparar la fragmentación con contenido real durante la validación.
Permisos y cambios generados
El descubrimiento, la planificación y toda la ruta de IaC solo necesitan credenciales de solo lectura. Para una compilación en vivo, la guía indica al agente que proponga una política delimitada que niegue explícitamente cambios en la base de conocimiento original y que nunca pida permisos de administrador ni de acceso total. También le indica que modifique solo los recursos que creó, que referencie los secretos por su Amazon Resource Name (ARN) y que ignore las instrucciones que encuentre en los datos que lee. La política de AWS Identity and Access Management (IAM) generada y el script de aprovisionamiento deben revisarse antes de aprobar la ejecución. Después de la compilación, las acciones del agente pueden comprobarse en el historial de eventos de AWS CloudTrail, que conserva 90 días de eventos de administración; cada evento registra la llamada a la API, como CreateKnowledgeBase, y la identidad que la realizó.
Para el análisis de costos opcional, el agente compara el gasto actual con una estimación de Managed Knowledge Base usando los precios vigentes de AWS, a partir de entradas de solo lectura como métricas de Amazon CloudWatch, tamaños de objetos de Amazon S3 y AWS Cost Explorer. Cada cifra se etiqueta como medida, proporcionada por el usuario o estimada.
Requisitos previos
Deben usarse credenciales separadas para la planificación y para cualquier creación de recursos aprobada.
- Un entorno de desarrollo compatible con el Agent Toolkit for AWS.
- La AWS Command Line Interface (AWS CLI), configurada con un perfil de solo lectura y privilegios mínimos.
- Acceso a la configuración de la base de conocimiento original o a sus archivos IaC.
- Para la compilación en vivo opcional:
- Un perfil de compilación delimitado que use la política recomendada por la guía.
- Un rol de servicio de IAM para la nueva base de conocimiento; la guía proporciona al agente la política de confianza y los permisos para ayudar a crearlo.
- Python 3 con boto3 para el script de aprovisionamiento generado.
El Agent Toolkit for AWS funciona con entornos de desarrollo compatibles, y su repositorio en GitHub enumera las habilidades disponibles. Los ejemplos usan AWS CLI 2.37 y boto3 1.43.32.
Instalación de la habilidad
Siguiendo las instrucciones de inicio del Agent Toolkit for AWS para el agente de programación, el comando add-skill instala la habilidad amazon-bedrock en los agentes de programación que detecta; --agent permite apuntar a uno concreto, por ejemplo --agent kiro.
aws agent-toolkit add-skill \
    --skill-name amazon-bedrock
Tras la instalación, el agente carga la guía de migración cuando se describe una tarea de migración. Los siguientes prompts son entradas ilustrativas, no transcripciones.
Planificación de la migración
La ruta debe corresponder a cómo se mantiene la fuente:
| Ruta | Qué lee el agente | Qué produce | Cambios en AWS |
|---|---|---|---|
| Explore | Documentación y, opcionalmente, la base de conocimiento (solo lectura) | Respuestas en la conversación | Ninguno |
| Base de conocimiento activa | La base de conocimiento y las fuentes de datos (solo lectura) | Un plan y, opcionalmente, una nueva Managed Knowledge Base junto a la original | Solo después de aprobar la vista previa exacta |
| Infraestructura como código | La plantilla de AWS CloudFormation, la plantilla sintetizada de AWS Cloud Development Kit (AWS CDK) o la configuración de Terraform | Una plantilla migrada en el mismo formato | Ninguno; el pipeline la despliega |
Para empezar en modo Explore, se plantea una pregunta:
What would change if I moved knowledge base in to a Managed Knowledge Base? Use Explore mode.
Cuando esté listo, se elige la ruta en vivo o IaC.
Migración de una base de conocimiento activa
Se pide un plan antes de autorizar la creación de recursos:
Plan a migration of knowledge base in to a Managed Knowledge Base. Stop after the plan.
Se confirman la cuenta y la región y luego se revisan los mapeos del plan y los cambios de la aplicación. De forma predeterminada, la nueva base de conocimiento toma el nombre de la original con el sufijo -managed. Para compilarla, se confirma que el rol de servicio existe, se cambia al perfil de compilación, se inspecciona el script de aprovisionamiento y su vista previa y se aprueba. El agente ejecuta el script, que crea la base de conocimiento y las fuentes de datos, e informa su estado.
Migración de infraestructura como código
Se apunta al agente a la plantilla o configuración de origen:
Review and plan a migration to a Managed Knowledge Base.
El agente escribe el archivo migrado en el directorio de salida, no despliega nada y muestra el diff; si se quiere conservar el diff, hay que pedírselo. Antes del despliegue se ejecutan terraform init -backend=false y terraform validate. El agente puede guiar ambos comandos, pero la guía deja estas comprobaciones al usuario porque terraform init descarga el voluminoso proveedor de AWS. Antes de aplicar el plan de despliegue, hay que comprobar que conserva los recursos originales necesarios para la reversión.
Conversación de ejemplo
La migración se desarrolla como una conversación. Antes de leer nada, el agente declara su alcance y pregunta cómo proceder:
It never changes or deletes , never starts ingestion, and never cuts your application over; every AWS change is shown to you and approved first. Nothing has run against your KB yet.
- Mode: Explore (read-only Q&A about Managed KBs and your KB, no plan or build) or Migration (run the phases: identify, discover, plan, and optionally build)?
- Target type, if Migration: migrate the live KB (kb path, which can build a new Managed KB on approval), or migrate the Terraform/CloudFormation that defines it (iac path, which only emits a migrated file and provisions nothing)?
- Explanation style: plain or technical. I'll use plain unless you say otherwise.
El resumen del plan muestra cada mapeo, los cambios para los invocadores y las decisiones pendientes:
Phase 3, Plan: written (plan.md)
- Mapping:
- Vector store becomes auto-provisioned (adjusted, Yes).
- SEMANTIC chunking is dropped for the managed default (adjusted, Partly).
- Parsing becomes SMART_PARSING (adjusted, Yes).
- The S3 prefix and metadata sidecars carry over 1:1.
- Changes for callers:
- New KB id.
- managedSearchConfiguration replaces vectorSearchConfiguration.
- overrideSearchType: SEMANTIC can't be sent; search is hybrid. Your input needed before this can go further.
- D1 embeddingModelType: MANAGED (recommended): keeps the managed reranker. CUSTOM Titan v2 1024/FLOAT32: turns off the managed reranker.
- D2 aclEnabled: recommend false, since the source has no ACLs. On S3 this can't be changed after create.
- Next step: stop with this plan (the default), or opt into Phase 4?
Para una compilación en vivo, el agente se detiene en una vista previa y el comando de aprobación requiere el hash del plan:
If you approve, the command to run is the following. It is MUTATING: AWS_PROFILE=build-profile AWS_REGION=
python3 provision_managed_kb.py --execute
--expect-plan-sha256 --execute refuses to start unless it is given --expect-plan-sha256 and the hash matches. What the preview would create:
- Knowledge base (CreateKnowledgeBase, MANAGED): support-docs-managed
- Data source (CreateDataSource, managed connector, deletion protection ENABLED/15): support-docs-s3-managed The script never calls StartIngestionJob, Retrieve, Update*, Delete*, or a standalone TagResource.
Los intercambios de ejemplo fueron ligeramente editados y los identificadores reemplazados.
Actualización de la llamada de recuperación de la aplicación
La aplicación usa la misma operación Retrieve para ambos tipos. La solicitud administrada apunta al nuevo ID de base de conocimiento y reemplaza vectorSearchConfiguration por managedSearchConfiguration; pasar vectorSearchConfiguration a una base de conocimiento administrada devuelve un error de validación. La recuperación administrada siempre usa búsqueda híbrida, por lo que la forma de la solicitud no tiene el campo overrideSearchType. Los filtros de metadatos conservan la misma sintaxis, salvo que las bases de conocimiento administradas no admiten los operadores startsWith y stringContains; la referencia de la API Retrieve contiene la sintaxis completa.
El ejemplo supone que ambas bases de conocimiento contienen los metadatos de locale usados por el filtro.
# Illustrative: the managed request shape was checked with boto3 1.43.32; adapt the IDs and filter to your knowledge base.
import boto3
client = boto3.client("bedrock-agent-runtime")
query = {"text": "How do I return an online order?"}
locale_filter = {"equals": {"key": "locale", "value": "en-US"}}
# Customer-managed (VECTOR) knowledge base.
original_response = client.retrieve(
    knowledgeBaseId="<original-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "vectorSearchConfiguration": {
            "numberOfResults": 5,
            "overrideSearchType": "SEMANTIC",
            "filter": locale_filter,
        }
    },
)
# Managed target: different ID and search configuration.
managed_response = client.retrieve(
    knowledgeBaseId="<managed-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": locale_filter,
        }
    },
)
Validación de la recuperación y conmutación
La nueva base de conocimiento debe evaluarse mientras la aplicación sigue usando la original:
- En la ruta IaC, revisar y desplegar la configuración de destino a través del pipeline.
- Sincronizar cada fuente de datos y revisar los fallos; véase Sync your data.
- Conceder al rol de IAM en tiempo de ejecución de la aplicación el permiso bedrock:Retrieve sobre el ARN de la nueva base de conocimiento y mantener su acceso a la original para poder revertir.
- Ejecutar consultas representativas contra ambas bases de conocimiento con Retrieve usando ese rol. Los dos tipos usan escalas de puntuación distintas; las puntuaciones administradas también dependen de rerankingModelType, que por defecto es MANAGED con el modelo de incrustaciones administrado y NONE con uno personalizado. Ajustar los umbrales por modo y mantener el modo constante durante la comparación.
- Probar los filtros de metadatos y la recuperación sensible a permisos donde se usen, incluido contenido que el usuario autenticado no debería recibir; en una fuente de datos con ACL habilitadas, las solicitudes sin userContext.userId (el correo del usuario) no devuelven resultados.
- Tras la aceptación, desplegar el nuevo ID de base de conocimiento y la forma de solicitud. Conservar la base de conocimiento original, con contenido actualizado, y la configuración de la aplicación durante el período de reversión.
Para cada consulta, comprobar si ambas devuelven el mismo documento principal y cuánto se solapan los resultados. Un script breve puede informar aprobado o reprobado frente a criterios como un documento principal coincidente en al menos el 90 por ciento de las consultas y ninguna consulta sin resultados en la base administrada; el umbral debe ajustarse a la carga de trabajo. Para otras medidas de calidad de recuperación, como la relevancia y la cobertura del contexto, véase Use metrics to understand RAG system performance.
Diferencias a vigilar al comparar resultados:
- Normalizar primero las ubicaciones de origen: una base de conocimiento administrada por el cliente puede devolver s3://bucket/key en location.s3Location.uri, mientras que una administrada puede devolver una URL https://; comparar por clave de objeto.
- Comparar el resultado principal en lugar de suponer recuentos iguales: los dos tipos pueden devolver números distintos de resultados y numberOfResults fija un máximo, no una garantía. Comparar el documento principal y revisar cada consulta donde cambie.
- Mapear las claves de metadatos de sistema renombradas en el código de comparación: por ejemplo, _data_source_id sustituye a x-amz-bedrock-kb-data-source-id. Los atributos de metadatos propios conservan sus nombres.
Limpieza
Si la migración se completa, retirar la original solo después del período de reversión y de una revisión de dependencias. Conservar los documentos y buckets de origen desde los que ingiere la base administrada y el almacenamiento que usan otras cargas de trabajo; limpiar los recursos gestionados por IaC a través de la plantilla que los posee.
Si en cambio se pone fin a la evaluación, conservar la original y eliminar lo creado en este orden:
- Eliminar cada fuente de datos administrada y esperar hasta que desaparezca.
- Eliminar la base de conocimiento administrada y esperar hasta que desaparezca.
- Si el rol de servicio se creó solo para esta evaluación, eliminar primero su política en línea y luego el rol.
- Con una clave administrada por el cliente, comprobar con aws kms list-grants los permisos que Amazon Bedrock creó, que pueden permanecer tras eliminar la base de conocimiento.
- Conservar cualquier bucket de S3 que otra base de conocimiento siga leyendo.
La protección contra eliminaciones de una fuente de datos administrada limita cuánto puede borrar una sincronización, no si se puede eliminar la fuente de datos. Eliminar la base de conocimiento original no elimina su almacén de vectores, que sigue generando cargos hasta que se elimina. Véase Delete an Amazon Bedrock knowledge base.
Conclusión
Con Amazon Bedrock Managed Knowledge Base, el equipo ya no opera un almacén de vectores ni administra la infraestructura de recuperación subyacente; la guía de migración de la habilidad amazon-bedrock permite pedir al agente un plan, revisarlo y aprobar solo los recursos que se desean crear. Para empezar, hay que configurar el Agent Toolkit for AWS y pedir al agente una evaluación de solo lectura de la base de conocimiento; tras migrar, se puede explorar la recuperación agéntica para preguntas de varias partes. Más detalles en Build enterprise search for agents with Amazon Bedrock Managed Knowledge Base, en el AWS Machine Learning Blog.