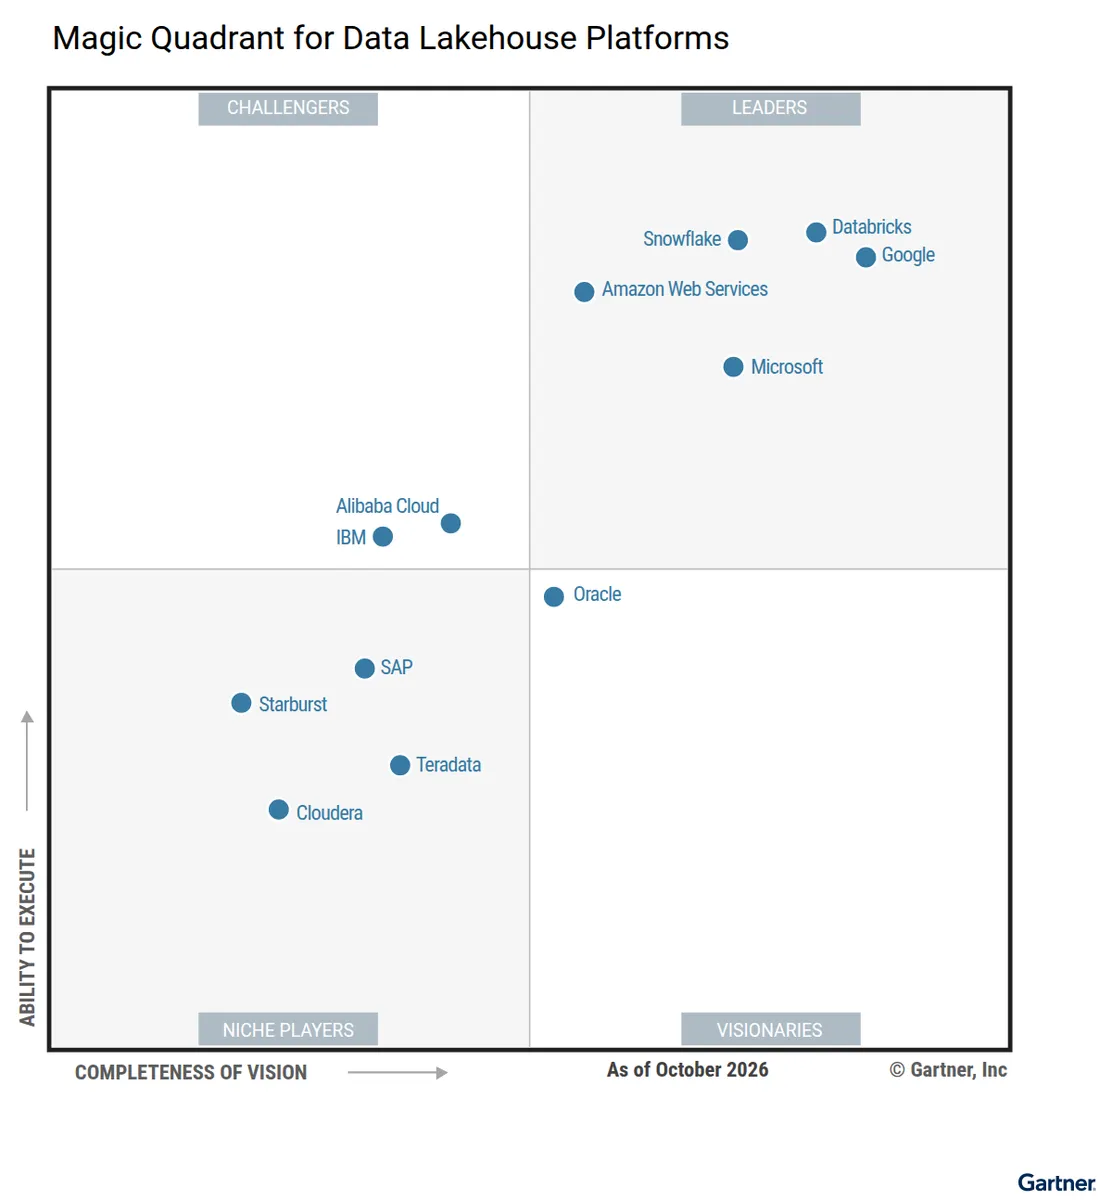
O Gartner nomeou o Google Cloud como líder, na posição mais avançada em visão, em seu primeiro Magic Quadrant for Data Lakehouse Platforms. Na avaliação do Google, o reconhecimento valida uma mudança que seus clientes já vivenciam: na era agêntica, o lakehouse corporativo deixa de ser um repositório passivo de dados e se torna a base sobre a qual agentes raciocinam e atuam em todos os dados da organização.
O lakehouse surgiu originalmente para levar a confiabilidade do data warehouse a um armazenamento aberto e de baixo custo, mas o critério que define a categoria está mudando. Segundo o Google, as grandes empresas migram rapidamente de relatórios estáticos para agentes de IA autônomos que monitoram operações, sinalizam anomalias e executam fluxos de trabalho empresariais em tempo real. Sustentar essa mudança exige uma plataforma em que milhares de agentes possam ler, raciocinar e agir continuamente sobre os dados corporativos sem movê-los antes — algo que, segundo a empresa, as arquiteturas de dados tradicionais e fragmentadas, sobrecarregadas por pipelines frágeis, armazenamento duplicado e governança desconectada, não foram projetadas para entregar em escala agêntica.
O Google afirma ter projetado seu borderless Lakehouse em todas as camadas da pilha para eliminar essa complexidade e seus custos ocultos. Concebido especificamente para que agentes raciocinem sobre dados em escala de petabytes, ele unifica o patrimônio de dados entre nuvens, plataformas de dados e aplicações SaaS, de modo que os agentes possam ser ancorados em um contexto empresarial governado e o Gemini possa ser levado diretamente aos dados.
Ativar a base de dados distribuída sem movê-la
Para a maioria das organizações, aponta o Google, a maior barreira para escalar a IA é que os dados corporativos estão espalhados por várias nuvens, bancos de dados operacionais e plataformas SaaS, e consolidá-los em um único local físico é lento, caro e gera riscos de governança. Construído sobre o formato aberto Apache Iceberg, o borderless Lakehouse funciona como ponte sobre esse ambiente distribuído e conecta dados de multinuvem, SaaS e sistemas operacionais em uma única malha governada. As organizações podem começar a analisar conjuntos de dados na AWS, no Azure e no Google Cloud sem cópias custosas nem migrações complexas, com três benefícios declarados:
- Abertura sem perda de desempenho: análises e IA rodam no BigQuery e no Managed Service for Apache Spark diretamente sobre tabelas abertas do Iceberg, com relação custo-desempenho semelhante à do armazenamento nativo.
- Economia multinuvem de alta velocidade: o Cross-Cloud Interconnect e o cache inteligente criam rotas privadas e rápidas para a AWS e o Azure; ao armazenar em cache apenas os blocos de dados ativos que cada consulta toca, o lakehouse atende buscas repetidas localmente, protege a residência dos dados e elimina tarifas variáveis de saída.
- Segurança e governança integradas verticalmente: a distribuição de credenciais (credential vending) no catálogo de execução do lakehouse (Lakehouse runtime catalog) pretende fazer com que as políticas de segurança acompanhem os agentes onde quer que os dados estejam.
O grupo bancário alemão Commerzbank construiu sua estratégia de IA sobre o borderless Lakehouse e o Apache Iceberg para implantar agentes de IA em centrais de atendimento e marketing, respeitando as rígidas regulamentações bancárias europeias. Segundo o Google, uma base unificada agora sustenta a IA em todo o banco: a equipe de marketing reduziu os prazos de produção de campanhas de semanas para dias, e os atendentes das centrais recebem próximos passos verificados em segundos.
Agentes precisam de contexto empresarial, não apenas de acesso
Um agente autônomo só é tão preciso quanto o contexto empresarial que compreende, defende o Google. O lakehouse coleta automaticamente metadados das camadas de armazenamento e os encaminha aos motores de contexto; o catálogo de execução se integra diretamente ao Knowledge Catalog, que o Google descreve como um motor de contexto universal que agrega e cura de forma autônoma metadados e contexto semântico de todas as fontes, dentro e fora do Google, enriquece-os para extrair significado e fornece esse contexto unificado aos agentes que a organização cria e utiliza. Entre os recursos destacados:
- Agregação unificada em toda a empresa: com a disponibilidade geral da agregação ampliada no Knowledge Catalog, as organizações podem unificar metadados, métricas e lógica de negócios do Looker, do dbt e do BigQuery em um único plano semântico governado que evita a divergência de métricas entre ativos multinuvem.
- Ancoragem de agentes pronta para uso: o Gemini conectado ao Knowledge Catalog e os conjuntos de contexto (context sets), ambos em prévia, permitem empacotar métricas e instruções curadas em pacotes eficientes em tokens que os agentes consomem por APIs padrão e pelo Model Context Protocol.
- Otimização de contexto sem código: uma nova experiência de estúdio no Knowledge Catalog, em prévia, oferece aos administradores de dados um ambiente sem código voltado a agentes para resolver lacunas de definição e governar com segurança o contexto exato ao qual os agentes estão autorizados a acessar. Entregar apenas o contexto mais relevante visa reduzir a latência, diminuir os custos de tokens e evitar loops de raciocínio caros.
A Bloomberg Media ancorou suas consultas conversacionais diretamente na camada semântica do Knowledge Catalog e, segundo o Google, obteve uma melhoria de 63% na precisão das consultas e eliminou alucinações em suas equipes de negócios.
O contexto empresarial é apenas metade da equação, afirma o Google: como os agentes agem e não apenas analisam, o lakehouse analítico e os bancos de dados operacionais precisam se comportar como um só sistema. BigQuery, Managed Service for Apache Spark, Spanner e AlloyDB foram projetados para funcionar em conjunto, tornando o borderless Lakehouse a base de dados do que o Google chama de Agentic Data Cloud.
Ferramentas para os profissionais de dados
Historicamente, engenheiros de dados, cientistas de dados e usuários de negócios trabalhavam em silos desconectados. O lakehouse se integra diretamente ao Gemini para que agentes possam ser criados, testados e operados sobre os dados unificados do lakehouse:
- Fluxos de trabalho orientados por intenção para equipes técnicas: o Data Agent Kit permite que profissionais de dados escrevam código, criem notebooks e executem modelos de ML a partir de seus IDEs e CLIs preferidos usando comandos de texto simples. Em vez de escrever código repetitivo do zero, as equipes podem usar habilidades agênticas prontas e ferramentas MCP para construir pipelines complexos e operar em mais de 15 serviços de dados do Google Cloud.
- Insights proativos e personalizados para usuários de negócios: a análise conversacional oferece respostas em linguagem natural sem esperar pelas equipes de dados, e a publicação com um clique transforma instantaneamente modelos técnicos aprovados em ferramentas conversacionais, permitindo que os funcionários façam perguntas em linguagem natural, gerem relatórios precisos e ancrem agentes personalizados nos fluxos diários sem programar.
O PayPal conectou seus modelos semânticos do Looker diretamente a agentes de IA com esses recursos, permitindo que as equipes de inteligência de negócios definissem os modelos de métricas uma única vez para que 5.000 funcionários consultassem dados ao vivo com precisão próxima de 100%, acelerando a obtenção de insights em 50%, segundo o Google.
Motores de IA no lakehouse
Para tomar decisões em tempo real, os agentes precisam executar loops de raciocínio complexos onde os dados residem. O Google afirma levar seus motores de IA e de processamento diretamente aos formatos de tabelas abertos:
- Análise em escala sem precedentes: as consultas do BigQuery ficaram mais de 40% mais rápidas e o custo de processamento foi reduzido em mais de 50% por meio de otimizações como o escalonamento fluido (fluid scaling) e a aceleração de cargas de trabalho integrada, enquanto o Lightning Engine for Apache Spark executa cargas Spark de formato aberto com vantagem de custo-desempenho superior a 3 vezes em relação à principal alternativa.
- IA e ML no local: o TabFM, em prévia, permite que equipes de negócios gerem previsões instantâneas sobre dados tabulares com consultas SQL simples, enquanto o TimesFM 3.0 no BigQuery oferece previsão multivariada avançada sobre os dados existentes.
- Processamento econômico em escala de agentes: como os agentes consultam dados continuamente e em rajadas curtas, o fluid scaling do BigQuery introduz cobrança por segundo sem duração mínima —eliminando o mínimo anterior de um minuto— com economia de custo de computação de até 34%.
Eficiência em escala sem custos descontrolados
Segundo o Google, o borderless Lakehouse redefine a economia da IA corporativa com economias cumulativas em computação, processamento de IA e consumo de tokens. À medida que os agentes aplicam IA sobre milhões de linhas, o Knowledge Catalog evita o gasto excessivo de tokens filtrando e entregando apenas os metadados e as métricas exatos exigidos por cada prompt, em vez de enviar conjuntos de dados massivos e desorganizados aos LLMs. O BigQuery AI adiciona controles de tokens integrados que permitem estimar o uso antes da execução de uma consulta, definir limites rígidos e mudar automaticamente para modelos menores e mais eficientes por meio de um modo otimizado; segundo a empresa, as funções de IA otimizadas em custo do BigQuery usam 230 vezes menos tokens do que o processamento generativo linha por linha.
O Google oferece uma cópia gratuita do relatório 2026 Gartner Magic Quadrant for Lakehouse Platforms. O relatório, intitulado Magic Quadrant for Data Lakehouse Platforms e datado de 04.11.2026, foi elaborado por Aaron Rosenbaum, Michael Gonzales, Masud Miraz, Ramke Ramakrishnan, Xingyu Gu, Robin Schumacher e Prasad Pore. O Gartner não endossa nenhuma empresa, fornecedor, produto ou serviço descrito em suas publicações e afirma que elas refletem as opiniões de sua organização de pesquisa, não devendo ser interpretadas como declarações de fato.