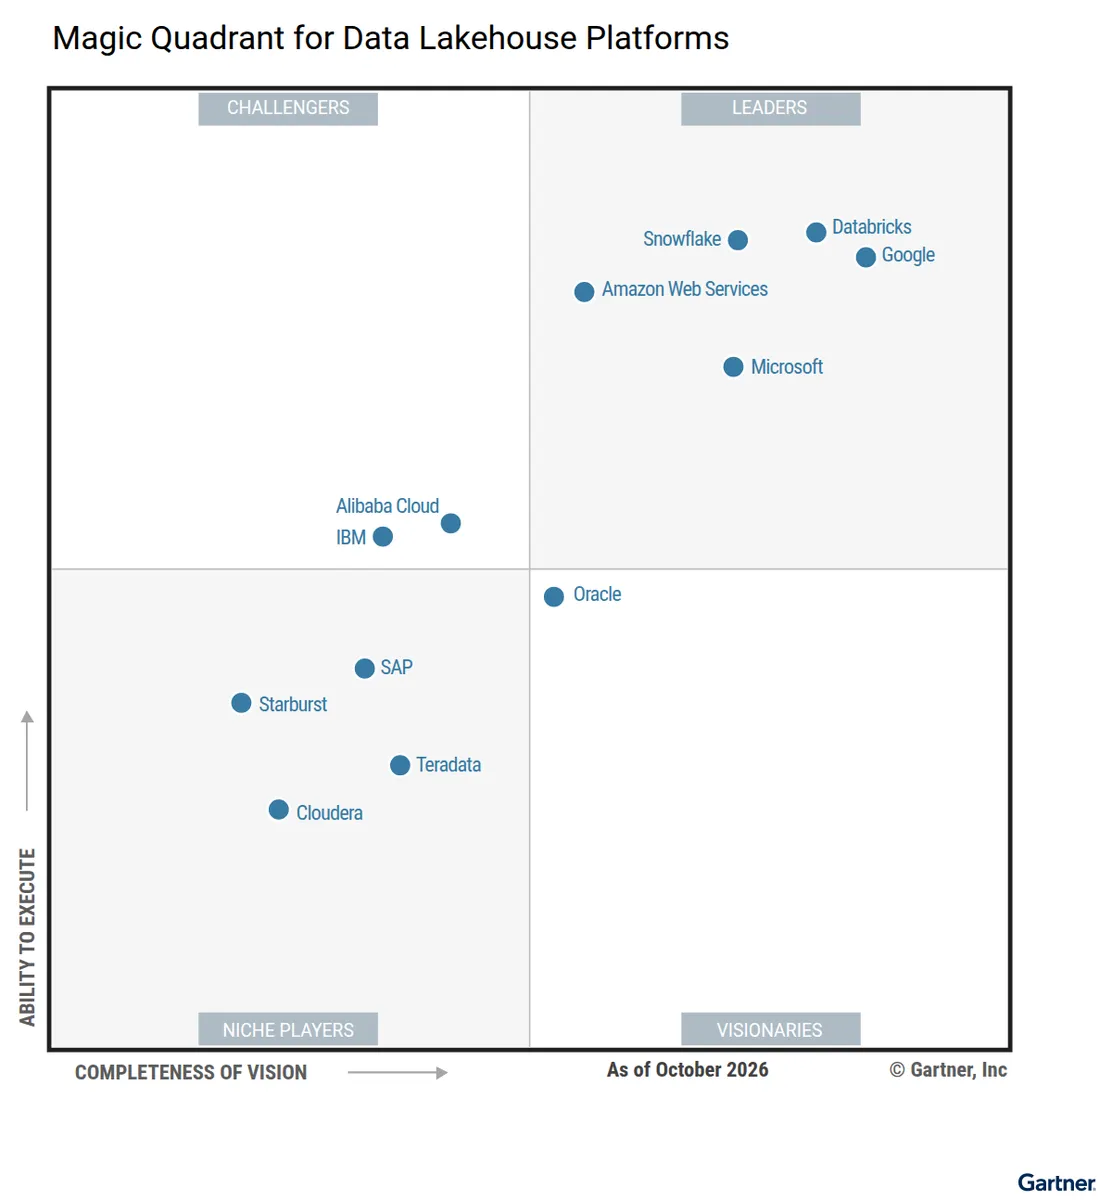
Gartner ha nombrado a Google Cloud líder, en la posición más avanzada en visión, en su primer Magic Quadrant for Data Lakehouse Platforms. En opinión de Google, este reconocimiento valida un cambio que sus clientes ya experimentan a diario: en la era agéntica, el lakehouse empresarial ya no es un repositorio pasivo de datos, sino una base sobre la que los agentes razonan y actúan en todos los datos de la organización.
El lakehouse surgió originalmente para aportar la fiabilidad de un almacén de datos a un almacenamiento abierto y de bajo costo, pero el criterio que define la categoría está cambiando. Según Google, las empresas líderes pasan rápidamente de los informes estáticos a agentes de IA autónomos que supervisan operaciones, señalan anomalías y ejecutan flujos de trabajo empresariales en tiempo real. Sostener ese cambio exige una plataforma en la que miles de agentes puedan leer, razonar y actuar de forma continua sobre los datos corporativos sin moverlos primero, algo que, según la compañía, las arquitecturas de datos tradicionales y fragmentadas —lastradas por canalizaciones frágiles, almacenamiento duplicado y una gobernanza inconexa— no fueron diseñadas para ofrecer a escala agéntica.
Google afirma haber diseñado su borderless Lakehouse en cada capa de la pila para eliminar esa complejidad y sus costos ocultos. Concebido específicamente para que los agentes razonen sobre datos a escala de petabytes, unifica el patrimonio de datos entre nubes, plataformas de datos y aplicaciones SaaS, de modo que los agentes puedan anclarse en un contexto empresarial gobernado y Gemini pueda llevarse directamente a los datos.
Activar la huella de datos distribuida sin moverla
Para la mayoría de las organizaciones, señala Google, el mayor obstáculo para escalar la IA es que los datos corporativos están repartidos entre varias nubes, bases de datos operativas y plataformas SaaS, y concentrarlos en una única ubicación física es lento, caro y entraña riesgos de gobernanza. Construido sobre el formato abierto Apache Iceberg, el borderless Lakehouse actúa como puente sobre ese entorno distribuido y conecta los datos multinube, SaaS y operativos en un único tejido gobernado. Las organizaciones pueden empezar a analizar conjuntos de datos en AWS, Azure y Google Cloud sin copias costosas ni migraciones complejas, con tres ventajas declaradas:
- Apertura sin sacrificar rendimiento: los análisis y la IA se ejecutan en BigQuery y Managed Service for Apache Spark directamente sobre tablas abiertas de Iceberg, con una relación precio-rendimiento similar a la del almacenamiento nativo.
- Economía multinube de alta velocidad: Cross-Cloud Interconnect y el almacenamiento en caché inteligente establecen rutas privadas y rápidas hacia AWS y Azure; al guardar en caché solo los bloques de datos activos que toca cada consulta, el lakehouse sirve las búsquedas repetidas de forma local, protege la residencia de los datos y elimina las tarifas variables de salida.
- Seguridad y gobernanza integradas verticalmente: la entrega de credenciales (credential vending) en el catálogo de ejecución del lakehouse (Lakehouse runtime catalog) pretende que las políticas de seguridad acompañen a los agentes dondequiera que residan los datos.
El grupo bancario alemán Commerzbank construyó su estrategia de IA sobre el borderless Lakehouse y Apache Iceberg para desplegar agentes de IA en centros de contacto y marketing cumpliendo la estricta regulación bancaria europea. Según Google, una base unificada impulsa ahora la IA en todo el banco: el equipo de marketing redujo los tiempos de producción de campañas de semanas a días y los agentes de los centros de contacto reciben pasos siguientes verificados en cuestión de segundos.
Los agentes necesitan contexto empresarial, no solo acceso
Un agente autónomo solo es tan preciso como el contexto empresarial que comprende, sostiene Google. El lakehouse recopila automáticamente metadatos de las capas de almacenamiento y los pasa a los motores de contexto; el catálogo de ejecución se integra directamente con Knowledge Catalog, que Google describe como un motor de contexto universal que agrega y cura de forma autónoma metadatos y contexto semántico de todas las fuentes, dentro y fuera de Google, los enriquece para extraer significado y sirve ese contexto unificado a los agentes que la organización crea y utiliza. Entre las capacidades destacadas:
- Agregación unificada en toda la empresa: con la disponibilidad general de la agregación ampliada en Knowledge Catalog, las organizaciones pueden unificar metadatos, métricas y lógica de negocio de Looker, dbt y BigQuery en un solo plano semántico gobernado que evita la deriva de métricas entre activos multinube.
- Anclaje de agentes listo para usar: Gemini conectado a Knowledge Catalog y los conjuntos de contexto (context sets), ambos en vista previa, permiten empaquetar métricas e instrucciones curadas en paquetes eficientes en tokens que los agentes consumen mediante API estándar y el Model Context Protocol.
- Optimización de contexto sin código: una nueva experiencia de estudio en Knowledge Catalog, en vista previa, ofrece a los administradores de datos un entorno sin código orientado a agentes para resolver lagunas de definición y gobernar de forma segura el contexto exacto al que los agentes están autorizados a acceder. Entregar solo el contexto más relevante busca reducir la latencia, bajar los costos de tokens y evitar bucles de razonamiento costosos.
Bloomberg Media ancló sus consultas conversacionales directamente en la capa semántica de Knowledge Catalog y, según Google, logró una mejora del 63 % en la precisión de las consultas y eliminó las alucinaciones en sus equipos de negocio.
El contexto empresarial es solo la mitad de la ecuación, afirma Google: como los agentes actúan y no solo analizan, el lakehouse analítico y las bases de datos operativas deben comportarse como un solo sistema. BigQuery, Managed Service for Apache Spark, Spanner y AlloyDB están diseñados para funcionar conjuntamente, convirtiendo el borderless Lakehouse en la base de datos de lo que Google denomina Agentic Data Cloud.
Herramientas para los profesionales del dato
Históricamente, ingenieros de datos, científicos de datos y usuarios de negocio trabajaban en silos desconectados. El lakehouse se integra directamente con Gemini para que los agentes puedan crearse, probarse y operarse sobre los datos unificados del lakehouse:
- Flujos de trabajo guiados por intención para equipos técnicos: el Data Agent Kit permite a los profesionales de datos escribir código, crear notebooks y ejecutar modelos de ML desde sus IDE y CLI preferidos mediante indicaciones de texto simples. En lugar de escribir código repetitivo desde cero, los equipos pueden usar habilidades agénticas predefinidas y herramientas MCP para construir canalizaciones complejas y operar en más de 15 servicios de datos de Google Cloud.
- Información proactiva y personalizada para usuarios de negocio: el análisis conversacional ofrece respuestas en lenguaje natural sin esperar a los equipos de datos, y la publicación con un clic convierte al instante modelos técnicos aprobados en herramientas conversacionales, de modo que los empleados puedan hacer preguntas en lenguaje natural, generar informes precisos y anclar agentes personalizados en sus flujos diarios sin programar.
PayPal conectó sus modelos semánticos de Looker directamente a agentes de IA con estas capacidades, lo que permitió a los equipos de inteligencia de negocio definir los modelos de métricas una sola vez para que 5.000 empleados consultaran datos en vivo con una precisión cercana al 100 %, acelerando la obtención de información en un 50 %, según Google.
Motores de IA en el lakehouse
Para tomar decisiones en tiempo real, los agentes necesitan ejecutar bucles de razonamiento complejos donde residen los datos. Google afirma llevar sus motores de IA y de procesamiento directamente a los formatos de tablas abiertos:
- Análisis a escala sin precedentes: las consultas de BigQuery son más de un 40 % más rápidas y el costo de procesamiento se ha reducido en más de un 50 % gracias a optimizaciones como el escalado fluido (fluid scaling) y la aceleración de cargas de trabajo integrada, mientras que el Lightning Engine for Apache Spark ejecuta cargas Spark de formato abierto con una ventaja de precio-rendimiento superior a 3 veces frente a la principal alternativa.
- IA y ML en el lugar: TabFM, en vista previa, permite a los equipos de negocio generar predicciones instantáneas sobre datos tabulares con consultas SQL simples, mientras que TimesFM 3.0 en BigQuery ofrece previsión multivariante avanzada sobre los datos existentes.
- Procesamiento rentable a escala de agentes: como los agentes consultan datos de forma continua y en ráfagas cortas, el fluid scaling de BigQuery introduce facturación por segundo sin duración mínima —eliminando el mínimo anterior de un minuto— con ahorros de costo de cómputo de hasta un 34 %.
Eficiencia a escala sin costos descontrolados
Según Google, el borderless Lakehouse redefine la economía de la IA empresarial con ahorros acumulativos en cómputo, procesamiento de IA y consumo de tokens. A medida que los agentes aplican IA sobre millones de filas, Knowledge Catalog evita el gasto excesivo de tokens filtrando y entregando solo los metadatos y métricas precisos que requiere cada indicación, en lugar de enviar conjuntos de datos masivos y desorganizados a los LLM. BigQuery AI añade controles de tokens integrados que permiten estimar el uso antes de ejecutar una consulta, fijar límites firmes y cambiar automáticamente a modelos más pequeños y eficientes mediante un modo optimizado; según la compañía, las funciones de IA optimizadas en costo de BigQuery usan 230 veces menos tokens que el procesamiento generativo fila por fila.
Google ofrece una copia gratuita del informe 2026 Gartner Magic Quadrant for Lakehouse Platforms. El informe, titulado Magic Quadrant for Data Lakehouse Platforms y fechado el 04.11.2026, fue elaborado por Aaron Rosenbaum, Michael Gonzales, Masud Miraz, Ramke Ramakrishnan, Xingyu Gu, Robin Schumacher y Prasad Pore. Gartner no respalda a ninguna empresa, proveedor, producto ni servicio descrito en sus publicaciones y señala que estas reflejan las opiniones de su organización de investigación y no deben interpretarse como declaraciones de hechos.