A Hugging Face publicou um guia que disponibiliza scripts de fine-tuning e imagens de contêiner para adaptar o TRELLIS.2, um modelo popular de geração 3D, aos próprios ativos 3D do usuário. Os mesmos contêineres rodam localmente ou no Hugging Face Jobs. Se o conjunto de dados já estiver no Hugging Face Hub, o treinamento pode ser iniciado com apenas alguns argumentos; o repositório que acompanha o guia também pode ser modificado diretamente. O artigo ainda explica como o script funciona internamente.
Contexto
A geração 3D é usada em robótica, simulação, mídia e entretenimento, áreas em que os objetos gerados precisam obedecer a regras rígidas e as representações de dados precisam ser padronizadas. O campo é fragmentado: formatos de arquivo como GLB e PLY convivem com representações como neural radiance fields (NeRFs) e 3D Gaussian splatting (3DGS), cada uma com vantagens e desvantagens próprias.
O TRELLIS original resolveu essa fragmentação com uma representação latente unificada; seus decodificadores convertem essa representação no formato de saída necessário, eliminando a necessidade de modelos separados por formato. A mesma equipe lançou depois o TRELLIS.2, que representa a estrutura 3D com mais fidelidade, mas nenhum dos dois modelos oferece um caminho simples para adaptá-lo a uma tarefa específica.
O problema a resolver
Um modelo de uso geral como o TRELLIS.2 pode errar em detalhes importantes para uma aplicação específica, por exemplo quando o usuário precisa de geometria precisa para modelos de móveis. O experimento descrito usa um subconjunto do conjunto de dados Google Scanned Objects (GSO) com 188 objetos de calçados. Nos testes iniciais dos autores, o modelo pré-treinado gerava sapatos que pareciam corretos, mas com solas incorretas; o experimento testa se um LoRA pode tornar as solas mais precisas.
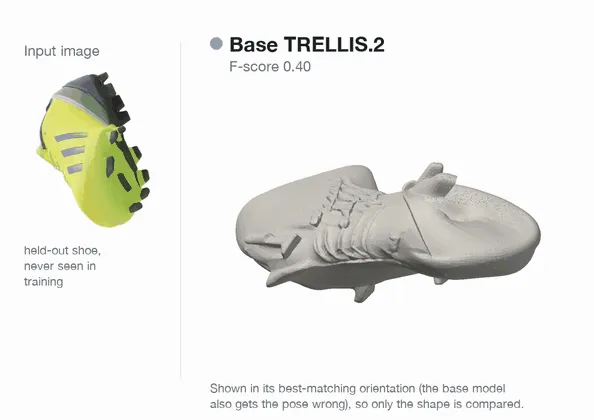
O objetivo declarado é melhorar o TRELLIS.2 em uma única categoria de objetos usando o GSO e mostrar quais componentes do pipeline devem ser ajustados e quais devem permanecer intactos. Como o pipeline separa estrutura, geometria detalhada e materiais, apenas os componentes relevantes para a tarefa são treinados. Os autores destacam que decidir o que congelar importa tanto quanto decidir o que ajustar.
Ferramentas
O LoRA (low-rank adaptation, adaptação de baixo posto) treina pequenas matrizes adaptadoras enquanto os pesos originais ficam congelados, o que reduz o número de parâmetros treináveis e a memória necessária para gradientes e estado do otimizador. Os adaptadores são adicionados e treinados com a biblioteca PEFT da Hugging Face.
O Hugging Face Jobs executa cargas de trabalho em contêineres em hardware na nuvem e é usado tanto no pré-processamento quanto no treinamento; comandos Docker locais são fornecidos para quem preferir usar a própria GPU. Os pré-requisitos são um HF_TOKEN e uma conta Hugging Face com acesso ao DINOv3, que é um modelo restrito (gated). Quem usa um conjunto de dados próprio precisa enviar as malhas ao Hub antes de começar.
Como o TRELLIS.2 funciona
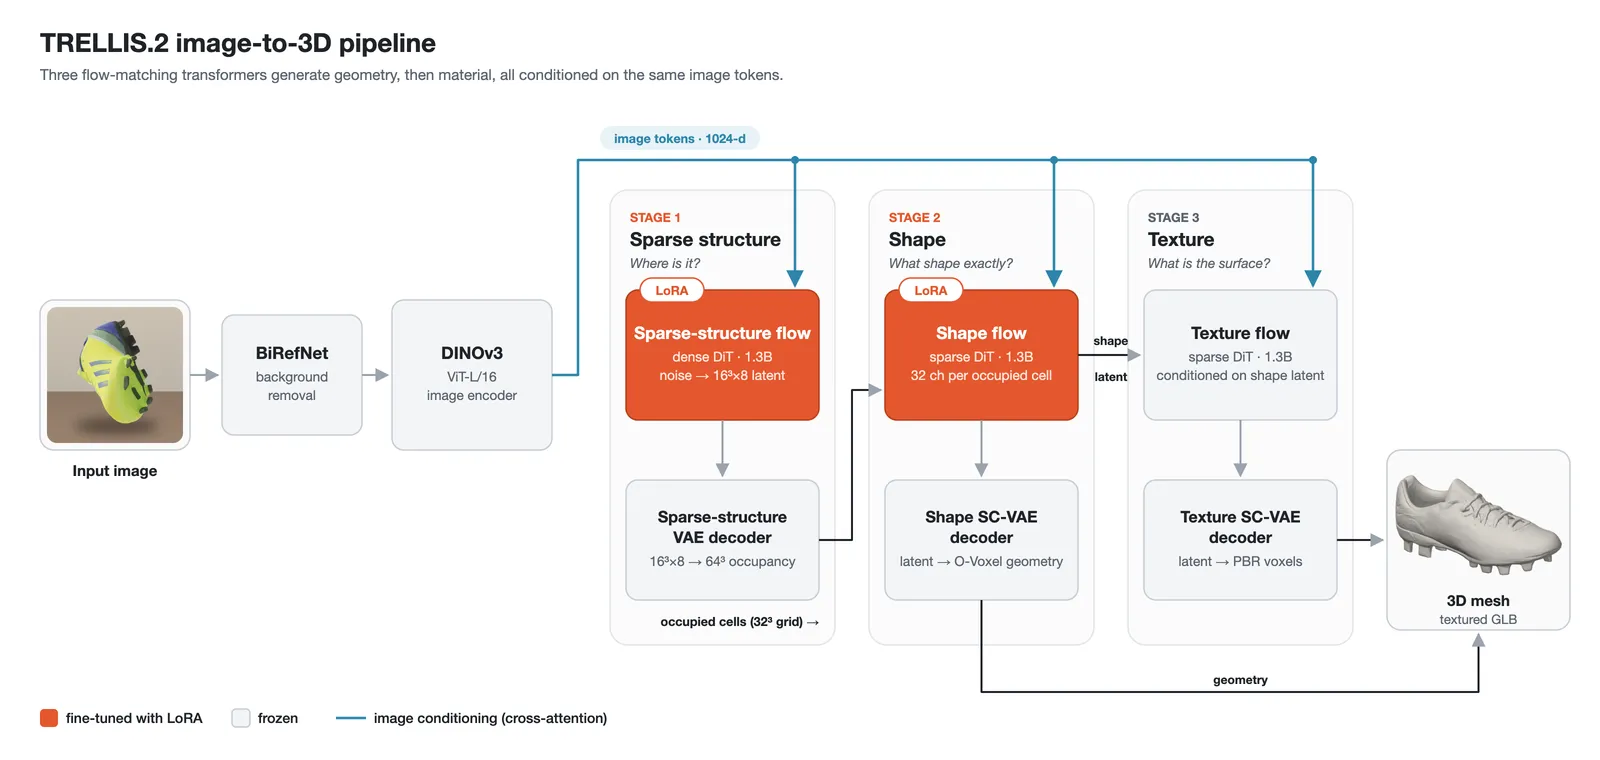
Antes do treinamento, o artigo percorre os cinco estágios principais do pipeline: remover o fundo da imagem, codificar a imagem, prever a estrutura grosseira, gerar a geometria detalhada e gerar os materiais; em seguida, o resultado é exportado como uma malha texturizada.
Codificação da imagem de entrada
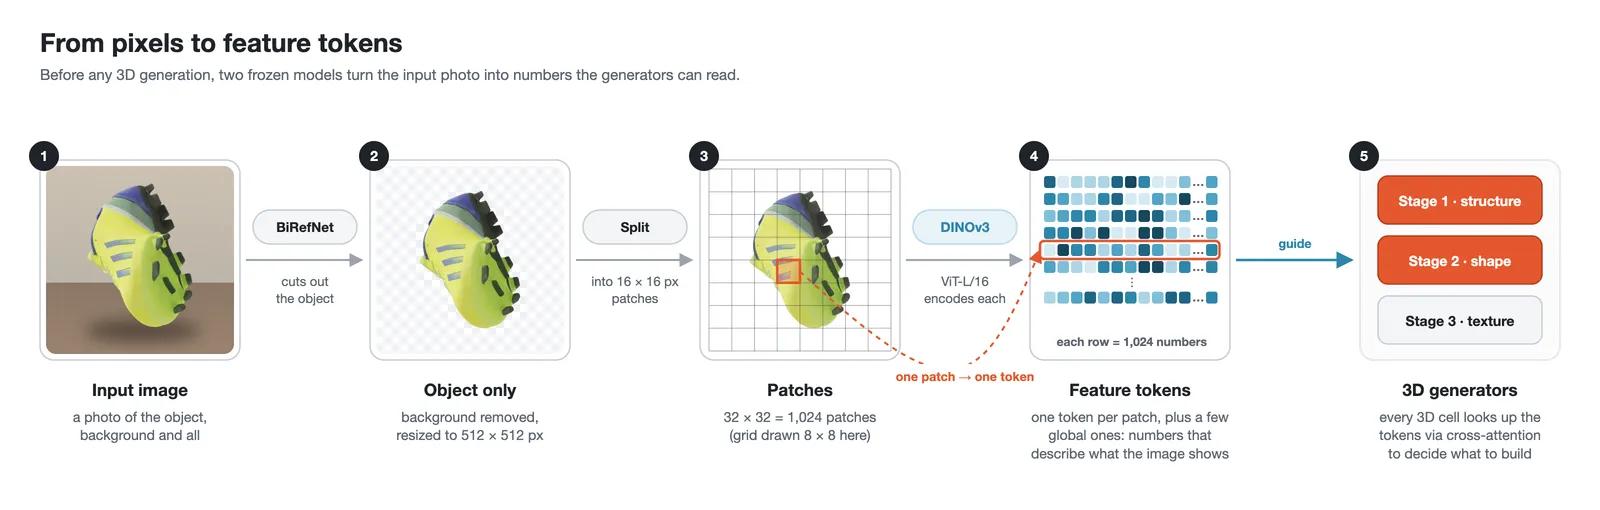
Primeiro, o BiRefNet remove o fundo da imagem de entrada. Em seguida, o DINOv3-L a codifica em tokens de características, que os modelos de geração usam para guiar o objeto 3D.
Geração da estrutura esparsa
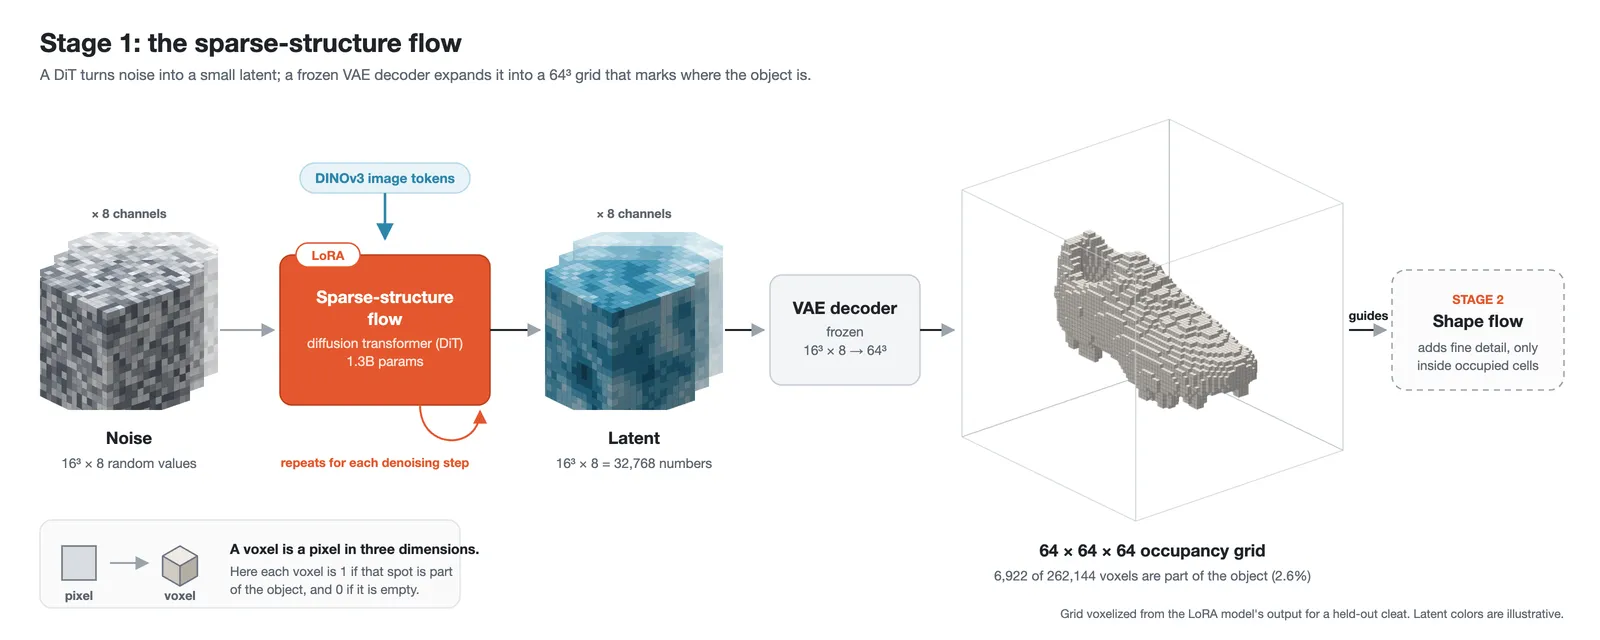
O DiT de fluxo de estrutura esparsa, um transformer de difusão, prevê a forma grosseira do objeto como um latente pequeno de tamanho 16³ × 8. Um decodificador de autoencoder variacional (VAE) converte esse latente em uma grade de ocupação de 64 × 64 × 64, em que cada voxel, um pixel em três dimensões, indica se aquela posição pertence ao objeto. Os adaptadores LoRA são adicionados aqui porque a saída deste estágio guia o estágio de geometria.
O-Voxel e latentes estruturados
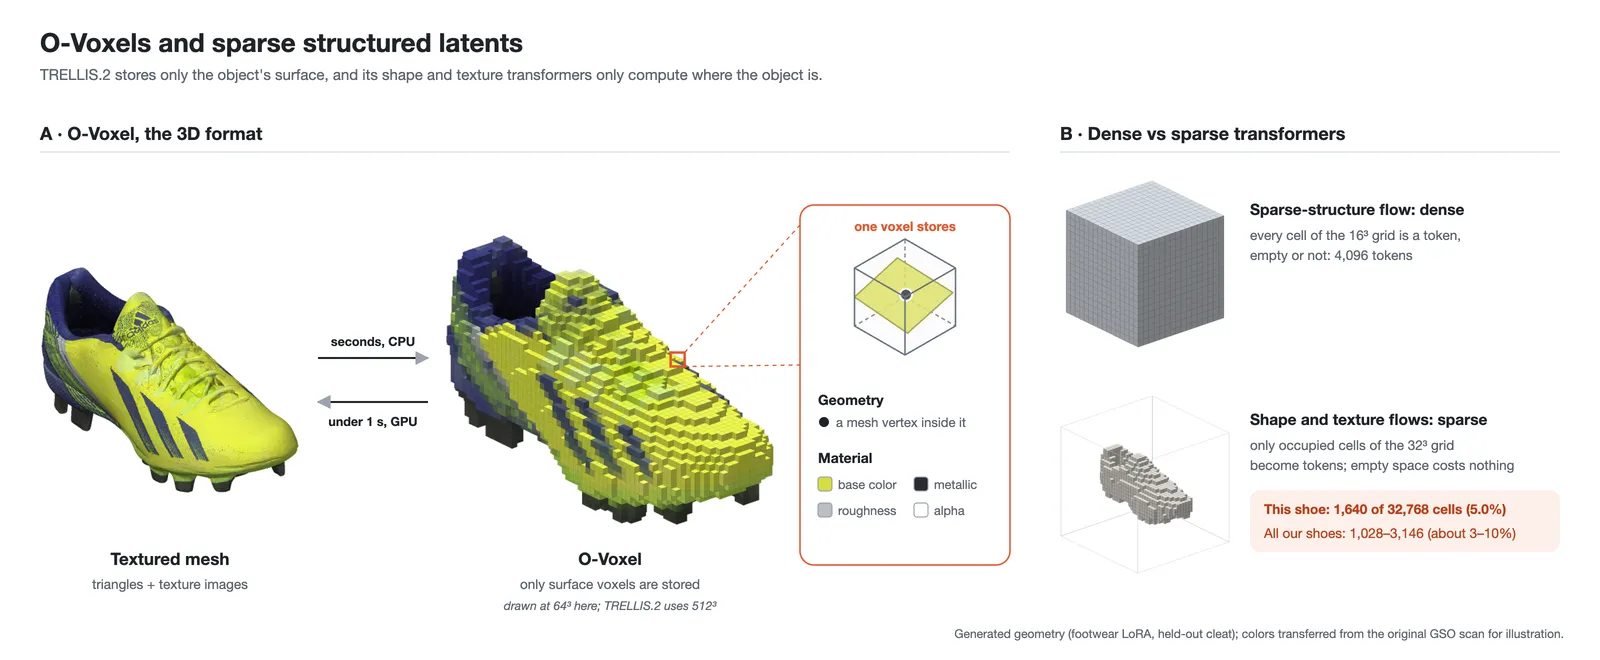
O O-Voxel, formato 3D do TRELLIS.2, é uma grade de voxels esparsa que mantém apenas os voxels da superfície; cada um guarda geometria local, como um vértice de malha, além de atributos de material. Por ser compacto, uma CPU converte uma malha em O-Voxel em segundos e uma GPU faz a conversão de volta em segundos.
Os latentes esparsos estruturados vêm do TRELLIS e mantêm os dados 3D em tensores esparsos para acelerar o cálculo. Apenas cerca de 10% dos voxels da grade são usados, portanto não se gasta computação com espaço vazio. Assim, o DiT de fluxo de forma e o DiT de fluxo de textura são transformers esparsos, enquanto o DiT de fluxo de estrutura esparsa é um transformer denso.
Geração de geometria (fluxo de forma)
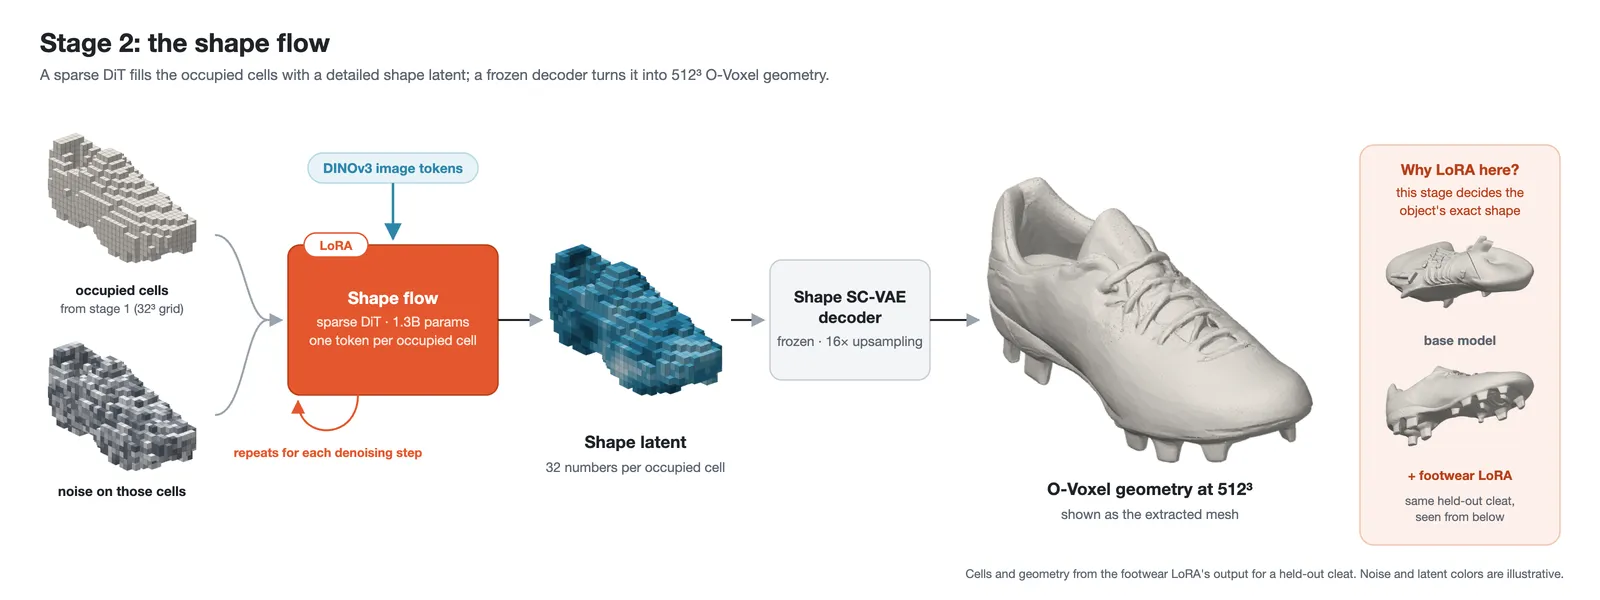
O DiT de fluxo de forma usa a grade de ocupação e os tokens de características do DINOv3 para produzir um latente, que um segundo decodificador VAE transforma em geometria O-Voxel com resolução de 512 × 512 × 512. Os adaptadores LoRA são adicionados neste estágio porque ele controla a forma do objeto.
Geração de materiais e criação da malha
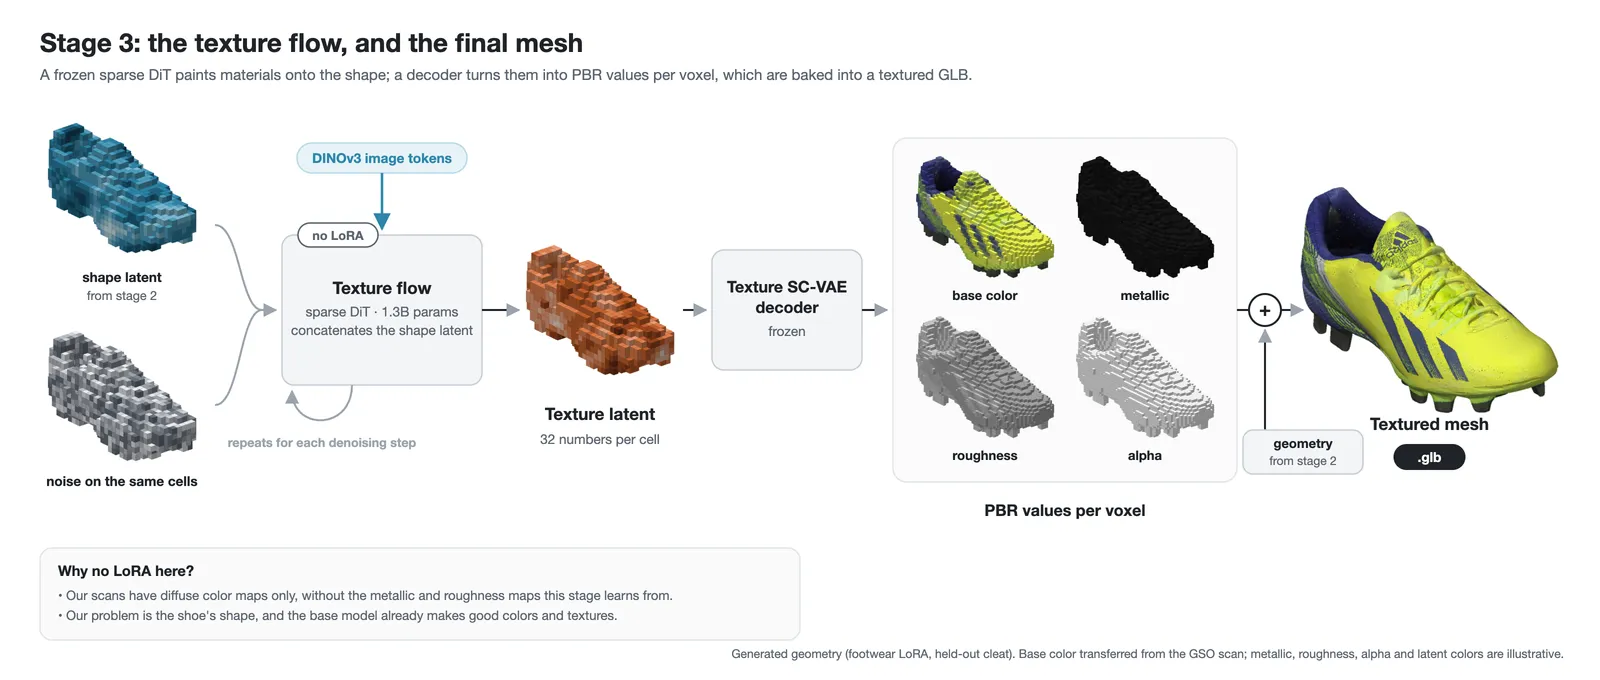
No estágio final, o DiT de fluxo de textura recebe o latente de forma e as características do DINOv3 e define os materiais e as texturas da superfície; um decodificador VAE produz valores de cor base, metálico, rugosidade e alfa para cada voxel. Nenhum adaptador é adicionado aqui: o conjunto de dados traz mapas de cor difusa, mas não os mapas de materiais separados necessários para treinar este estágio; além disso, o problema está na forma do sapato, e o modelo base já gera boas cores e texturas. Depois, o pipeline combina geometria e atributos de material em uma malha texturizada exportada como arquivo GLB.
Planejamento do fine-tuning
Os adaptadores são aplicados somente ao DiT de fluxo de estrutura esparsa e ao DiT de fluxo de forma, os dois DiTs que controlam forma e geometria, enquanto o DiT de fluxo de textura permanece congelado para preservar suas capacidades. Os mapas de cor difusa do conjunto de dados contêm iluminação incorporada (baked), portanto não são alvos de treinamento válidos: treinar o DiT de textura com eles poderia fazê-lo aprender a exibir iluminação como propriedade da superfície e causar esquecimento catastrófico do aprendizado anterior.
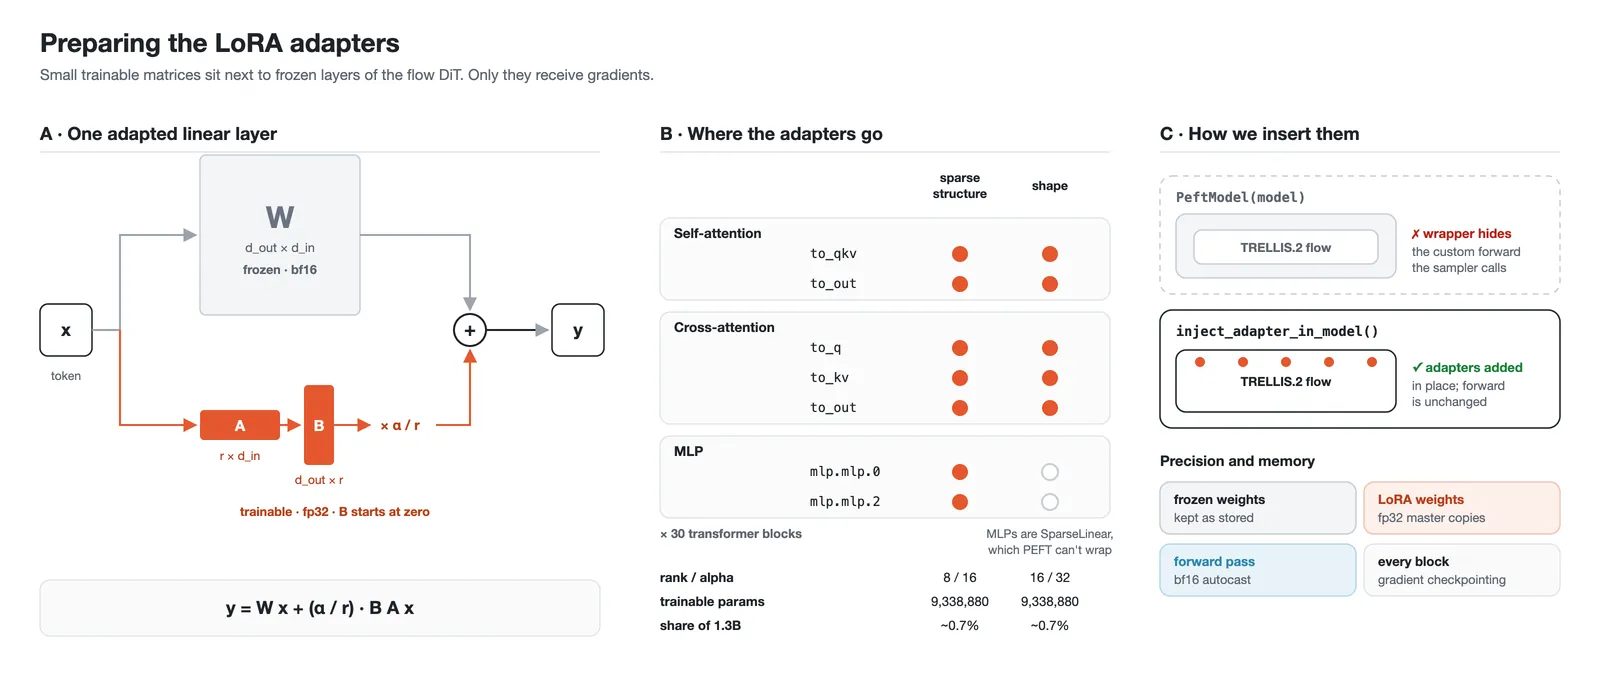
O subconjunto tem 188 sapatos entre os 1.030 objetos do GSO. Nessa escala, o LoRA é preferível ao fine-tuning completo, que custa muito mais e pode sobrescrever os priors aprendidos do modelo. A configuração treina cerca de 9,3 milhões de parâmetros de adaptador no total para os dois DiTs: adaptadores de posto 8 nas camadas de atenção e feed-forward (MLP) do DiT de estrutura esparsa, e adaptadores de posto 16 nas camadas de atenção do DiT de forma. O posto define o tamanho das matrizes adaptadoras; um posto maior permite ao adaptador aprender mais.
O que será executado
Configurar um modelo 3D pode exigir muitas dependências, por isso são fornecidas duas imagens Docker, uma de pré-processamento e uma de fine-tuning, que rodam no Hugging Face Jobs ou em uma máquina local. O fluxo de trabalho é: dar aos contêineres acesso aos dados, definir os parâmetros da tarefa, executar o contêiner de pré-processamento e, depois, o de fine-tuning, que treina os adaptadores e os envia ao Hub.
O experimento tem três partes: preparar os dados (converter malhas GLB ou OBJ nas representações latentes que o TRELLIS.2 usa para treinar e renderizar as imagens de entrada), treinar os adaptadores (um job por DiT com o conjunto preparado e uma configuração LoRA) e explicar o código que carrega os dados, insere os adaptadores e treina os modelos. O conjunto pré-processado é salvo para que todas as execuções de treinamento o reutilizem.
Execução no Hugging Face Jobs
Pré-processamento
O contêiner de pré-processamento renderiza 16 vistas de cada objeto com o Blender em modo headless por meio do utilitário xvfb-run; essas vistas servem como imagens de condicionamento do treinamento LoRA. Ele também processa cada objeto pelo pipeline de pré-processamento. Para os 188 objetos, a execução completa levou cerca de 1 hora em um job a100-large. Há um conjunto de calçados publicado como exemplo de saída intermediária e uma versão compacta do pipeline de pré-processamento em um repositório complementar.
export HF_TOKEN=hf_xxx
# Replace your-username with your Hugging Face username
hf jobs run -d --flavor a100-large --timeout 6h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep \
    --meshes your-username/my-meshes \
    --push-to your-username/my-meshes-trellis2 \
    --private --holdout 0.05 \
    --views 16 --workers 8
Principais flags para o Hugging Face Jobs:
| flag | significado |
|---|---|
| -d | Detach: imprime o ID do job e a URL e retorna; para acompanhar o job, hf jobs logs -f |
| --flavor a100-large | O hardware; a100-large oferece 80 GB e hf jobs hardware lista todas as opções |
| --timeout 6h | O job para após esse tempo; ambos os comandos são retomados: o pré-processamento pula objetos concluídos e o treinamento continua a partir do checkpoint mais recente em --push-to |
| --secrets HF_TOKEN | Envia o token (de HF_TOKEN ou hf auth login) ao job como variável de ambiente criptografada; ele não é gravado na imagem |
| cr.hf.co/...:latest | A imagem a executar; todo o texto depois dela é o comando executado dentro do contêiner |
O contêiner aceita argumentos adicionais, documentados separadamente, que valem tanto para execução no Jobs quanto com Docker.
Fine-tuning com LoRA
O contêiner de treinamento carrega o conjunto preparado e um preset ou arquivo de configuração, e registra as métricas de treinamento com o Trackio, cujo painel é usado para acompanhar a execução. Há dois modos: 'ss' ajusta apenas o DiT de fluxo de estrutura esparsa e 'shape' ajusta apenas o DiT de fluxo de forma; internamente, cada um referencia um config.json diferente.
export HF_TOKEN=hf_xxx  # Replace your-username with your Hugging Face username
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio

hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Se --push-to for definido, o contêiner envia checkpoints de adaptadores ao Hub. Para ajustar com o conjunto já processado publicado pelos autores, aponte --latents para suvadityamuk/gso-footwear-trellis2-latents e envie o resultado para um repositório próprio:
export HF_TOKEN=hf_xxx
# Replace your-username with your Hugging Face username
# For the Sparse-Structure Flow DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
# For the Shape Flow DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Execução local com Docker
Os comandos e flags são os mesmos do Hugging Face Jobs; apenas as opções do Docker mudam.
# For preprocessing into latents
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN=hf_xxx \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep --meshes your-username/my-meshes --push-to your-username/my-meshes-trellis2
# For Sparse-structure Flow DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio
# For Shape Flow DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio
Para usar o conjunto já pré-processado em uma máquina local:
export HF_TOKEN=hf_xxx  # Replace your-username with your Hugging Face username
# For Sparse-structure Flow DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
# For Shape Flow DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Os adaptadores LoRA treinados estão publicados no repositório suvadityamuk/trellis-2-finetune-gso.
Dentro do pipeline de treinamento
Pré-processamento em latentes
Os codificadores congelados do TRELLIS.2 convertem as malhas de entrada em latentes de treinamento, que são salvos para que execuções posteriores não precisem codificar as malhas novamente. Também são renderizadas 16 vistas por objeto no Blender; durante o treinamento, uma vista aleatória por amostra serve como imagem de condicionamento. Nove dos 188 objetos ficam reservados para avaliação e os outros 179 são usados no treinamento, de modo que os objetos reservados mostram se os adaptadores funcionam em objetos que o modelo não viu durante o treinamento.
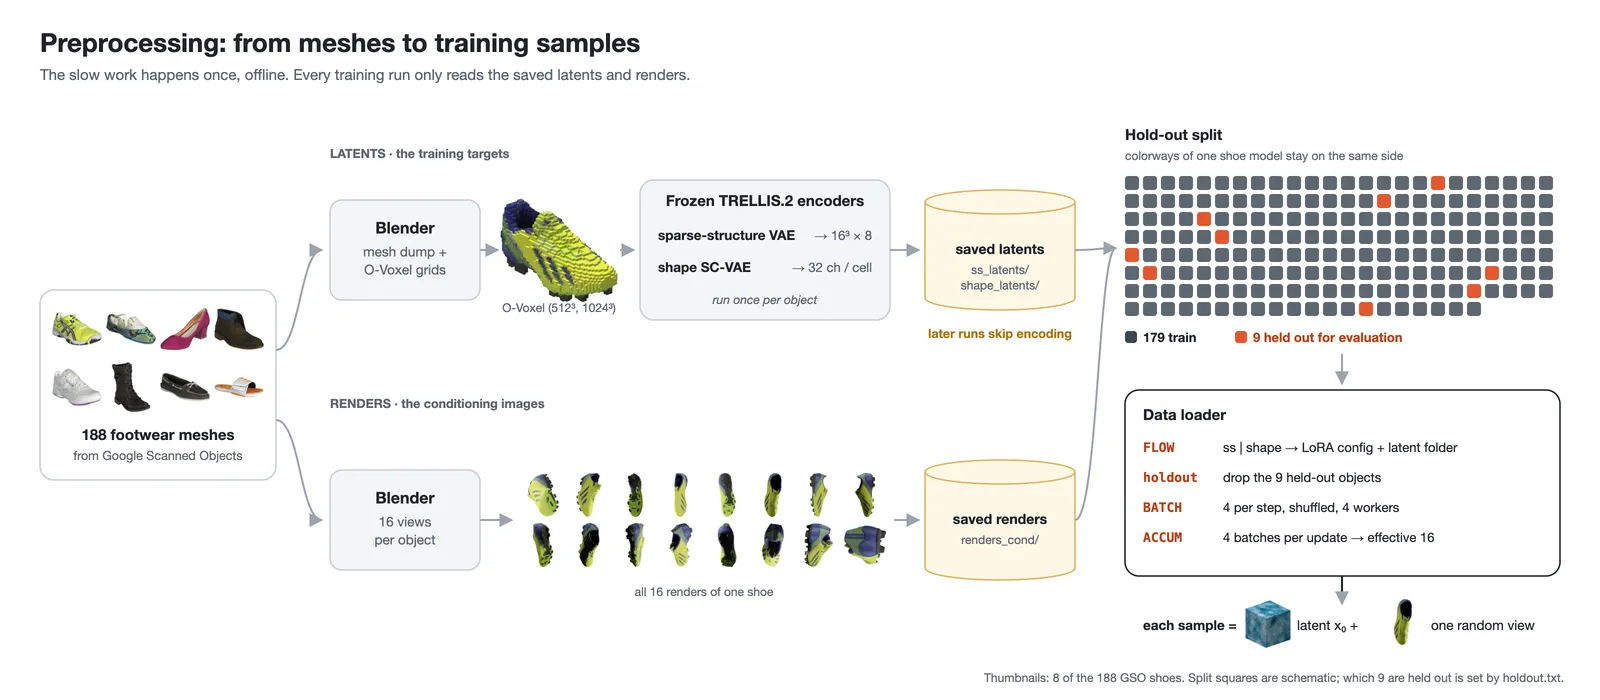
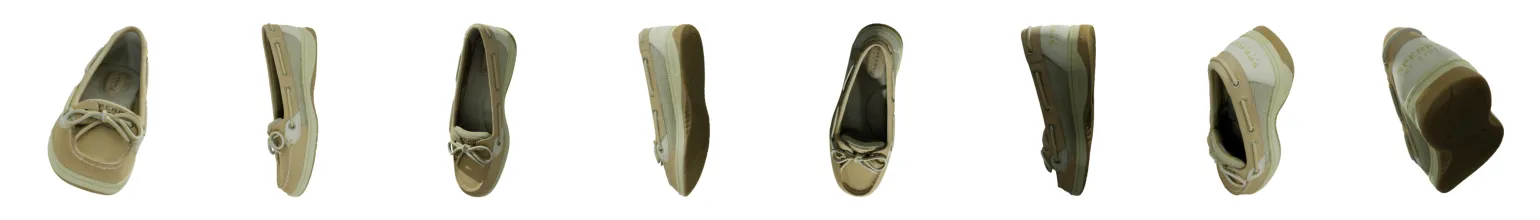
O código de preparação escolhe o DiT por meio de FLOW ('ss' ou 'shape'), define o número de passos do otimizador com STEPS, carrega o arquivo de configuração LoRA do DiT escolhido (configs/lora/ss_flow_lora_gso.json ou configs/lora/slat_flow_img2shape_lora_gso.json), monta o conjunto de dados no formato TRELLIS.2 a partir dos latentes salvos (ss_latents/ss_enc_conv3d_16l8_fp16_64 ou shape_latents/shape_enc_next_dc_f16c32_fp16_512), remove os objetos reservados e cria o carregador de dados. Um tamanho de lote de 4 com 4 passos de acumulação de gradiente resulta em um tamanho de lote efetivo de 16.
Preparando os adaptadores LoRA
A biblioteca peft insere os adaptadores LoRA nas camadas selecionadas. Como o TRELLIS.2 usa um forward pass personalizado, o wrapper padrão PeftModel() não funciona; em vez disso, chama-se inject_adapter_in_model(), que adiciona os adaptadores diretamente e preserva a interface personalizada do modelo. Os pesos treináveis do adaptador são mantidos em ponto flutuante de 32 bits (fp32) para estabilidade numérica, e o forward pass usa autocasting em bfloat16 (bf16), que reduz o uso de memória em algumas operações sem alterar como os pesos congelados do backbone são armazenados. O gradient checkpointing é ativado em cada bloco com block.use_checkpoint = True.
Treinamento
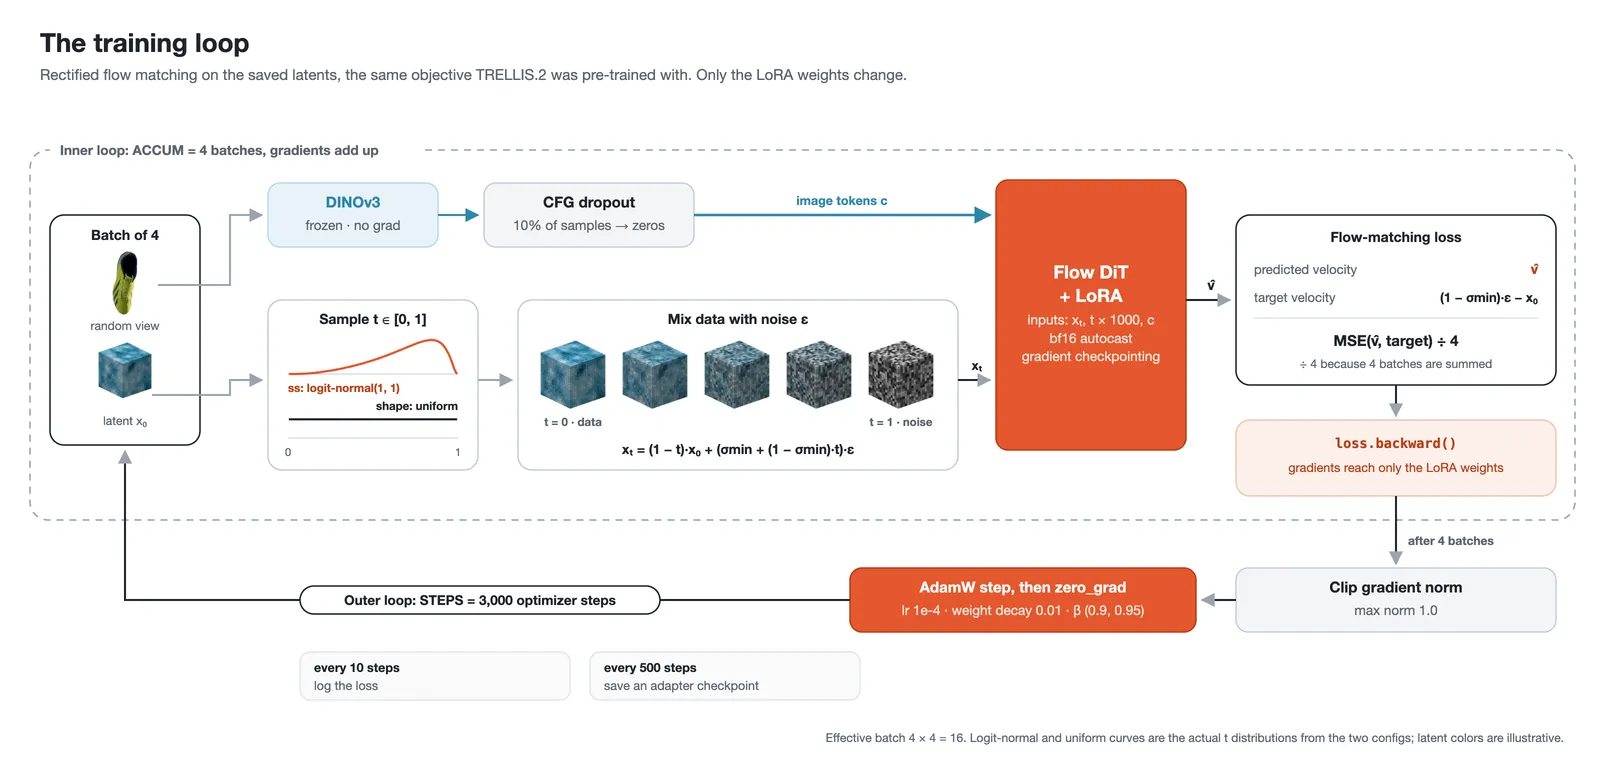
A função objetivo é o conhecido rectified flow matching, o mesmo objetivo que o TRELLIS.2 usou no pré-treinamento e que também aparece em geradores de imagem como Stable Diffusion 3 e Flux 2, o que o torna uma escolha adequada para o fine-tuning. Apenas os parâmetros LoRA dos dois DiTs são atualizados; todos os pesos originais permanecem congelados.
O otimizador é o AdamW com betas (0,9; 0,95), e um extrator de características DINOv3 codifica as imagens de condicionamento. Dentro do loop, amostra-se um passo de tempo t por amostra (logitNormal para o DiT de estrutura esparsa e uniforme para o DiT de forma, conforme a configuração do TRELLIS.2), gera-se ruído aleatório com o formato dos dados, mistura-se o dado limpo com o ruído conforme t (em que t = 0 significa dado quase limpo e t = 1 ruído puro) e o modelo prevê a velocidade em t multiplicado por 1000 para igualar as condições do pré-treinamento. A perda é o erro quadrático médio entre a velocidade prevista e a velocidade alvo, a derivada de x_t.
Cada passo do otimizador acumula gradientes de 4 lotes antes da atualização. Em cada lote, o DINOv3 codifica a imagem de condicionamento, e o dropout de classifier-free guidance (CFG) zera o condicionamento de uma fração aleatória p_uncond das amostras. A perda de flow matching é calculada com autocasting bf16; depois os gradientes são clipados para evitar atualizações muito grandes, o otimizador executa o passo, a perda é registrada a cada 10 passos e um checkpoint de adaptadores é salvo a cada 500 passos.
Resultados
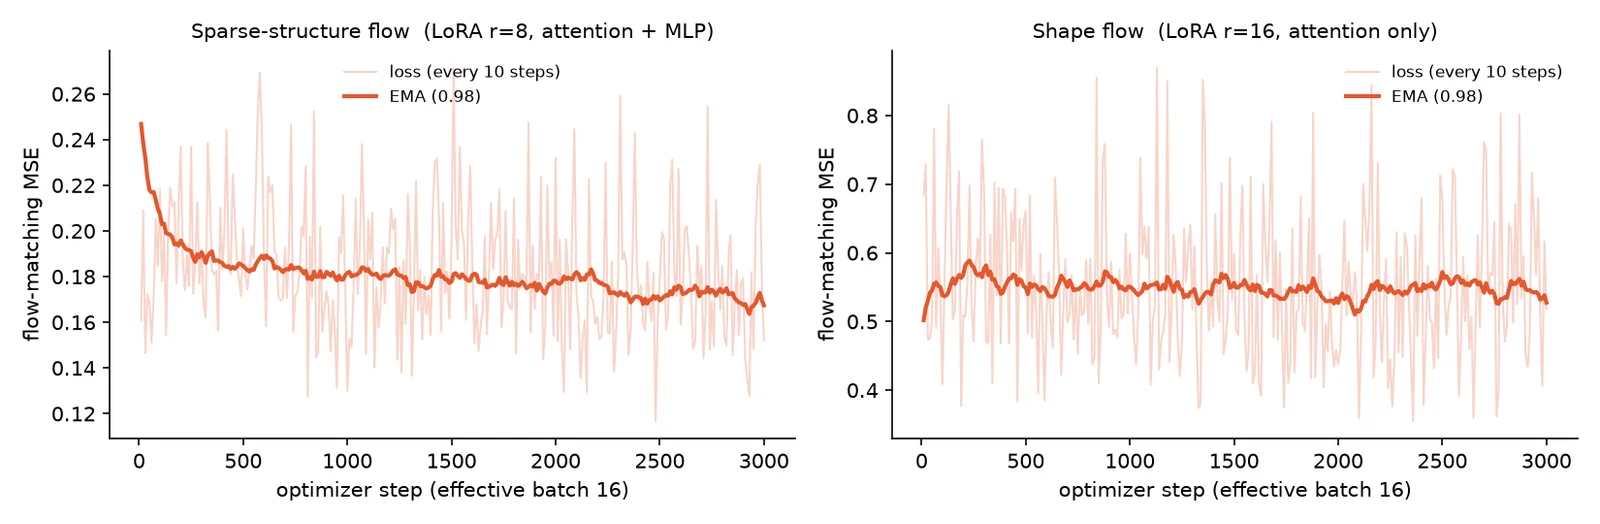
Dois adaptadores foram treinados, um por DiT, com os arquivos de configuração LoRA incluídos na imagem do contêiner (ss_flow_lora_gso.json e slat_flow_img2shape_lora_gso.json). Cada execução usou uma única A100 de 80 GB no Hugging Face Jobs: 7,2 horas para a estrutura esparsa e 3,6 horas para a forma.
A perda de treinamento do DiT de estrutura esparsa cai rápido no início e depois mais devagar, enquanto a do DiT de forma permanece aproximadamente no mesmo nível. Essas curvas descrevem o objetivo de treinamento, não a qualidade da geometria: a perda de flow matching varia com os objetos, o ruído e os passos de tempo amostrados, então verificar se o fine-tuning melhora a geometria exige comparar saídas nos objetos reservados.
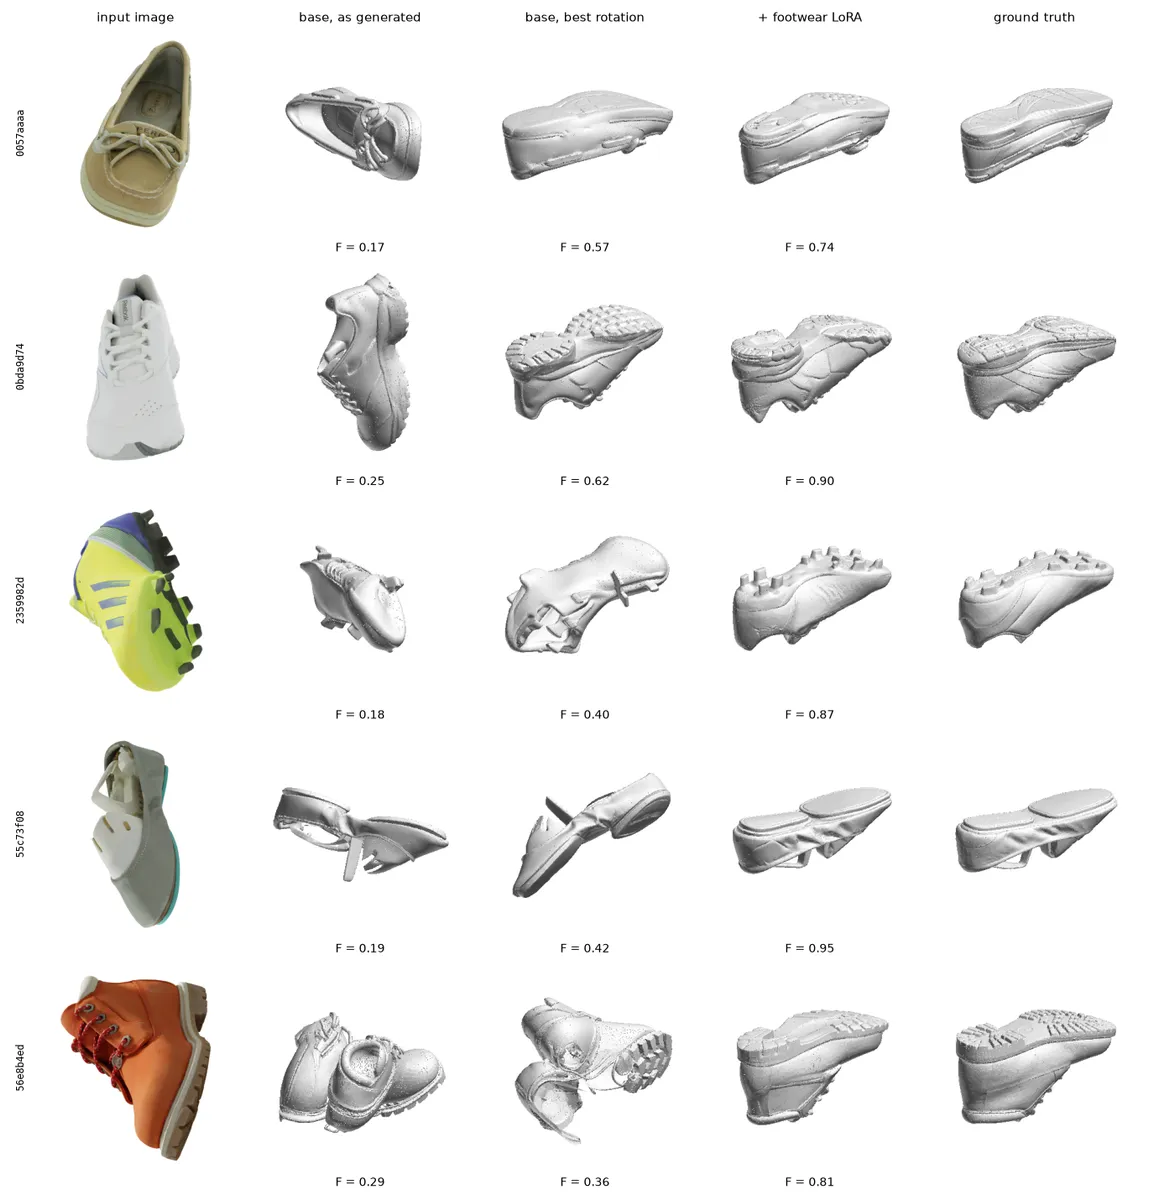
Uma figura comparativa cobre cinco dos nove objetos reservados e mostra a imagem de entrada, a saída do modelo base, a saída base após um ajuste de rotação, a saída com os adaptadores de calçados e o escaneamento de referência. Nesses exemplos, as solas do modelo ajustado ficam mais próximas dos escaneamentos.
Três métricas avaliam a geometria no conjunto de teste:
- Distância de Chamfer: a distância dos pontos de uma superfície aos pontos mais próximos da outra, medida nas duas direções; quanto menor, melhor.
- F-score @ 0,02: a combinação de precisão (quanto da superfície gerada está perto da referência) e recall (quanto da superfície de referência a gerada cobre), com o limiar de correspondência em 2% da diagonal da caixa delimitadora do escaneamento; quanto maior, melhor.
- Consistência de normais: o grau de concordância entre as direções das superfícies, sendo a normal de uma superfície o vetor perpendicular a ela; quanto maior, melhor.
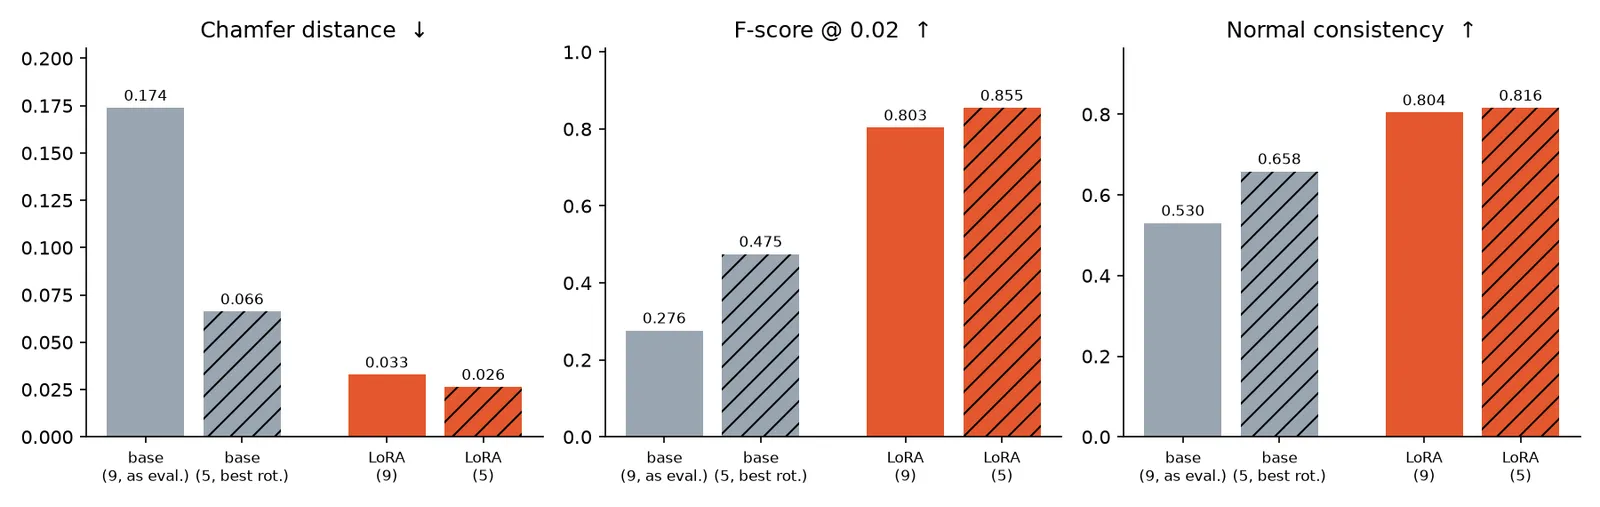
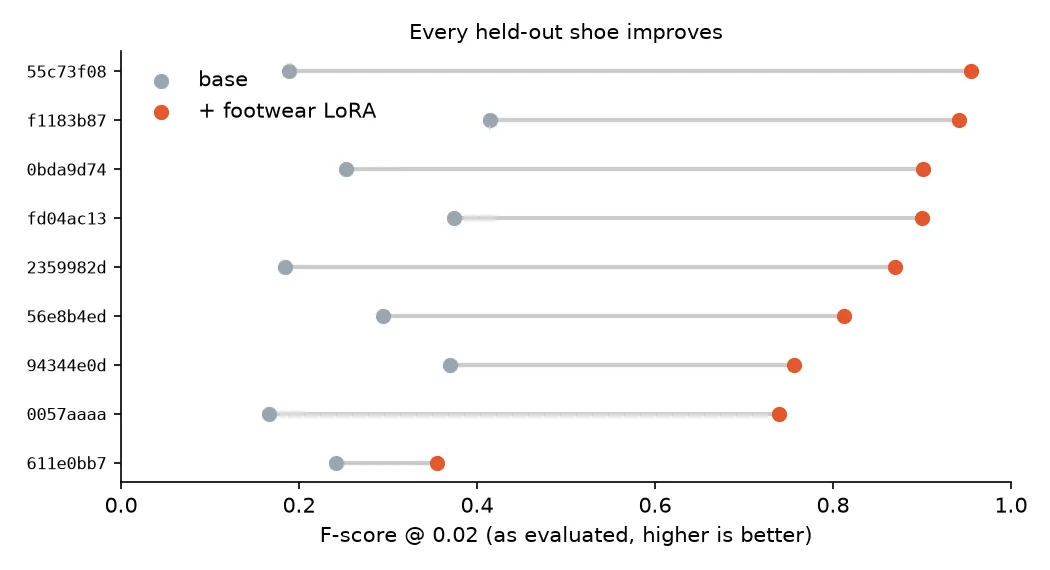
Na comparação dos nove objetos, o modelo base tem F-score médio de 0,276 contra 0,803 com os adaptadores de calçados; a distância de Chamfer cai de 0,174 para 0,033 e a consistência de normais sobe de 0,530 para 0,804. Com os dois adaptadores, o F-score melhora nos nove objetos reservados. As estatísticas completas de todas as execuções estão no espaço Trackio dos autores.
Próximos passos
A lição principal, segundo os autores, é escolher um alvo de treinamento coerente com o problema e com os dados disponíveis; neste caso, os estágios de estrutura e forma foram ajustados enquanto o de textura ficou congelado. Como próximos passos, eles mencionam verificar se as mesmas escolhas valem para outros modelos de geração 3D, como Pixal3D e UniLat3D, e para modelos de Gaussian splat e de geração de mundos, como HunyuanWorld 2.0 e NVIDIA Lyra 2.0, cujas representações e pipelines de treinamento podem exigir métodos diferentes.