Hugging Face ha publicado una guía que incluye scripts de ajuste fino e imágenes de contenedor para adaptar TRELLIS.2, un modelo popular de generación 3D, a los recursos 3D propios del usuario. Los mismos contenedores se ejecutan de forma local o en Hugging Face Jobs. Si el conjunto de datos ya está subido al Hugging Face Hub, el entrenamiento se puede lanzar con solo unos pocos argumentos; también es posible modificar directamente el repositorio que lo acompaña. Además, el artículo explica cómo funciona el script internamente.
Contexto
La generación 3D se emplea en robótica, simulación, medios y entretenimiento, donde los objetos generados deben obedecer reglas estrictas y las representaciones de datos deben estar estandarizadas. El campo está fragmentado: los formatos de archivo como GLB y PLY coexisten con representaciones como los campos de radiancia neuronal (NeRF) y el 3D Gaussian splatting (3DGS), cada una con sus propias ventajas y desventajas.
El TRELLIS original resolvió esta fragmentación con una representación latente unificada; sus decodificadores convierten esa representación al formato de salida que se necesite, de modo que no hacen falta modelos distintos para cada formato. El mismo equipo lanzó después TRELLIS.2, que representa la estructura 3D con mayor fidelidad, pero ninguno de los dos modelos incluye una forma sencilla de adaptarlo a una tarea concreta.
El problema a resolver
Un modelo de propósito general como TRELLIS.2 puede fallar en detalles que son importantes para una aplicación concreta, por ejemplo cuando un usuario necesita geometría precisa para modelos de mobiliario. El experimento descrito utiliza un subconjunto del conjunto de datos Google Scanned Objects (GSO) con 188 objetos de calzado. En las pruebas iniciales de los autores, el modelo preentrenado generaba zapatos que parecían correctos, pero con suelas incorrectas; el experimento comprueba si un LoRA puede hacer las suelas más precisas.
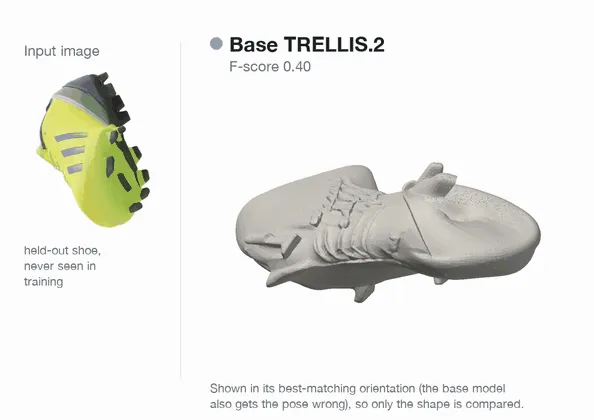
El objetivo declarado es mejorar TRELLIS.2 en una única categoría de objetos con GSO y mostrar qué componentes de la canalización conviene ajustar y cuáles dejar intactos. Como la canalización separa estructura, geometría detallada y materiales, solo se entrenan los componentes relevantes para la tarea. Los autores subrayan que decidir qué congelar importa tanto como decidir qué ajustar.
Herramientas
LoRA (low-rank adaptation, adaptación de bajo rango) entrena pequeñas matrices adaptadoras mientras los pesos originales permanecen congelados, lo que reduce el número de parámetros entrenables y la memoria necesaria para los gradientes y el estado del optimizador. Los adaptadores se añaden y entrenan con la biblioteca PEFT de Hugging Face.
Hugging Face Jobs ejecuta cargas de trabajo en contenedores sobre hardware en la nube y se usa tanto para el preprocesamiento como para el entrenamiento; se proporcionan comandos de Docker locales para quien prefiera usar su propia GPU. Los requisitos previos son un HF_TOKEN y una cuenta de Hugging Face con acceso a DINOv3, que es un modelo restringido (gated). Quien use un conjunto de datos propio debe subir sus mallas al Hub antes de empezar.
Cómo funciona TRELLIS.2
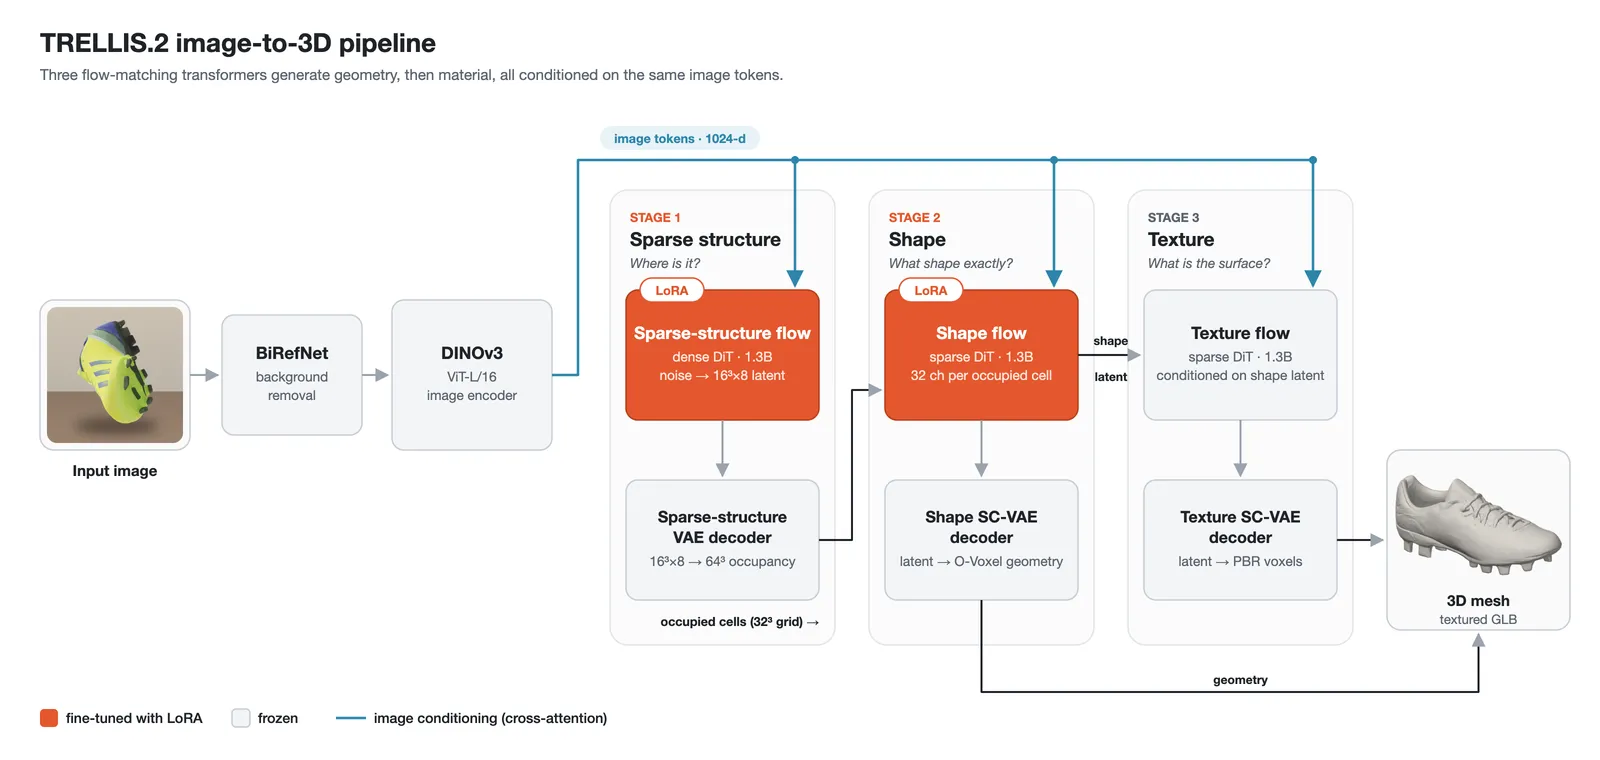
Antes de entrenar, el artículo recorre las cinco etapas principales de la canalización: eliminar el fondo de la imagen, codificar la imagen, predecir la estructura gruesa, generar la geometría detallada y generar los materiales; después, el resultado se exporta como una malla texturizada.
Codificación de la imagen de entrada
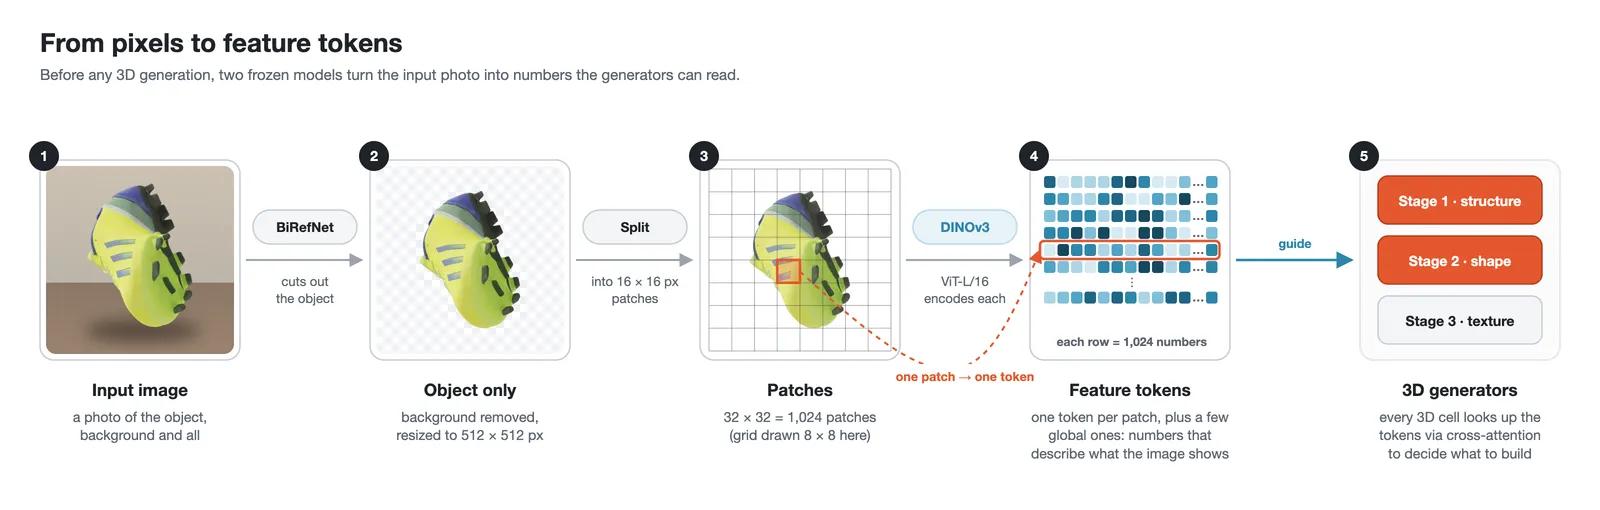
Primero, BiRefNet elimina el fondo de la imagen de entrada. Después, DINOv3-L la codifica en tokens de características que los modelos de generación usan para guiar el objeto 3D.
Generación de la estructura dispersa
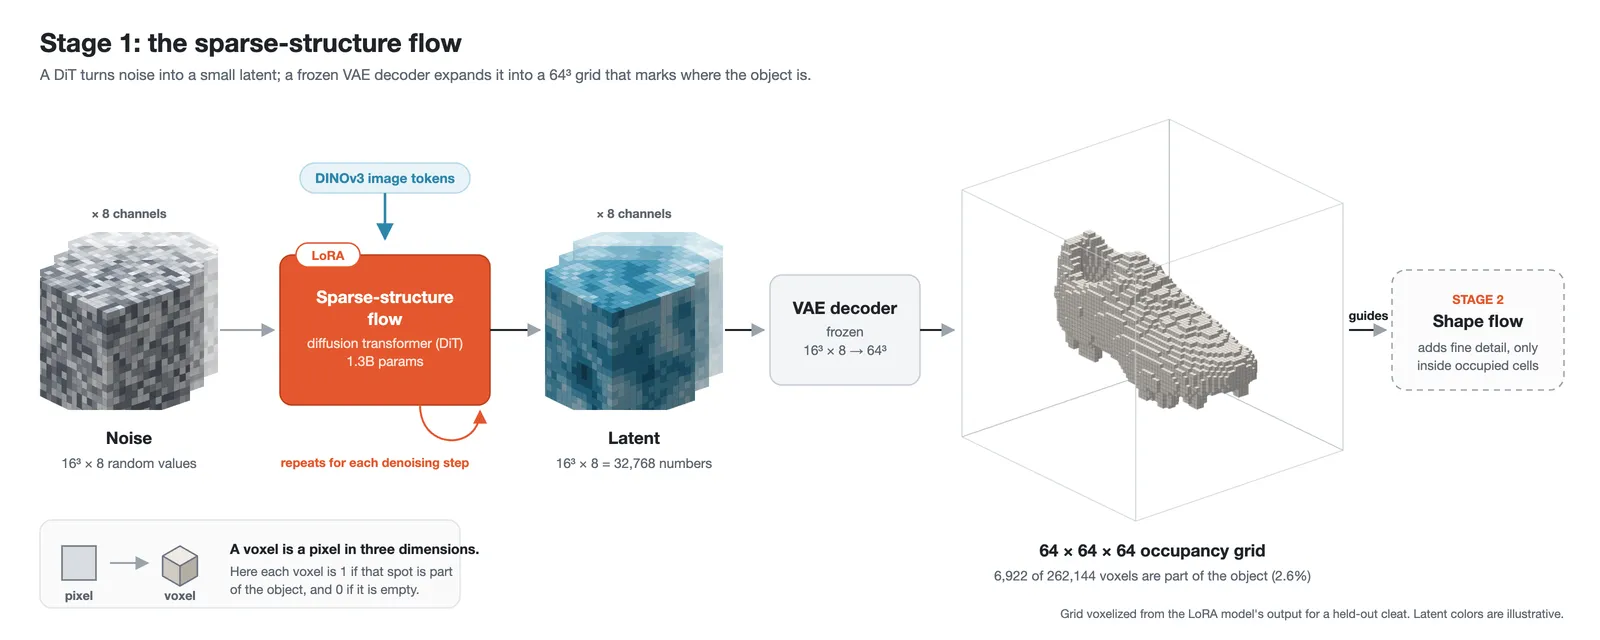
El DiT de flujo de estructura dispersa, un transformador de difusión, predice la forma gruesa del objeto como un latente pequeño de tamaño 16³ × 8. Un decodificador de autoencoder variacional (VAE) convierte ese latente en una cuadrícula de ocupación de 64 × 64 × 64, en la que cada vóxel, un píxel en tres dimensiones, indica si esa posición pertenece al objeto. Los adaptadores LoRA se añaden aquí porque la salida de esta etapa guía la etapa de geometría.
O-Voxel y latentes estructurados
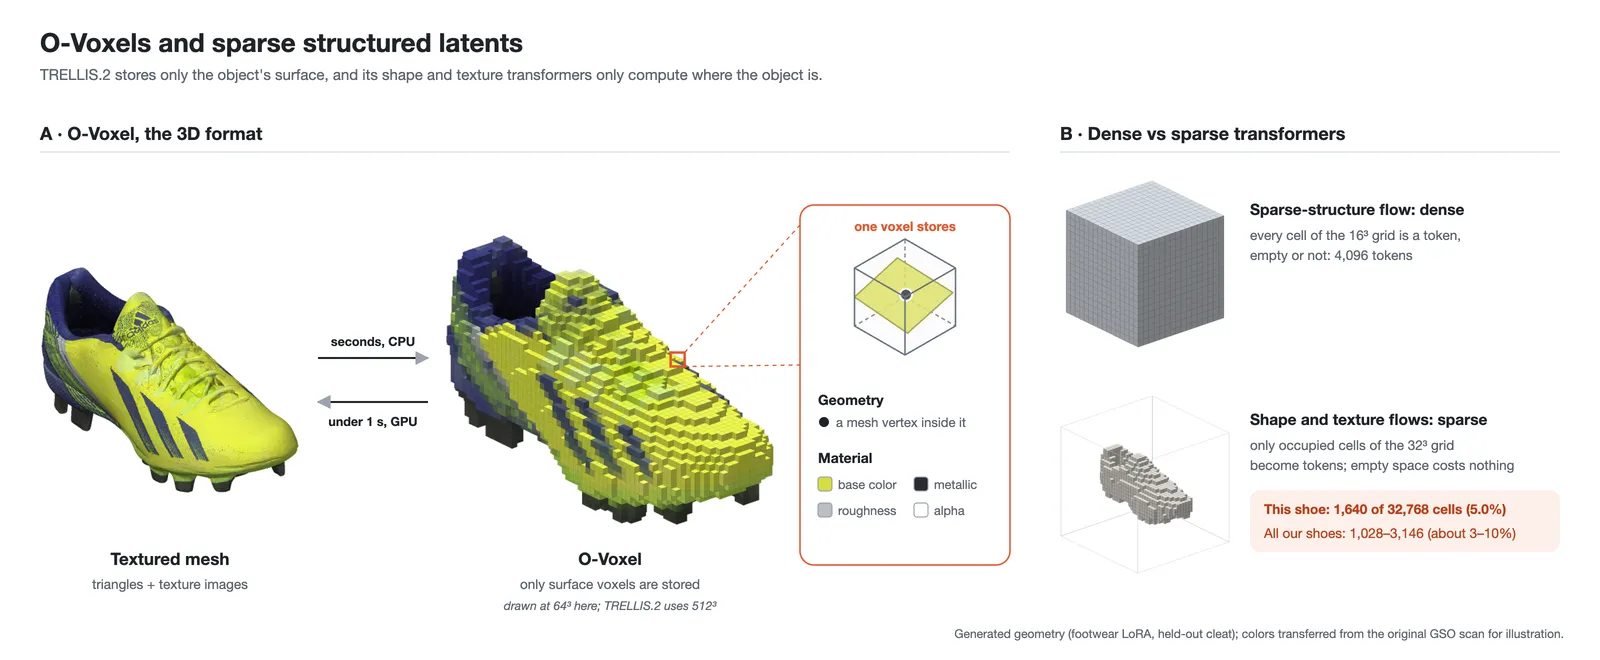
O-Voxel, el formato 3D de TRELLIS.2, es una cuadrícula de vóxeles dispersa que conserva solo los vóxeles de la superficie; cada uno guarda geometría local, como un vértice de malla, junto con atributos de material. Como el formato es compacto, una CPU convierte una malla a O-Voxel en segundos y una GPU realiza la conversión inversa en segundos.
Los latentes dispersos estructurados provienen de TRELLIS y almacenan los datos 3D en tensores dispersos para acelerar el cálculo. Solo se utiliza aproximadamente el 10% de los vóxeles de la cuadrícula, por lo que no se gasta cómputo en el espacio vacío. Por eso el DiT de flujo de forma y el DiT de flujo de textura son transformadores dispersos, mientras que el DiT de flujo de estructura dispersa es un transformador denso.
Generación de geometría (flujo de forma)
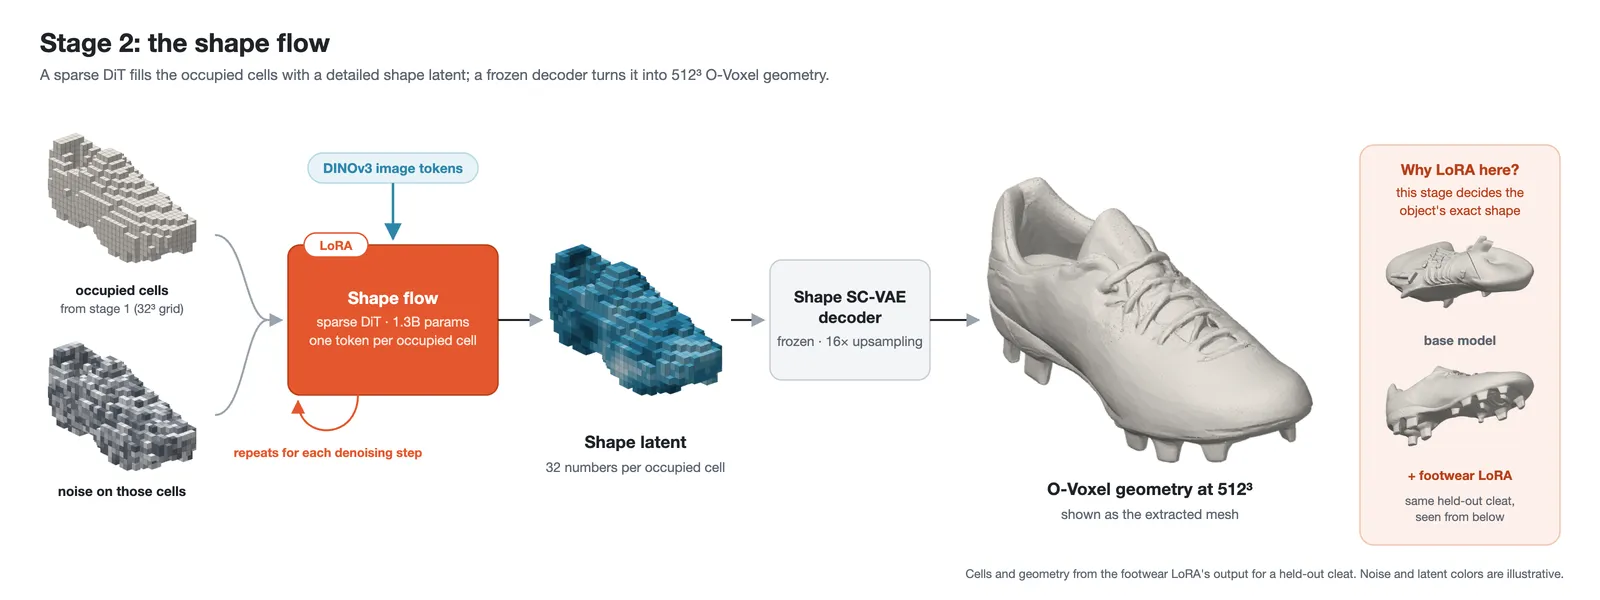
El DiT de flujo de forma toma la cuadrícula de ocupación y los tokens de características de DINOv3 para producir un latente, que un segundo decodificador VAE convierte en geometría O-Voxel con resolución de 512 × 512 × 512. Los adaptadores LoRA se añaden en esta etapa porque controla la forma del objeto.
Generación de materiales y creación de la malla
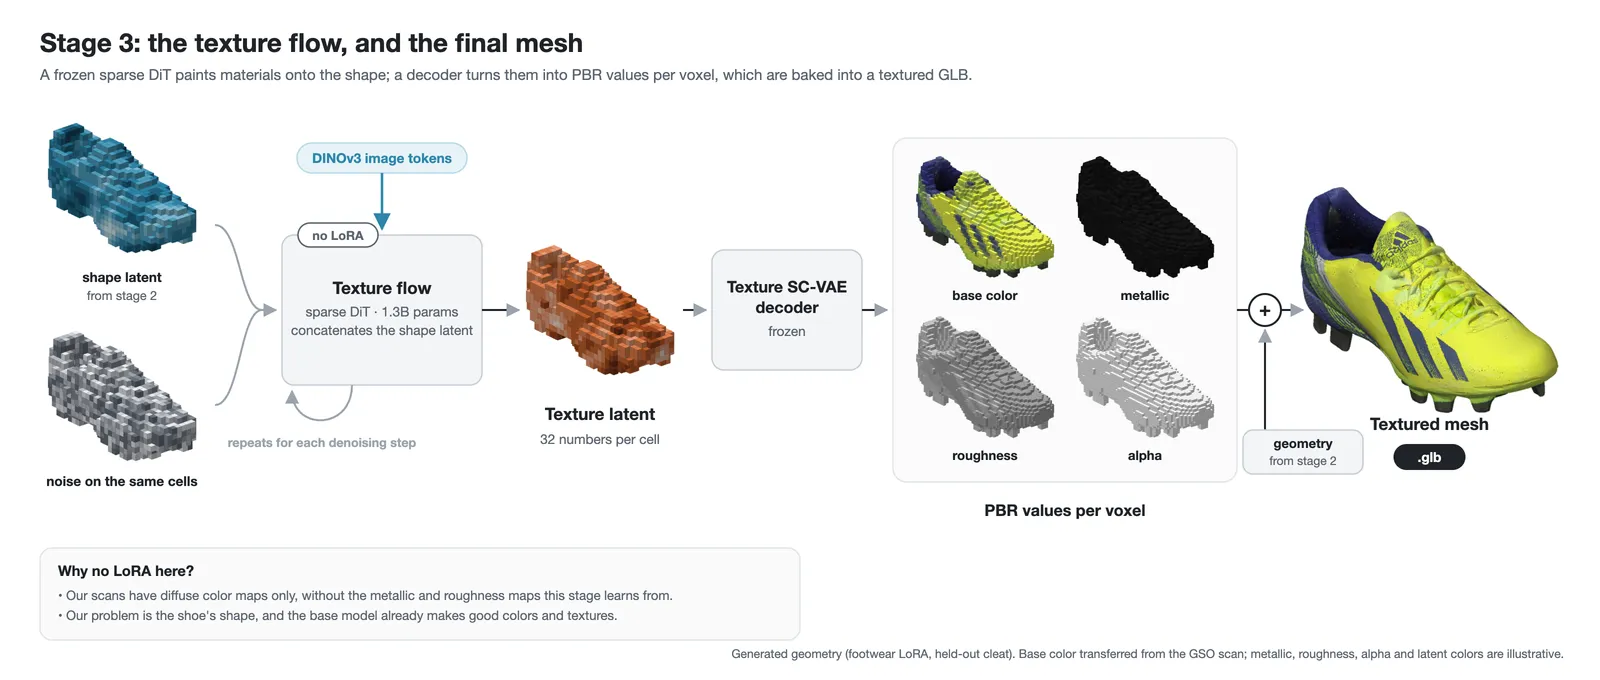
En la última etapa, el DiT de flujo de textura recibe el latente de forma y las características de DINOv3 y define los materiales y texturas de la superficie; un decodificador VAE produce valores de color base, metálico, rugosidad y alfa para cada vóxel. Aquí no se añaden adaptadores: el conjunto de datos ofrece mapas de color difuso, pero carece de los mapas de materiales separados que esta etapa necesita para entrenarse; además, el problema reside en la forma del zapato y el modelo base ya produce buenos colores y texturas. Después, la canalización combina la geometría y los atributos de material en una malla texturizada que se exporta como archivo GLB.
Planificación del ajuste fino
Los adaptadores se colocan únicamente en el DiT de flujo de estructura dispersa y en el DiT de flujo de forma, los dos DiT que controlan la forma y la geometría, mientras que el DiT de flujo de textura permanece congelado para conservar sus capacidades. Los mapas de color difuso del conjunto de datos incluyen iluminación integrada (baked), por lo que no son objetivos de entrenamiento válidos: entrenar el DiT de textura con ellos podría enseñarle a representar la iluminación como propiedad de la superficie y provocar olvido catastrófico de lo aprendido antes.
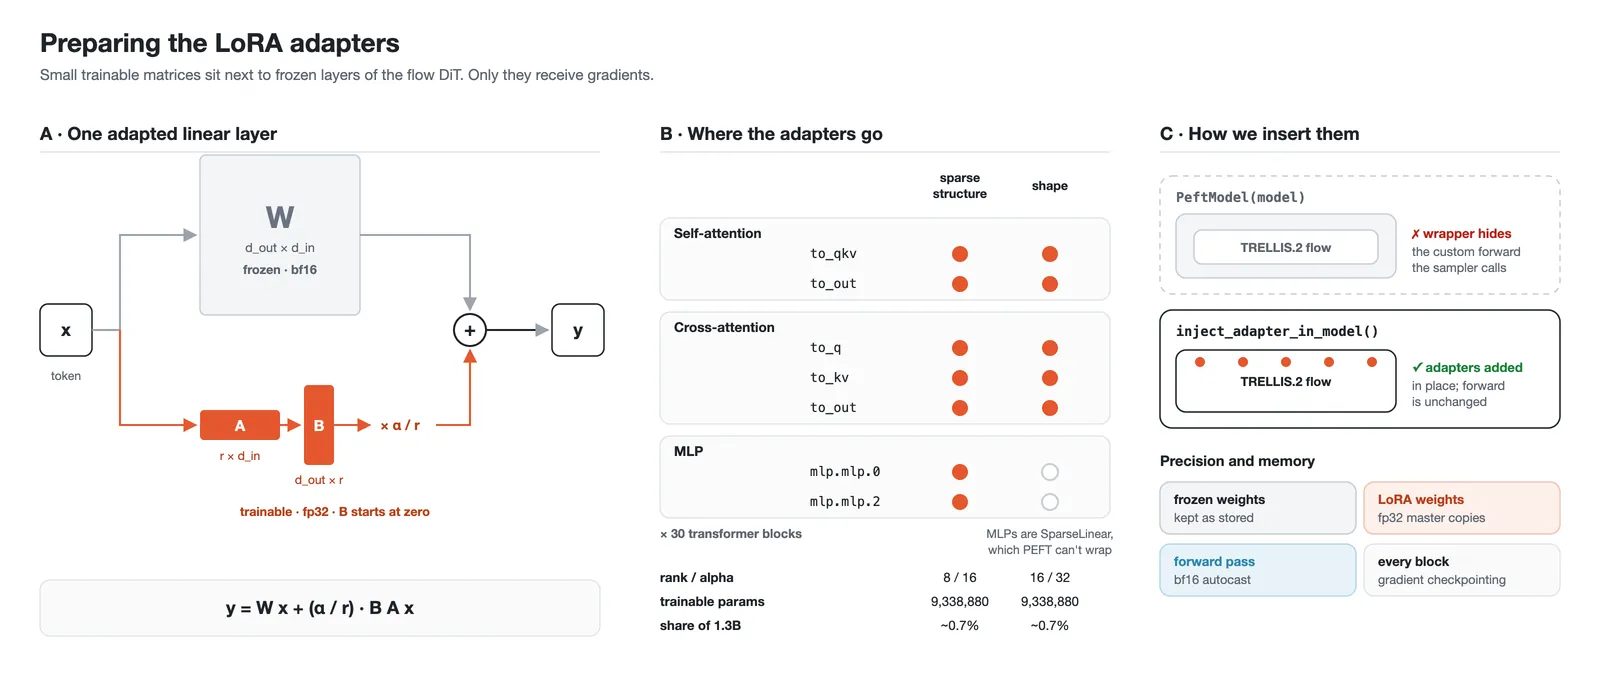
El subconjunto contiene 188 zapatos de los 1.030 objetos de GSO. A esa escala, LoRA es preferible al ajuste fino completo, que es mucho más costoso y puede sobrescribir los priors aprendidos del modelo. La configuración entrena unos 9,3 millones de parámetros de adaptador en total para ambos DiT: adaptadores de rango 8 en las capas de atención y feed-forward (MLP) del DiT de estructura dispersa, y adaptadores de rango 16 en las capas de atención del DiT de forma. El rango fija el tamaño de las matrices adaptadoras; un rango mayor permite aprender más.
Qué se ejecuta
Configurar un modelo 3D puede requerir muchas dependencias, por lo que se suministran dos imágenes Docker, una de preprocesamiento y otra de ajuste fino, que funcionan tanto en Hugging Face Jobs como en una máquina local. El flujo de trabajo es: dar a los contenedores acceso a los datos, fijar los parámetros de la tarea, ejecutar el contenedor de preprocesamiento y, después, el de ajuste fino, que entrena los adaptadores y los sube al Hub.
El experimento tiene tres partes: preparar los datos (convertir mallas GLB u OBJ a las representaciones latentes que usa TRELLIS.2 para entrenar y renderizar las imágenes de entrada), entrenar los adaptadores (un trabajo por DiT con el conjunto preparado y una configuración LoRA) y explicar el código que carga los datos, inserta los adaptadores y entrena los modelos. El conjunto preprocesado se guarda para que todas las ejecuciones de entrenamiento lo reutilicen.
Ejecución en Hugging Face Jobs
Preprocesamiento
El contenedor de preprocesamiento renderiza 16 vistas de cada objeto con Blender en modo sin pantalla mediante la utilidad xvfb-run; esas vistas actúan como imágenes de condicionamiento del entrenamiento LoRA. También procesa cada objeto con la canalización de preprocesamiento. Para los 188 objetos, la ejecución completa tardó aproximadamente 1 hora en un trabajo a100-large. Hay un conjunto de calzado publicado como ejemplo de salida intermedia y una versión compacta de la canalización de preprocesamiento en un repositorio complementario.
export HF_TOKEN=hf_xxx
# Replace your-username with your Hugging Face username
hf jobs run -d --flavor a100-large --timeout 6h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep \
    --meshes your-username/my-meshes \
    --push-to your-username/my-meshes-trellis2 \
    --private --holdout 0.05 \
    --views 16 --workers 8
Banderas clave para Hugging Face Jobs:
| bandera | significado |
|---|---|
| -d | Detach: imprime el ID del trabajo y la URL y termina; para seguir el trabajo, hf jobs logs -f |
| --flavor a100-large | El hardware; a100-large ofrece 80 GB y hf jobs hardware lista todas las opciones |
| --timeout 6h | El trabajo se detiene tras este tiempo; ambos comandos se reanudan: el preprocesamiento omite los objetos terminados y el entrenamiento continúa desde el punto de control más reciente en --push-to |
| --secrets HF_TOKEN | Envía el token (de HF_TOKEN o hf auth login) al trabajo como variable de entorno cifrada; no se escribe en la imagen |
| cr.hf.co/...:latest | La imagen a ejecutar; todo el texto posterior es el comando que se ejecuta dentro del contenedor |
El contenedor acepta argumentos adicionales, documentados aparte, que se aplican tanto si se ejecuta en Jobs como con Docker.
Ajuste fino con LoRA
El contenedor de entrenamiento carga el conjunto preparado y un preset o archivo de configuración, y registra las métricas de entrenamiento con Trackio, cuyo panel sirve para monitorizar la ejecución. Existen dos modos: 'ss' ajusta solo el DiT de flujo de estructura dispersa y 'shape' ajusta solo el DiT de flujo de forma; internamente, cada uno apunta a un config.json distinto.
export HF_TOKEN=hf_xxx  # Replace your-username with your Hugging Face username
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio

hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Si se define --push-to, el contenedor sube los puntos de control de los adaptadores al Hub. Para ajustar con el conjunto ya procesado que publicaron los autores, basta apuntar --latents a suvadityamuk/gso-footwear-trellis2-latents y subir el resultado a un repositorio propio:
export HF_TOKEN=hf_xxx
# Replace your-username with your Hugging Face username
# For the Sparse-Structure Flow DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
# For the Shape Flow DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Ejecución local con Docker
Los comandos y las banderas son los mismos que para Hugging Face Jobs; solo cambian las opciones de Docker.
# For preprocessing into latents
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN=hf_xxx \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep --meshes your-username/my-meshes --push-to your-username/my-meshes-trellis2
# For Sparse-structure Flow DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio
# For Shape Flow DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio
Para usar el conjunto ya preprocesado en una máquina local:
export HF_TOKEN=hf_xxx  # Replace your-username with your Hugging Face username
# For Sparse-structure Flow DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
# For Shape Flow DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
Los adaptadores LoRA entrenados están publicados en el repositorio suvadityamuk/trellis-2-finetune-gso.
Dentro de la canalización de entrenamiento
Preprocesamiento a latentes
Los codificadores congelados de TRELLIS.2 convierten las mallas de entrada en latentes de entrenamiento, que se guardan para que las ejecuciones posteriores no tengan que volver a codificar las mallas. También se renderizan 16 vistas por objeto en Blender; durante el entrenamiento se elige una vista aleatoria por muestra como imagen de condicionamiento. Nueve de los 188 objetos se reservan para evaluación y los otros 179 se usan para entrenar, de modo que los objetos reservados muestran si los adaptadores funcionan sobre objetos que el modelo no vio durante el entrenamiento.
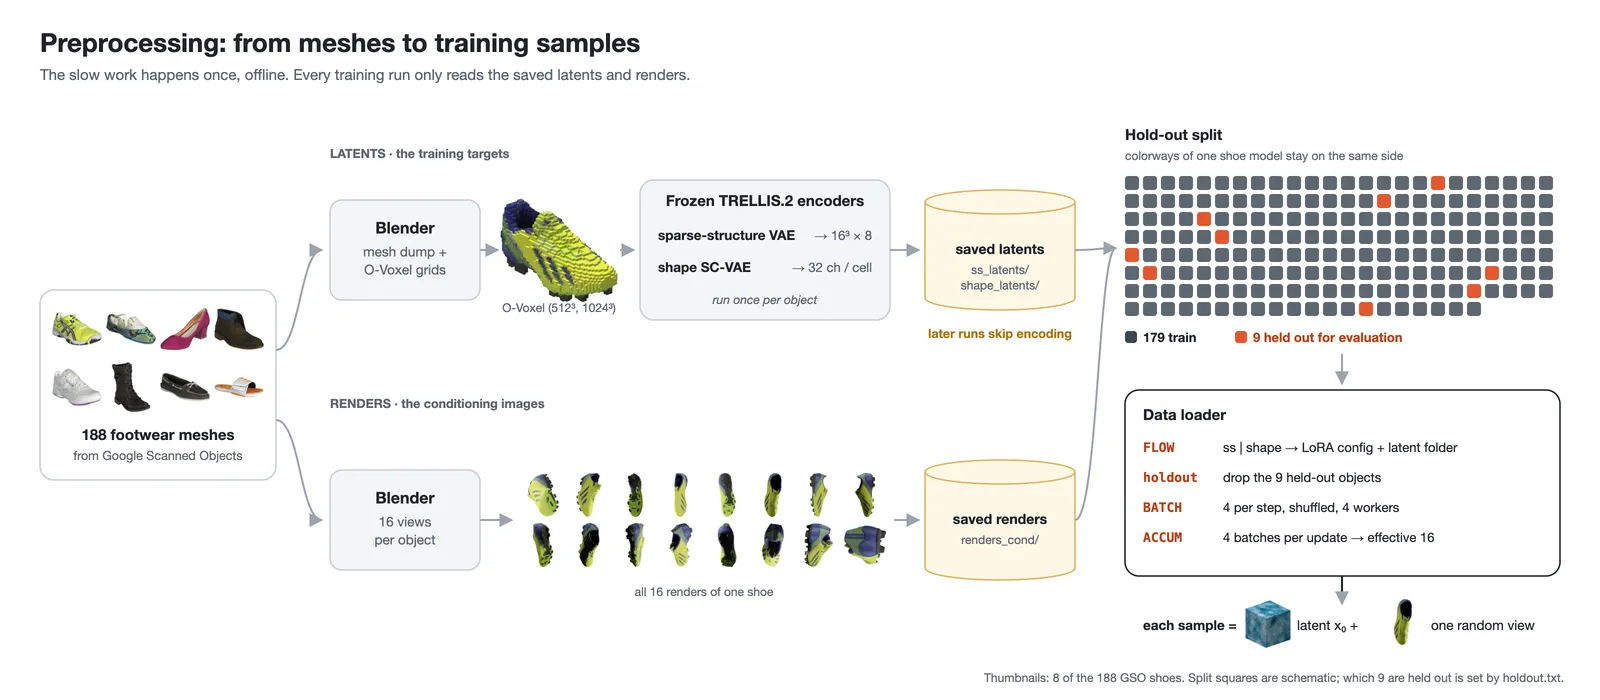
El código de preparación elige el DiT mediante FLOW ('ss' o 'shape'), fija el número de pasos del optimizador con STEPS, carga el archivo de configuración LoRA del DiT elegido (configs/lora/ss_flow_lora_gso.json o configs/lora/slat_flow_img2shape_lora_gso.json), construye el conjunto de datos en formato TRELLIS.2 a partir de los latentes guardados (ss_latents/ss_enc_conv3d_16l8_fp16_64 o shape_latents/shape_enc_next_dc_f16c32_fp16_512), elimina los objetos reservados y crea el cargador de datos. Un tamaño de lote de 4 con 4 pasos de acumulación de gradiente da un tamaño de lote efectivo de 16.
Preparación de los adaptadores LoRA
La biblioteca peft inserta los adaptadores LoRA en las capas seleccionadas. Como TRELLIS.2 usa un forward pass personalizado, el envoltorio estándar PeftModel() no sirve; en su lugar se llama a inject_adapter_in_model(), que añade los adaptadores directamente y conserva la interfaz personalizada del modelo. Los pesos entrenables del adaptador se mantienen en coma flotante de 32 bits (fp32) por estabilidad numérica, y el forward pass usa autocasting bfloat16 (bf16), que reduce el uso de memoria en algunas operaciones sin cambiar cómo se almacenan los pesos congelados del backbone. El gradient checkpointing se activa en cada bloque con block.use_checkpoint = True.
Entrenamiento
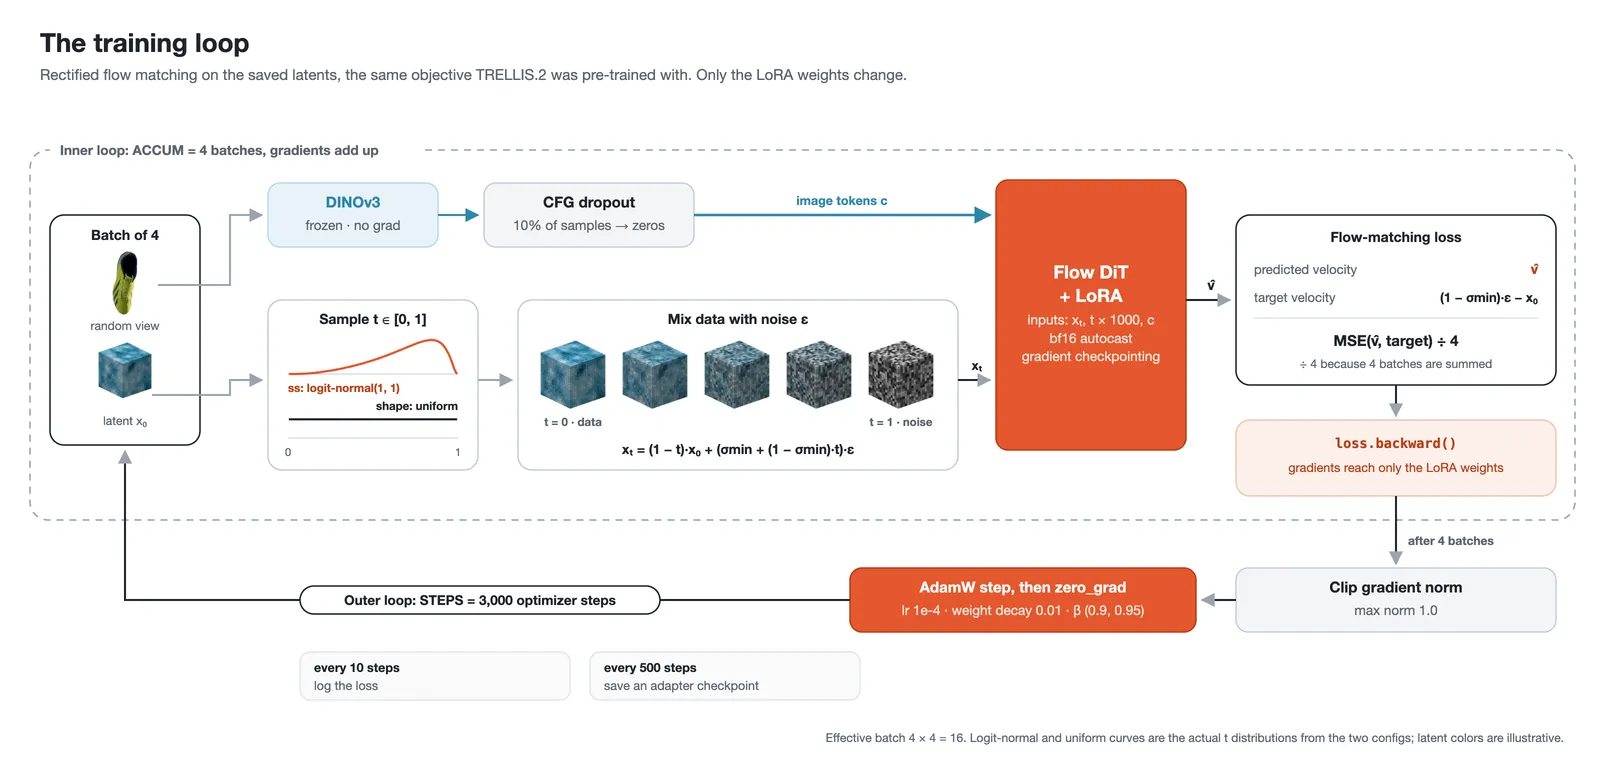
La función objetivo es el clásico rectified flow matching, el mismo objetivo que TRELLIS.2 usó en su preentrenamiento y que también aparece en generadores de imagen como Stable Diffusion 3 y Flux 2, por lo que es una elección adecuada para el ajuste fino. Solo se actualizan los parámetros LoRA de los dos DiT; todos los pesos originales permanecen congelados.
El optimizador es AdamW con betas (0,9; 0,95), y un extractor de características DINOv3 codifica las imágenes de condicionamiento. Dentro del bucle se muestrea un paso temporal t por muestra (logitNormal para el DiT de estructura dispersa y uniforme para el DiT de forma, según la configuración de TRELLIS.2), se genera ruido aleatorio con la forma de los datos, se mezclan los datos limpios con el ruido según t (donde t = 0 corresponde a datos casi limpios y t = 1 a ruido puro) y el modelo predice la velocidad en t multiplicado por 1000 para igualar las condiciones del preentrenamiento. La pérdida es el error cuadrático medio entre la velocidad predicha y la velocidad objetivo, la derivada de x_t.
Cada paso del optimizador acumula gradientes de 4 lotes antes de actualizar. En cada lote, DINOv3 codifica la imagen de condicionamiento, y el dropout de classifier-free guidance (CFG) pone a cero el condicionamiento de una fracción aleatoria p_uncond de las muestras. La pérdida de flow matching se calcula con autocasting bf16; después se recortan los gradientes para evitar actualizaciones muy grandes, se ejecuta el paso del optimizador, la pérdida se registra cada 10 pasos y se guarda un punto de control de adaptadores cada 500 pasos.
Resultados
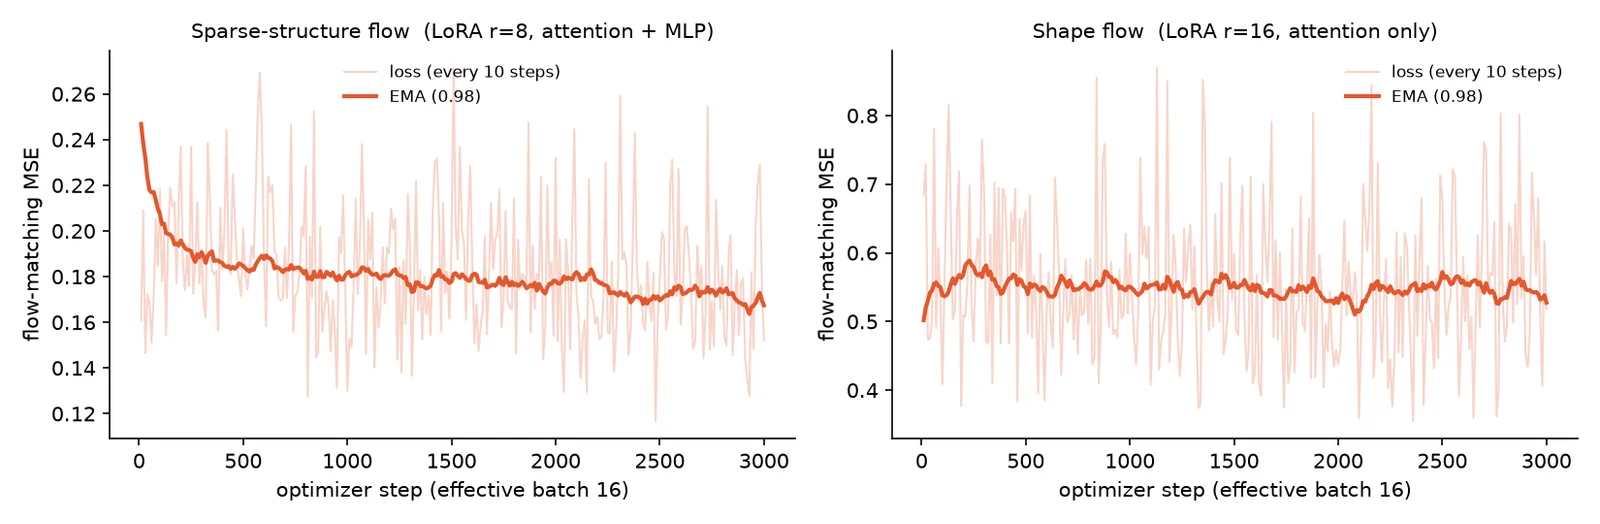
Se entrenaron dos adaptadores, uno por DiT, con los archivos de configuración LoRA incluidos en la imagen del contenedor (ss_flow_lora_gso.json y slat_flow_img2shape_lora_gso.json). Cada ejecución usó una sola A100 de 80 GB en Hugging Face Jobs: 7,2 horas para la estructura dispersa y 3,6 horas para la forma.
La pérdida de entrenamiento del DiT de estructura dispersa cae rápido al principio y luego más despacio, mientras que la del DiT de forma se mantiene aproximadamente en el mismo nivel. Estas curvas describen el objetivo de entrenamiento, no la calidad de la geometría: la pérdida de flow matching varía con los objetos, el ruido y los pasos temporales muestreados, de modo que para comprobar si el ajuste fino mejora la geometría hay que comparar salidas en los objetos reservados.
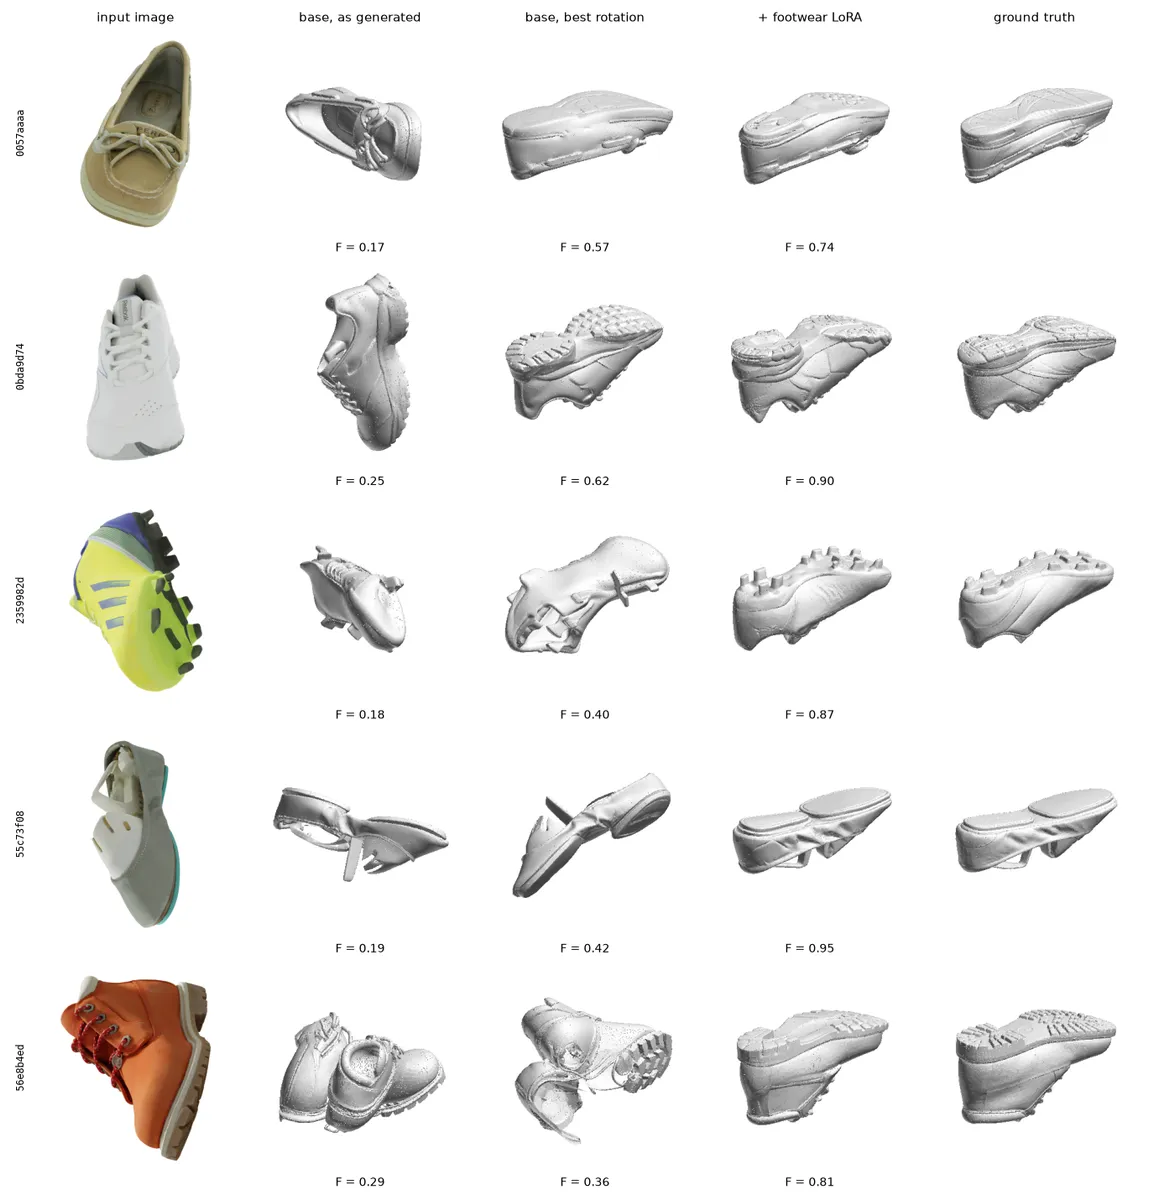
Una figura comparativa abarca cinco de los nueve objetos reservados y muestra la imagen de entrada, la salida del modelo base, la salida base tras un ajuste de rotación, la salida con los adaptadores de calzado y el escaneo de referencia. En estos ejemplos, las suelas del modelo ajustado se acercan más a los escaneos.
Tres métricas evalúan la geometría en el conjunto de prueba:
- Distancia de Chamfer: la distancia de los puntos de una superficie a los puntos más cercanos de la otra, medida en ambas direcciones; cuanto menor, mejor.
- F-score @ 0,02: la combinación de precisión (qué parte de la superficie generada está cerca de la referencia) y recall (qué parte de la superficie de referencia cubre la generada), con un umbral de coincidencia del 2% de la diagonal de la caja envolvente del escaneo; cuanto mayor, mejor.
- Consistencia de normales: el grado de acuerdo entre las direcciones de las superficies, siendo la normal de una superficie el vector perpendicular a ella; cuanto mayor, mejor.
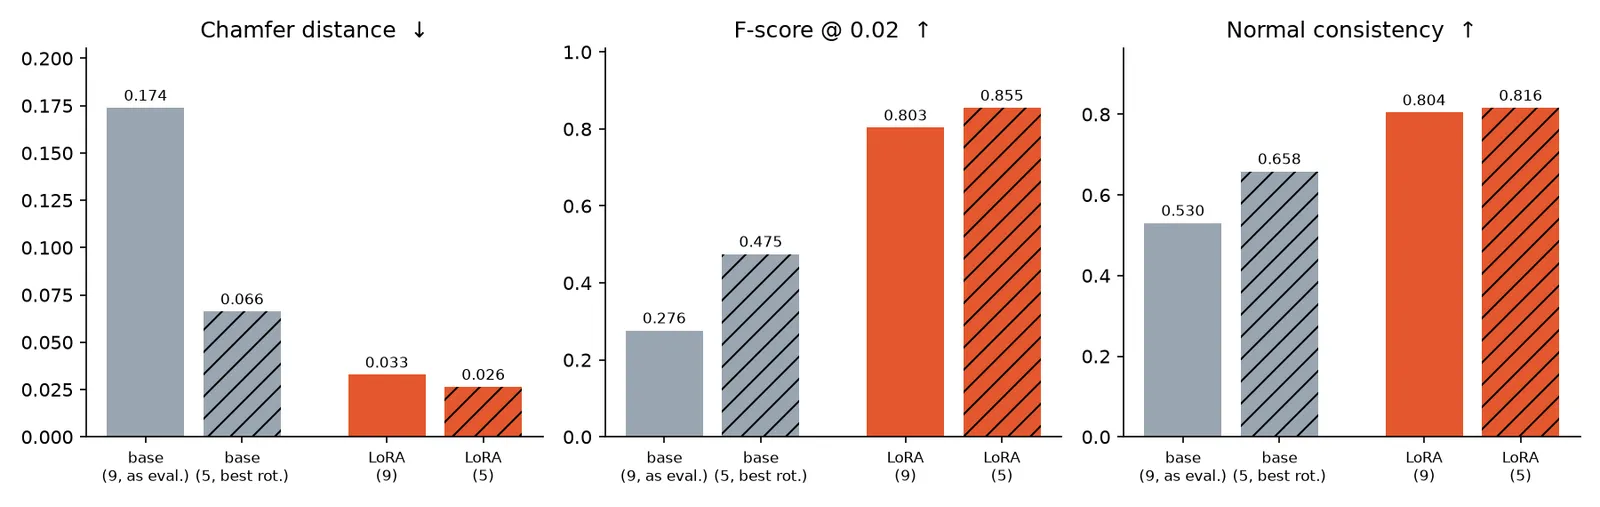
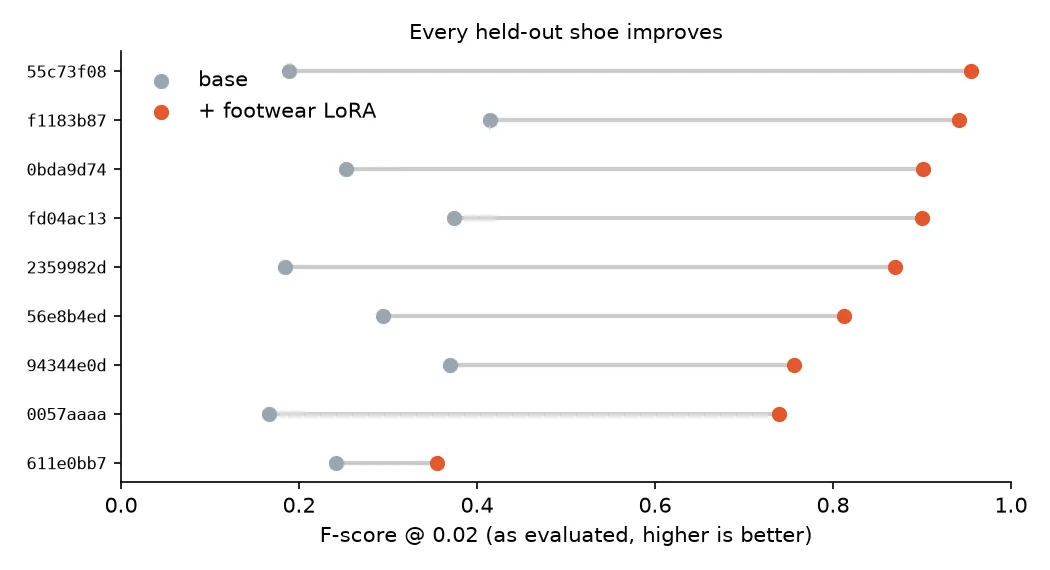
En la comparación de los nueve objetos, el modelo base obtiene un F-score medio de 0,276 frente a 0,803 con los adaptadores de calzado; la distancia de Chamfer baja de 0,174 a 0,033 y la consistencia de normales sube de 0,530 a 0,804. Con ambos adaptadores, el F-score mejora en los nueve objetos reservados. Las estadísticas completas de todas las ejecuciones están en el espacio de Trackio de los autores.
Próximos pasos
La lección principal, según los autores, es elegir un objetivo de entrenamiento coherente con el problema y con los datos disponibles; en este caso se ajustaron las etapas de estructura y forma y se congeló la de textura. Como siguientes pasos mencionan comprobar si las mismas decisiones sirven para otros modelos de generación 3D, como Pixal3D y UniLat3D, y para modelos de Gaussian splat y de generación de mundos como HunyuanWorld 2.0 y NVIDIA Lyra 2.0, cuyas representaciones y canalizaciones de entrenamiento pueden requerir métodos distintos.