Um benchmark de solicitações de mudança escritas por especialistas
Um relatório técnico de novembro de 2026 da Toptal ExpertCrowd (arXiv:2611.13246v1 [cs.AI], 09.11.2026) apresenta o ExpertCrowd-SWE (EC-SWE), um benchmark de 100 tarefas de engenharia de software multifuncionais e escritas por especialistas, criado para avaliar agentes de programação autônomos em bases de código grandes e desconhecidas. Os autores são Josip Vrdoljak, Akash Singh, John Lorenzo, Bas Steunebrink, Achille Nicoletti, Alex Yarotsky e Sam Pigott.
Cada tarefa é uma solicitação de mudança escrita por um engenheiro em exercício sobre um commit fixado de um repositório real. Ela vem acompanhada de uma solução de referência selada e de um avaliador específico da tarefa, cujos critérios ponderados — em sua maioria executáveis — concedem crédito parcial; bloqueios obrigatórios e portões de aprovação/reprovação codificam o que um mantenedor se recusaria a fazer merge. As tarefas abrangem 87 projetos de código aberto e 11 linguagens. O ticket mediano tem 148 palavras, enquanto a solução de referência mediana altera 471 linhas em uma mediana de 4,5 arquivos. Cada imagem de tarefa é calibrada antes do lançamento para que a solução de referência marque 1,0 e tanto o repositório intacto quanto uma mudança inerte marquem 0, e quase metade das tarefas inclui patches de controle alternativos, preguiçosos e adversariais que o avaliador precisa classificar corretamente. As 100 tarefas finais foram escolhidas pelo grau de dificuldade frente aos modelos de fronteira atuais.
O escopo é deliberadamente estreito: o benchmark pergunta se um agente, trabalhando de forma autônoma em um repositório isolado e offline, consegue produzir uma mudança que o avaliador de um mantenedor especialista aceite. Os autores enfatizam que o leaderboard compara modelos sob condições compartilhadas de tarefa, prompt, sandbox e orçamento; não é um ranking de produtos de programação nem da qualidade geral dos modelos.
Por que um novo benchmark
O relatório argumenta que a receita dominante, introduzida pelo SWE-bench, extrai correções que sofreram merge em repositórios públicos do GitHub e avalia cada tarefa com os testes entregues junto com a correção. Segundo os autores, isso tem duas fragilidades: as correções, discussões e testes são públicos e plausivelmente presentes nos corpora de pré-treinamento, de modo que uma pontuação alta pode refletir memorização em vez de resolução de problemas; e os testes herdados foram escritos para confirmar um patch específico, podendo assim rejeitar alternativas válidas ou aceitar soluções incompletas.
O relatório relembra dois eventos de 2026 que tornaram esses problemas difíceis de ignorar. Em fevereiro, a OpenAI deixou de reportar o SWE-bench Verified depois que uma auditoria encontrou problemas materiais nos testes ou enunciados de 59,4% dos 138 problemas auditados, junto com evidências de que modelos de fronteira haviam memorizado patches de referência. Em julho, uma auditoria subsequente estimou que cerca de 30% das tarefas do SWE-Bench Pro estavam quebradas, e a OpenAI retirou sua recomendação anterior daquele benchmark, pedindo avaliações construídas com desenvolvedores de software experientes e supervisão humana em todas as etapas.
Benchmarks com tarefas escritas, e não extraídas, lidam com a contaminação, mas os autores observam que os agentes mais fortes agora também se aglomeram no topo desses leaderboards: no DeepSWE v1.1, Claude Opus 5.5, GPT-6 Astra, DeepSeek V4.1 Flash e Gemini 3.8 Flash ficam separados por apenas 0,9 ponto entre si (72,3% a 71,4%). O EC-SWE se posiciona como um benchmark de mudanças que nenhum modelo viu resolvidas, escritas para o benchmark por engenheiros que conhecem a base de código, nunca publicadas como correções, avaliadas do jeito que um mantenedor revisa um pull request e mantidas majoritariamente privadas.
Como as tarefas são produzidas
Os autores das tarefas são engenheiros da rede de talentos da Toptal, descrita como mais de 30.000 especialistas verificados e especializados, que se candidatam a uma de quatro áreas: compiladores e ferramentas de linguagem; sistemas, backend e redes; bancos de dados e sistemas de armazenamento; e SRE, DevOps e infraestrutura. Trinta e nove especialistas contribuíram com a autoria de tarefas; após controle de qualidade, verificação e seleção, as 100 tarefas finais vieram de 17 deles.
A autoria segue um fluxo de trabalho em duas etapas, começando pelo rascunho. Na etapa de rascunho, o autor submete o repositório e o hash exato do commit em que ele é fixado (nunca um nome de branch), o prompt escrito como um ticket e um plano de avaliação que nomeia as verificações e quais delas são obrigatórias; um revisor aprova ou devolve o material, e rascunhos são rejeitados por serem ilegíveis, prescreverem uma implementação, carecerem de plano de avaliação ou dependerem apenas de um juiz de IA, ou por proporem um problema que o autor não resolveu. Na etapa de construção, o autor implementa a tarefa no template de programação HUD, confirma que a solução de referência marca 100% enquanto um checkout inalterado marca 0%, e executa a tarefa cinco vezes contra um modelo de fronteira (Claude Opus 5, limite de 100 passos); cinco execuções com zero são tratadas como possível sinal de um avaliador quebrado. Assistência de IA é permitida para a montagem do ambiente, mas não para a ideia da tarefa nem para a solução de referência. Os motivos registrados para rejeição de tarefas submetidas incluem soluções de referência nunca testadas (4), avaliadores fracos, quebrados ou baseados só em opinião (3), tarefas ou repositórios pequenos demais (3), submissões incompletas (2) e uma tarefa impossível.
As tarefas vêm de quatro rotas sob regras comuns de contaminação: nunca basear uma tarefa em um bug já corrigido publicamente, nunca usar código de empregador ou cliente, manter a própria mudança da tarefa inédita e usar código proprietário somente quando o autor é o dono e concede os direitos. As rotas são mudanças baseadas na experiência de especialistas em repositórios públicos, tarefas motivadas por issues upstream antigas e não resolvidas, forks com problemas adicionados por especialistas e bases de código pertencentes ao próprio especialista. No conjunto lançado, 98 tarefas são mudanças novas em projetos públicos de código aberto sem substrato adicionado; uma tarefa, um preflight de migração de chave estrangeira do PostgreSQL no SQLAlchemy, adiciona um patch de substrato escrito por especialista de cerca de 250 linhas; e uma, um pipeline de webhooks de pagamentos, é construída sobre uma base de código pertencente ao seu autor. Os commits de base são recentes: 82 dos 100 foram commitados em agosto ou setembro de 2026, com data mediana de 04.09.2026, e pelo menos 97 estão no branch padrão do upstream.
Cada tarefa entrega quatro artefatos: um prompt composto pelo ticket do autor mais um preâmbulo de ambiente (localização do repositório, aproximadamente duas vCPUs e um limite rígido de memória, um sandbox offline, como iniciar os serviços de apoio de que os testes do próprio repositório precisam e a instrução de que testes ocultos avaliarão o trabalho e que os testes existentes não devem ser modificados); um ambiente Docker contendo o repositório no commit fixado com seu histórico encapsulado, toolchains e um cache de dependências pré-preenchido, com shells de agente rodando como usuário sem privilégios e todos os arquivos em formato de resposta sob um diretório exclusivo do root; a solução de referência do autor (task/gold.diff), selada dentro da imagem; e um avaliador que executa hermeticamente, iniciando sua própria instância de qualquer serviço de apoio necessário, como Redis ou um banco de dados, em uma porta privada.
Avaliação
Cada avaliador é uma lista de critérios nomeados com pesos que somam exatamente 1,0 em todas as 100 tarefas lançadas. A maioria dos critérios é de verificações executáveis do comportamento observável através da interface pública da própria biblioteca ou serviço; verificações internas de implementação são evitadas para que qualquer solução razoável possa obter crédito total. Três tipos de regra se combinam: critérios ponderados cujas pontuações somam crédito parcial; bloqueios, critérios obrigatórios que limitam a pontuação de uma execução abaixo do crédito total (por exemplo, em 0,60) em vez de zerá-la; e portões, pré-condições de aprovação/reprovação sem peso que zeram a execução se violadas, como exigir que a suíte de testes do próprio repositório esteja verde e intacta. Quatorze tarefas lançadas usam portões.
Os autores justificam o crédito parcial com seus próprios dados: apenas 1,0% a 3,8% das execuções do Gemini 3.8 Flash, Qwen 3.8 Max, DeepSeek V4.1 Flash e Grok 4.6 obtêm crédito total, de modo que uma avaliação binária comprimiria os quatro em uma faixa de 1% a 4%, enquanto o crédito parcial os espalha entre 32,2% e 40,0%. Dez tarefas incluem um critério julgado por LLM que carrega de 2% a 25% do peso da tarefa, 8,5% em média entre as dez e 0,85% do peso total do benchmark; os autores dizem que os critérios julgados por LLM foram mantidos abaixo de 10% da nota total por causa de possíveis vieses e problemas de confiabilidade, e as 90 tarefas restantes são avaliadas inteiramente por verificações determinísticas.
Garantia de qualidade e controles de contaminação
A qualidade é garantida no momento da construção, por meio de patches de controle e de revisão por engenheiros sêniores. A construção da imagem falha a menos que a solução de referência marque exatamente 1,00 com cada critério passando individualmente e que tanto o checkout intacto quanto uma mudança inerte, apenas de comentários, marquem 0,00 com todos os critérios falhando. Patches de controle explícitos precisam ser classificados corretamente: soluções alternativas válidas que devem passar (35 tarefas), patches adversariais ou de trapaça que devem falhar, por exemplo os que editam testes, tratam entradas avaliadas como caso especial ou desativam o recurso sob teste (30 tarefas), e patches preguiçosos ou sem efeito que devem marcar pontuação baixa (42 tarefas). Cada tarefa passou por verificação de qualidade de um engenheiro sênior, que examinou seu prompt, ambiente, solução de referência, avaliador e execuções diagnósticas com modelo de fronteira; apenas as tarefas aprovadas receberam o status de "verified" na plataforma.
Sobre contaminação, os autores relatam que a mudança de cada tarefa é inédita; 76 das 100 tarefas são mantidas fora do conjunto público; e cada tarefa foi triada quanto a sobreposição com 499.647 registros de tarefas de 93 conjuntos de dados públicos de benchmarks de engenharia de software, por correspondência de commits de repositório e identificadores de tarefa e por similaridade semântica de prompts e código, com um juiz de LLM revisando os pares mais próximos. Eles afirmam que nenhuma tarefa duplicou uma tarefa pública nem avaliou o mesmo comportamento, embora uma minoria toque o mesmo componente de uma tarefa pública com uma mudança diferente; os repositórios upstream também são monitorados quanto a mudanças que se sobreponham às soluções de referência.
Configuração da avaliação
Os autores avaliam sete modelos, cinco execuções por tarefa cada, totalizando 3.495 execuções pontuadas coletadas entre 01.10.2026 e 10.10.2026. Toda execução usa o runner hospedado HUD e o HUD SDK (hud-python, série v0.6; lançamento mais recente v0.6.21): o loop de agente do SDK chama diretamente a API de cada modelo, expõe o esquema de ferramentas no qual os modelos daquele provedor são treinados e executa cada chamada de ferramenta no mesmo contêiner da tarefa; nenhum produto de fornecedor como Claude Code, Codex CLI ou Gemini CLI está envolvido. Todos os modelos compartilham tarefa, prompt, contêiner, recursos, orçamento de 1.000 passos e avaliador, diferindo apenas na interface de ferramentas e no loop de agente, um contraste deliberado com a ferramenta única de bash do DeepSWE para todos os modelos, que o próprio relatório aponta como limitação. Cada modelo rodou com raciocínio estendido na configuração padrão de alto esforço da plataforma e sem system prompt.
As configurações avaliadas são: Claude Opus 5.5 e Claude Fable 5.1 via Anthropic Messages API com bash e str_replace_based_edit_tool em esforço max e limite de saída de 128.000 tokens; GPT-6 Astra via OpenAI Responses com um shell baseado em patch em esforço max e 64.000 tokens; Gemini 3.8 Flash via Gemini generateContent com run_shell_command, read_file, replace, write_file, grep_search, glob e list_directory em thinking high e 65.536 tokens; e Qwen 3.8 Max, DeepSeek V4.1 Flash e Grok 4.6 via uma interface de chat compatível com OpenAI com bash, read, edit, write, grep e glob em esforço xhigh, com 131.072 tokens de saída para os dois primeiros e o padrão do provedor para o Grok 4.6.
Execuções foram excluídas e repetidas se invalidadas na plataforma, se falharam por razões de infraestrutura, se eram verificações de fumaça ou se atingiram o limite de passos ou de tokens de saída; as exclusões por limite atingido se concentraram no Claude Opus 5.5 (27 execuções) e no Gemini 3.8 Flash (55 execuções), além de 2 execuções do Grok 4.6. O Gemini 3.8 Flash não tem execução válida em uma tarefa lançada e é pontuado sobre 99 tarefas.
O relatório publica três medidas de incerteza: intervalos de amostragem de tarefas usados para as pontuações principais, bootstrap pareado e testes de permutação com inversão de sinal para diferenças entre modelos (2.000 reamostragens; 20.000 permutações, ajustadas por Holm), e intervalos entre execuções nos cinco slots de execução para comparabilidade com DeepSWE e Terminal-Bench. Os intervalos de amostragem de tarefas (mais ou menos 3,3 a 5,5 pontos) são de duas a dez vezes mais largos que os intervalos entre execuções (mais ou menos 0,4 a 1,9), o que os autores tomam como evidência de que leaderboards que reportam apenas o ruído entre execuções subestimam o quanto os rankings dependem da amostra de tarefas.
Resultados
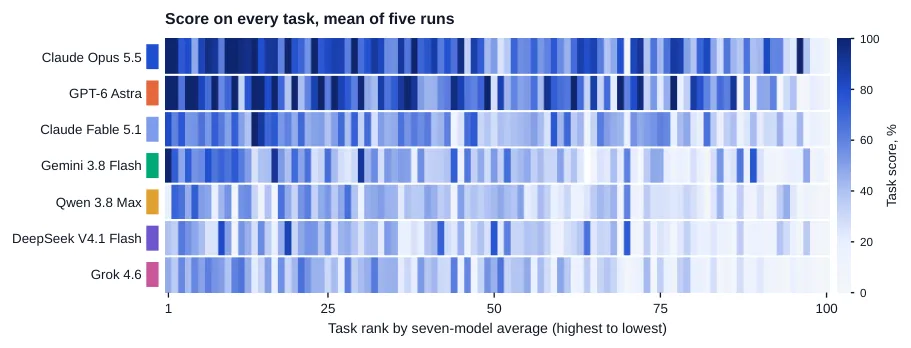
Nas 100 tarefas lançadas, o relatório apresenta estas pontuações médias por tarefa com intervalos de amostragem de tarefas de 95%: Claude Opus 5.5, 67,3 ± 4,7; GPT-6 Astra, 63,7 ± 5,5; Claude Fable 5.1, 46,5 ± 3,7; Gemini 3.8 Flash, 40,0 ± 4,3 (99 tarefas); Qwen 3.8 Max, 33,5 ± 3,3; DeepSeek V4.1 Flash, 32,5 ± 3,7; e Grok 4.6, 32,2 ± 3,5. A média entre os sete modelos é de 45,1%. Contando apenas a melhor execução de cada modelo entre as cinco, os três primeiros subiriam para 80,9%, 71,4% e 66,7%, respectivamente.
Comparações pareadas resolvem quatro camadas. Contra o Claude Opus 5.5, o teste de permutação dá p = 0,20 para o GPT-6 Astra e p < 0,001 para todos os outros modelos. Os dois primeiros não são separáveis: o Opus lidera por 3,6 pontos com um intervalo pareado de 95% de −1,4 a +9,7, vencendo 53 tarefas contra 41 do Astra, com 6 empates. Ambos estão claramente à frente do Claude Fable 5.1, que o Opus supera em 82 das 100 tarefas. O Fable lidera o Gemini 3.8 Flash por 6,5 pontos (+1,6 a +10,5), o Gemini lidera o Qwen 3.8 Max por 6,5 (+3,0 a +11,0), e os três últimos não podem ser distinguidos entre si.
As taxas de crédito total divergem fortemente: 26,6% das execuções do Claude Opus 5.5 e 23,4% das do GPT-6 Astra marcam 1,0, contra 8,6% do Claude Fable 5.1 e no máximo 3,8% do restante (1,0% do Qwen 3.8 Max e do Grok 4.6). O Opus obteve crédito total ao menos uma vez em 47 tarefas e em todas as cinco execuções em 9; o Astra fez isso em 36 e 15 tarefas, respectivamente.
Os autores reportam margem substancial: nenhuma tarefa é totalmente resolvida por todos os sete modelos; em 80 tarefas nenhum modelo obtém crédito total em todas as cinco execuções; ambos os líderes marcam 100% nas mesmas quatro tarefas e ambos ficam abaixo de 60% em 20. As médias das tarefas entre modelos variam de 2,5% a 69,5% (mediana 46,2%), e em 9 tarefas até o melhor modelo tem média abaixo de 50%. Dos 699 pares modelo-tarefa, 26 obtêm crédito total em todas as execuções e 14 marcam zero em todas. Os líderes são complementares, não ordenados: suas pontuações por tarefa se correlacionam apenas moderadamente (r de Pearson = 0,42), e em 14 tarefas eles diferem em 40 pontos ou mais, 8 a favor do Opus e 6 a favor do Astra.
Algumas tarefas derrotam todos. Em uma tarefa do OAuth2 Proxy sobre contabilização de cookies de sessão e CSRF, nenhum modelo tem média acima de 21,8%; em uma tarefa de propriedade de cota do Harbor, o melhor modelo tem média de 19,7%; e na tarefa mais difícil, uma exportação em SystemVerilog para o compilador CirC, todos os sete modelos ficam entre 2,3% e 2,7%.
Confiabilidade, crédito perdido e esforço
Os líderes diferem em consistência: as execuções do GPT-6 Astra variam menos dentro de uma tarefa (desvio padrão médio intra-tarefa de 7,3 pontos contra 13,6 do Claude Opus 5.5), e ele atinge crédito total nas cinco execuções em 15 tarefas contra 9 do Opus, enquanto o Opus atinge crédito total ao menos uma vez em mais tarefas (47 contra 36). O Claude Fable 5.1 é o modelo menos consistente (DP intra-tarefa de 16,9), embora sua pontuação de benchmark entre execuções seja a mais estável (±0,4). Os autores sugerem que um usuário capaz de amostrar e verificar várias tentativas favoreceria a amplitude do Opus, enquanto quem precisa que uma única tentativa esteja certa valorizaria a confiabilidade do Astra.
Em todas as 3.495 execuções pontuadas, 274 (7,8%) foram limitadas por um bloqueio falho e 80 (2,3%) foram zeradas por um portão falho. Essas regras custam mais aos modelos mais fortes: sem os limites de bloqueio e os portões, o Claude Opus 5.5 ganharia 3,7 pontos e o GPT-6 Astra 2,9, enquanto o grupo inferior ganharia de 1,1 a 2,9; o ranking não mudaria. O relatório destaca uma tarefa do Asynq sobre como o cancelamento de tarefa interage com os resultados dos handlers, em que Claude Opus 5.5 e Grok 4.6 marcam zero em todas as execuções enquanto o DeepSeek V4.1 Flash tem média de 75,6%, como um caso em que os portões capturam comportamento que uma avaliação só por testes recompensaria.
O esforço varia amplamente e quase não acompanha a pontuação. Os passos medianos de agente por execução vão de 33 para o GPT-6 Astra a 166 para o Gemini 3.8 Flash, com cinco dos sete modelos em uma mediana de 127 ou mais (160 para o Claude Opus 5.5); o Astra alcança 95% da pontuação do Opus com cerca de um quinto de seus passos. Dentro de cada modelo, a correlação entre número de passos e pontuação é fraca (r entre −0,15 e +0,17). Os tempos medianos de vida dos contêineres vão de 36 minutos para o GPT-6 Astra a 100 minutos para o Qwen 3.8 Max, o mais longo apesar de um número de passos intermediário.
Limitações e próximos passos
O relatório lista quatro limitações. Primeiro, cada modelo usou a interface de ferramentas nativa do seu provedor através do HUD SDK, o que está mais próximo de como os modelos são treinados e implantados do que uma ferramenta bash compartilhada, mas significa que parte de qualquer diferença pode refletir o design das ferramentas em vez da capacidade; uma comparação controlada sob um único harness é trabalho futuro. Segundo, cada modelo rodou na configuração padrão de raciocínio de alto esforço da sua plataforma, que não foi varrida. Terceiro, 100 tarefas produzem intervalos de mais ou menos 3,3 a 5,5 pontos, de modo que diferenças menores que cerca de 5 pontos entre modelos adjacentes não devem ser superinterpretadas. Quarto, as mudanças das tarefas são inéditas e triadas, mas os próprios repositórios são públicos e provavelmente estão nos dados de treinamento: o EC-SWE testa resolução de problemas em código de aparência familiar, e tarefas públicas lançadas eventualmente entrarão nos corpora de treinamento, o que as 76 tarefas retidas mitigam.
Comparando com o DeepSWE v1.1, onde quatro dos mesmos modelos ficam separados por 0,9 ponto entre si, os autores argumentam que o EC-SWE resolve diferenças que leaderboards existentes não resolvem; esses quatro abrangem 34,8 pontos aqui, e o DeepSeek V4.1 Flash é o terceiro no DeepSWE e o sexto no EC-SWE. Eles alertam que a comparação é indicativa, não controlada, porque os benchmarks diferem em métrica, harness e população de tarefas.
O trabalho futuro planejado inclui auditar avaliadores com um juiz independente em uma amostra de execuções de agentes e publicar as taxas de discordância; reexecutar todos os modelos sob um harness compartilhado de ferramenta única; varrer o esforço de raciocínio; aumentar o corpus por meio de novas ondas de autoria e aposentar periodicamente tarefas públicas; e estender a mesma metodologia de autoria por especialistas e avaliação por rubricas a outros domínios profissionais, começando por consultoria de gestão.
Disponibilidade
Os autores lançam 24 tarefas com seus ambientes, avaliadores e resultados por meio do conjunto de dados do Hugging Face em huggingface.co/datasets/ExpertCrowd/ec-swe, e retêm 76 para limitar a contaminação. Um leaderboard público está hospedado em toptal.com/expertcrowd/benchmarks/expertcrowd-swe-benchmark.