Un benchmark de solicitudes de cambio escritas por expertos
Un informe técnico de Toptal ExpertCrowd de noviembre de 2026 (arXiv:2611.13246v1 [cs.AI], 09.11.2026) presenta ExpertCrowd-SWE (EC-SWE), un benchmark de 100 tareas de ingeniería de software de varios archivos, escritas por expertos y diseñado para evaluar agentes de codificación autónomos en bases de código grandes y desconocidas. Los autores son Josip Vrdoljak, Akash Singh, John Lorenzo, Bas Steunebrink, Achille Nicoletti, Alex Yarotsky y Sam Pigott.
Cada tarea es una solicitud de cambio escrita por un ingeniero en activo sobre un commit fijado de un repositorio real. Va acompañada de una solución de referencia sellada y de un calificador específico cuyos criterios ponderados, en su mayoría ejecutables, conceden crédito parcial; los bloqueantes obligatorios y las compuertas de aprobado o suspenso codifican lo que un mantenedor se negaría a fusionar. Las tareas abarcan 87 proyectos de código abierto y 11 lenguajes. El ticket mediano tiene 148 palabras, mientras que la solución de referencia mediana modifica 471 líneas en una mediana de 4.5 archivos. Cada imagen de tarea se calibra antes de su publicación para que la solución de referencia obtenga 1.0 y tanto el repositorio intacto como un cambio inerte obtengan 0, y casi la mitad de las tareas incluyen parches de control alternativos, perezosos y adversarios que el calificador debe clasificar correctamente. Las 100 tareas finales se eligieron por su dificultad frente a los modelos de frontera actuales.
El alcance es deliberadamente estrecho: el benchmark pregunta si un agente, trabajando de forma autónoma en un repositorio aislado y sin conexión, puede producir un cambio que el calificador de un mantenedor experto acepte. Los autores subrayan que la tabla clasificatoria compara modelos bajo las mismas condiciones de tarea, prompt, sandbox y presupuesto; no es una clasificación de productos de codificación ni de la calidad general de los modelos.
Por qué un nuevo benchmark
El informe sostiene que la receta dominante, introducida por SWE-bench, extrae correcciones fusionadas de repositorios públicos de GitHub y califica cada tarea con las pruebas que acompañaban a la corrección. Según los autores, esto tiene dos debilidades: las correcciones, sus discusiones y sus pruebas son públicas y plausiblemente están en los corpus de preentrenamiento, por lo que una puntuación alta puede reflejar memoria y no resolución de problemas; y las pruebas heredadas se escribieron para confirmar un parche concreto, por lo que pueden rechazar alternativas válidas o aceptar soluciones incompletas.
El informe relata dos eventos de 2026 que hicieron imposible ignorar estos problemas. En febrero, OpenAI dejó de reportar SWE-bench Verified después de que una auditoría encontrara problemas materiales en las pruebas o en los enunciados del 59.4% de 138 problemas auditados, junto con evidencia de que los modelos de frontera habían memorizado los parches de referencia. En julio, una auditoría posterior estimó que aproximadamente el 30% de las tareas de SWE-Bench Pro estaban rotas, y OpenAI retiró su recomendación anterior de ese benchmark, pidiendo evaluaciones construidas con desarrolladores de software experimentados y supervisión humana en todo el proceso.
Los benchmarks con tareas escritas en lugar de extraídas abordan la contaminación, pero los autores señalan que los agentes más fuertes también se agolpan en lo alto de esas clasificaciones: en DeepSWE v1.1, Claude Opus 5.5, GPT-6 Astra, DeepSeek V4.1 Flash y Gemini 3.8 Flash se sitúan a menos de 0.9 puntos entre sí (del 72.3% al 71.4%). EC-SWE se presenta como un benchmark de cambios que ningún modelo ha visto resueltos, escritos para el benchmark por ingenieros que conocen la base de código, nunca publicados como correcciones, calificados como un mantenedor revisa un pull request y mantenidos en su mayoría en privado.
Cómo se producen las tareas
Los autores de tareas son ingenieros de la red de talento de Toptal, descrita como más de 30,000 expertos verificados y especializados, que se postulan a una de cuatro áreas: compiladores y herramientas de lenguaje; sistemas, backend y redes; bases de datos y sistemas de almacenamiento; y SRE, DevOps e infraestructura. Treinta y nueve expertos contribuyeron a la creación de tareas; tras el control de calidad, la verificación y la selección, las 100 tareas finales provienen de 17 de ellos.
La creación sigue un flujo de trabajo en dos etapas que comienza con un borrador. En la etapa de borrador, el autor envía el repositorio y el hash exacto del commit al que se fija (nunca un nombre de rama), el prompt redactado como ticket y un plan de calificación que nombra las comprobaciones y cuáles deben aprobarse; un revisor lo aprueba o lo devuelve, y los borradores se rechazan por ser ilegibles, por prescribir una implementación, por carecer de plan de calificación o depender solo de un juez de IA, o por proponer un problema que el autor no ha resuelto. En la etapa de construcción, el autor implementa la tarea sobre la plantilla de codificación de HUD, confirma que la solución de referencia obtiene 100% mientras un checkout sin cambios obtiene 0%, y ejecuta la tarea cinco veces contra un modelo de frontera (Claude Opus 5, límite de 100 pasos); cinco ejecuciones en cero se tratan como una posible señal de un calificador roto. Se permite asistencia de IA para el cableado del entorno, pero no para la idea de la tarea ni para la solución de referencia. Las razones registradas para rechazar tareas enviadas incluyen soluciones de referencia nunca probadas (4), calificadores débiles, rotos u opinables (3), tareas o repositorios demasiado pequeños (3), envíos incompletos (2) y una tarea imposible.
Las tareas provienen de cuatro vías bajo reglas comunes de contaminación: nunca basar una tarea en un fallo ya corregido en público, nunca usar código de empleadores o clientes, mantener el cambio de la tarea sin publicar y usar código propietario solo cuando el autor es su propietario y concede los derechos. Las vías son cambios basados en la experiencia del experto en repositorios públicos, tareas motivadas por incidencias abiertas y no resueltas en el proyecto original, forks con problemas añadidos por el experto y bases de código que el experto posee. En el conjunto publicado, 98 tareas son cambios nuevos sobre proyectos públicos de código abierto sin sustrato añadido; una tarea, una verificación previa de migración de claves foráneas de PostgreSQL en SQLAlchemy, añade un parche de sustrato de unas 250 líneas escrito por el experto; y otra, una canalización de webhooks de pagos, se construye sobre una base de código propiedad de su autor. Los commits base son recientes: 82 de los 100 se confirmaron en agosto o septiembre de 2026, con una fecha mediana del 04.09.2026, y al menos 97 están en la rama por defecto del proyecto original.
Cada tarea incluye cuatro artefactos: un prompt formado por el ticket del autor más un preámbulo de entorno (ubicación del repositorio, unas dos vCPU y un límite estricto de memoria, un sandbox sin conexión, cómo arrancar los servicios de apoyo que las pruebas propias del repositorio necesitan, y la instrucción de que pruebas ocultas calificarán el trabajo y de que las pruebas existentes no deben modificarse); un entorno Docker que contiene el repositorio en el commit fijado con su historial encriptado, las cadenas de herramientas y una caché de dependencias precargada, con shells de agente que se ejecutan como usuario sin privilegios y todos los archivos con forma de respuesta bajo un directorio solo accesible por root; la solución de referencia del autor (task/gold.diff), sellada dentro de la imagen; y un calificador que se ejecuta de forma hermética, levantando su propia instancia de cualquier servicio de apoyo necesario, como Redis o una base de datos, en un puerto privado.
Calificación
Cada calificador es una lista de criterios con nombre y pesos que suman exactamente 1.0 en las 100 tareas publicadas. La mayoría de los criterios son comprobaciones ejecutables del comportamiento observable a través de la interfaz pública de la biblioteca o del servicio; se evitan las comprobaciones internas de implementación para que cualquier solución razonable pueda obtener crédito completo. Se combinan tres tipos de regla: criterios ponderados cuyas puntuaciones se suman en crédito parcial; bloqueantes, criterios obligatorios que limitan la puntuación de una ejecución por debajo del crédito completo (por ejemplo a 0.60) en lugar de anularla; y compuertas, condiciones previas de aprobado o suspenso sin peso que anulan la ejecución si se incumplen, como exigir que la suite de pruebas propia del repositorio esté en verde y sin tocar. Catorce tareas publicadas usan compuertas.
Los autores justifican el crédito parcial con sus propios datos: solo entre el 1.0% y el 3.8% de las ejecuciones de Gemini 3.8 Flash, Qwen 3.8 Max, DeepSeek V4.1 Flash y Grok 4.6 obtienen crédito completo, de modo que una calificación binaria comprimiría a los cuatro en una banda del 1% al 4%, mientras que el crédito parcial los reparte entre el 32.2% y el 40.0%. Diez tareas incluyen un criterio juzgado por un LLM que representa entre el 2% y el 25% del peso de la tarea, un 8.5% de media entre las diez y un 0.85% del peso total del benchmark; los autores indican que los criterios juzgados por LLM se mantuvieron por debajo del 10% de la calificación total por posibles problemas de sesgo y fiabilidad, y las 90 tareas restantes se califican por completo con comprobaciones deterministas.
Garantía de calidad y controles de contaminación
La calidad se impone en el momento de la construcción, mediante parches de control y mediante revisión de ingenieros sénior. La construcción de la imagen falla a menos que la solución de referencia obtenga exactamente 1.00 con cada criterio aprobado individualmente y tanto el checkout intacto como un cambio inerte de solo comentarios obtengan 0.00 con cada criterio fallido. Los parches de control explícitos deben clasificarse correctamente: soluciones válidas alternativas que deben aprobar (35 tareas), parches adversarios o tramposos que deben fallar, por ejemplo los que editan pruebas, tratan de forma especial las entradas calificadas o desactivan la función probada (30 tareas), y parches perezosos o vacíos que deben puntuar bajo (42 tareas). Cada tarea fue revisada por un ingeniero sénior, que examinó su prompt, entorno, solución de referencia, calificador y ejecuciones diagnósticas con modelos de frontera; solo las tareas que superaron la revisión recibieron el estado "verified" de la plataforma.
Sobre la contaminación, los autores informan de que el cambio de cada tarea no está publicado; 76 de las 100 tareas se reservan; y cada tarea se cotejó con 499,647 registros de tareas de 93 conjuntos de datos públicos de benchmarks de ingeniería de software, comparando commits de repositorio e identificadores de tarea y la similitud semántica de prompts y código, con un juez LLM revisando los pares más cercanos. Afirman que ninguna tarea duplicó una tarea pública ni calificó el mismo comportamiento, aunque una minoría toca el mismo componente que una tarea pública con un cambio distinto; también se vigilan los repositorios originales por si aparecen cambios que se solapen con las soluciones de referencia.
Configuración de la evaluación
Los autores evalúan siete modelos, cinco ejecuciones por tarea cada uno, para un total de 3,495 ejecuciones calificadas recogidas entre el 01.10.2026 y el 10.10.2026. Cada ejecución usa el runner alojado de HUD y el SDK de HUD (hud-python, serie v0.6; última versión v0.6.21): el bucle de agente del SDK llama directamente a la API de cada modelo, expone el esquema de herramientas con el que se entrenaron los modelos de ese proveedor y ejecuta cada llamada de herramienta en el mismo contenedor de tarea; no interviene ningún producto de proveedor como Claude Code, Codex CLI o Gemini CLI. Todos los modelos comparten tarea, prompt, contenedor, recursos, presupuesto de 1,000 pasos y calificador, y difieren solo en la interfaz de herramientas y el bucle de agente, un contraste deliberado con la única herramienta bash que DeepSWE da a todos los modelos y que el propio informe señala como limitación. Cada modelo se ejecutó con razonamiento extendido en el ajuste de alto esfuerzo por defecto de la plataforma y sin prompt de sistema.
Las configuraciones evaluadas son: Claude Opus 5.5 y Claude Fable 5.1 a través de la API Anthropic Messages con bash y str_replace_based_edit_tool con esfuerzo max y un límite de salida de 128,000 tokens; GPT-6 Astra a través de OpenAI Responses con una shell basada en parches con esfuerzo max y 64,000 tokens; Gemini 3.8 Flash a través de Gemini generateContent con run_shell_command, read_file, replace, write_file, grep_search, glob y list_directory con thinking high y 65,536 tokens; y Qwen 3.8 Max, DeepSeek V4.1 Flash y Grok 4.6 a través de una interfaz de chat compatible con OpenAI con bash, read, edit, write, grep y glob con esfuerzo xhigh, con 131,072 tokens de salida para los dos primeros y el valor por defecto del proveedor para Grok 4.6.
Las ejecuciones se excluyeron y se repitieron si fueron invalidadas en la plataforma, fallaron por razones de infraestructura, eran comprobaciones de humo o alcanzaban el límite de pasos o de tokens de salida; las exclusiones por límite se concentraron en Claude Opus 5.5 (27 ejecuciones) y Gemini 3.8 Flash (55 ejecuciones), más 2 ejecuciones de Grok 4.6. Gemini 3.8 Flash no tiene ninguna ejecución válida en una tarea publicada y se califica sobre 99 tareas.
El informe publica tres medidas de incertidumbre: intervalos de muestreo de tareas usados para las puntuaciones principales, pruebas pareadas de bootstrap y de permutación con cambio de signo para las diferencias entre modelos (2,000 remuestreos; 20,000 permutaciones, ajustadas por Holm), e intervalos entre ejecuciones sobre las cinco ranuras de ejecución para comparar con DeepSWE y Terminal-Bench. Los intervalos de muestreo de tareas (más o menos 3.3 a 5.5 puntos) son de dos a diez veces más anchos que los intervalos entre ejecuciones (más o menos 0.4 a 1.9), lo que los autores toman como evidencia de que las clasificaciones que solo reportan ruido entre ejecuciones subestiman cuánto dependen los rankings de la muestra de tareas.
Resultados
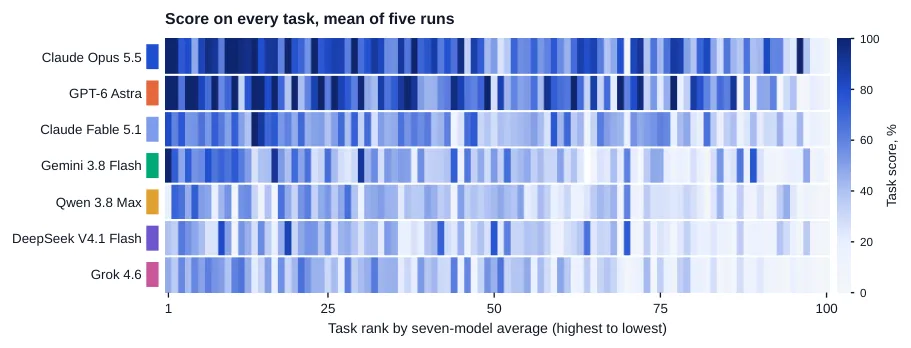
En las 100 tareas publicadas, el informe da estas puntuaciones medias por tarea con intervalos de muestreo de tareas del 95%: Claude Opus 5.5, 67.3 ± 4.7; GPT-6 Astra, 63.7 ± 5.5; Claude Fable 5.1, 46.5 ± 3.7; Gemini 3.8 Flash, 40.0 ± 4.3 (99 tareas); Qwen 3.8 Max, 33.5 ± 3.3; DeepSeek V4.1 Flash, 32.5 ± 3.7; y Grok 4.6, 32.2 ± 3.5. La media de los siete modelos es del 45.1%. Contando solo la mejor ejecución de cada modelo de las cinco, los tres primeros subirían al 80.9%, 71.4% y 66.7% respectivamente.
Las comparaciones pareadas resuelven cuatro niveles. Frente a Claude Opus 5.5, la prueba de permutación da p = 0.20 para GPT-6 Astra y p < 0.001 para todos los demás modelos. Los dos primeros no son separables: Opus aventaja por 3.6 puntos con un intervalo pareado del 95% de −1.4 a +9.7, ganando 53 tareas frente a 41 de Astra con 6 empates. Ambos están claramente por delante de Claude Fable 5.1, al que Opus supera en 82 de 100 tareas. Fable aventaja a Gemini 3.8 Flash por 6.5 puntos (+1.6 a +10.5), Gemini aventaja a Qwen 3.8 Max por 6.5 (+3.0 a +11.0), y los tres del grupo inferior no pueden distinguirse entre sí.
Las tasas de crédito completo divergen con fuerza: el 26.6% de las ejecuciones de Claude Opus 5.5 y el 23.4% de las de GPT-6 Astra obtienen 1.0, frente al 8.6% de Claude Fable 5.1 y como máximo el 3.8% del resto (1.0% para Qwen 3.8 Max y Grok 4.6). Opus obtuvo crédito completo al menos una vez en 47 tareas y en las cinco ejecuciones en 9; Astra lo hizo en 36 y 15 tareas respectivamente.
Los autores informan de un margen considerable: ninguna tarea es resuelta por completo por los siete modelos; en 80 tareas ningún modelo obtiene crédito completo en las cinco ejecuciones; ambos líderes alcanzan el 100% en las mismas cuatro tareas y ambos caen por debajo del 60% en 20. Las medias por tarea entre modelos van del 2.5% al 69.5% (mediana 46.2%), y en 9 tareas incluso el mejor modelo promedia menos del 50%. De los 699 pares modelo-tarea, 26 obtienen crédito completo en cada ejecución y 14 obtienen cero en cada ejecución. Los líderes son complementarios más que ordenados: sus puntuaciones por tarea correlacionan solo moderadamente (r de Pearson = 0.42), y en 14 tareas difieren en 40 puntos o más, 8 a favor de Opus y 6 a favor de Astra.
Algunas tareas derrotan a todos. En una tarea de OAuth2 Proxy sobre contabilidad de cookies de sesión y CSRF, ningún modelo promedia más del 21.8%; en una tarea de propiedad de cuotas de Harbor, el mejor modelo promedia 19.7%; y en la tarea más difícil, una exportación de SystemVerilog para el compilador CirC, los siete modelos quedan entre el 2.3% y el 2.7%.
Fiabilidad, crédito perdido y esfuerzo
Los líderes difieren en consistencia: las ejecuciones de GPT-6 Astra varían menos dentro de una tarea (desviación estándar media dentro de tarea de 7.3 puntos frente a 13.6 de Claude Opus 5.5), y alcanza crédito completo en las cinco ejecuciones en 15 tareas frente a 9 de Opus, mientras Opus obtiene crédito completo al menos una vez en más tareas (47 frente a 36). Claude Fable 5.1 es el modelo menos consistente (desviación estándar dentro de tarea de 16.9) aunque su puntuación de benchmark entre ejecuciones es la más estable (±0.4). Los autores sugieren que un usuario que pueda muestrear y verificar varios intentos favorecería la amplitud de Opus, mientras que uno que necesite que un solo intento sea correcto valoraría la fiabilidad de Astra.
De las 3,495 ejecuciones calificadas, 274 (7.8%) fueron limitadas por un bloqueante fallido y 80 (2.3%) fueron anuladas por una compuerta fallida. Estas reglas cuestan más a los modelos más fuertes: sin los topes de bloqueantes y las compuertas, Claude Opus 5.5 ganaría 3.7 puntos y GPT-6 Astra 2.9, mientras el grupo inferior ganaría entre 1.1 y 2.9; la clasificación no cambiaría. El informe destaca una tarea de Asynq sobre cómo la cancelación de tareas interactúa con los resultados de los manejadores, donde Claude Opus 5.5 y Grok 4.6 obtienen cero en cada ejecución mientras DeepSeek V4.1 Flash promedia 75.6%, como un caso en el que las compuertas capturan comportamientos que una calificación basada solo en pruebas recompensaría.
El esfuerzo varía ampliamente y apenas se relaciona con la puntuación. La mediana de pasos de agente por ejecución va de 33 para GPT-6 Astra a 166 para Gemini 3.8 Flash, con cinco de los siete modelos en una mediana de 127 o más (160 para Claude Opus 5.5); Astra alcanza el 95% de la puntuación de Opus con aproximadamente una quinta parte de sus pasos. Dentro de cada modelo, la correlación entre número de pasos y puntuación es débil (r entre −0.15 y +0.17). Las medianas de vida del contenedor van de 36 minutos para GPT-6 Astra a 100 minutos para Qwen 3.8 Max, la más larga pese a un número de pasos de rango medio.
Limitaciones y próximos pasos
El informe enumera cuatro limitaciones. Primero, cada modelo usó la interfaz de herramientas nativa de su proveedor a través del SDK de HUD, lo cual se acerca más a cómo se entrenan y despliegan los modelos que una herramienta bash compartida, pero significa que parte de cualquier brecha podría reflejar el diseño de herramientas en lugar de la capacidad; una comparación controlada bajo un único harness es trabajo futuro. Segundo, cada modelo se ejecutó en el ajuste de razonamiento de alto esfuerzo por defecto de la plataforma, que no se barrió. Tercero, 100 tareas producen intervalos de más o menos 3.3 a 5.5 puntos, por lo que diferencias menores de unos 5 puntos entre modelos adyacentes no deberían sobreinterpretarse. Cuarto, los cambios de las tareas no están publicados y fueron cotejados, pero los repositorios mismos son públicos y probablemente están en los datos de entrenamiento: EC-SWE mide resolución de problemas en código de aspecto familiar, y las tareas públicas publicadas acabarán entrando en los corpus de entrenamiento, algo que las 76 tareas reservadas mitigan.
Al comparar con DeepSWE v1.1, donde cuatro de los mismos modelos quedan a menos de 0.9 puntos entre sí, los autores sostienen que EC-SWE resuelve diferencias que las clasificaciones existentes no resuelven; esos cuatro abarcan 34.8 puntos aquí, y DeepSeek V4.1 Flash ocupa el tercer puesto en DeepSWE y el sexto en EC-SWE. Advierten de que la comparación es indicativa y no controlada porque los benchmarks difieren en métrica, harness y población de tareas.
El trabajo futuro previsto incluye auditar los calificadores con un juez independiente sobre una muestra de ejecuciones de agentes y publicar tasas de desacuerdo; volver a ejecutar todos los modelos bajo un harness compartido de una sola herramienta; barrer el esfuerzo de razonamiento; ampliar el corpus con nuevas oleadas de creación y retirar periódicamente tareas públicas; y extender la misma metodología de autoría experta y calificación por rúbricas a otros ámbitos profesionales, empezando por la consultoría de gestión.
Disponibilidad
Los autores publican 24 tareas con sus entornos, calificadores y resultados a través del conjunto de datos de Hugging Face en huggingface.co/datasets/ExpertCrowd/ec-swe, y reservan 76 para limitar la contaminación. Una tabla clasificatoria pública está alojada en toptal.com/expertcrowd/benchmarks/expertcrowd-swe-benchmark.