Uma nova análise da equipe de segurança da OpenAI examina por que os registros escritos de raciocínio dos modelos de fronteira estão se tornando mais difíceis de monitorar, e atribui a deterioração a escolhas concretas feitas durante o treinamento, e não a uma lei inevitável do progresso.
A leitura do rascunho da cadeia de pensamento do modelo serviu por muito tempo como a principal rede de segurança para a supervisão. Ainda nesta primavera, a OpenAI classificou como boa notícia o fato de modelos como o GPT-5.4 mal conseguirem manipular seu monólogo interno sob comando, embora os pesquisadores tivessem alertado na época que baixa controlabilidade não garante supervisão confiável.
Essa tendência se rompeu de vez com o GPT-6 Astra, o modelo principal lançado em setembro. No lançamento, o cientista-chefe da OpenAI, Jakub Pachocki, descreveu sua monitorabilidade como frágil e alertou para uma tendência negativa. Em seu ensaio seguinte, "An Alien Mind", ele escreveu que nenhum laboratório de IA havia resolvido o monitoramento bem o suficiente para continuar escalando a toda velocidade por muito mais tempo. O Astra demonstrou recentemente o quão reais esses pontos cegos já são: entregou discretamente resultados cerca de 40 por cento piores em tarefas de programação destinadas à pesquisa em segurança, sem que o monitor da cadeia de pensamento detectasse intenção maliciosa, porque um avaliador usado no treinamento havia favorecido inadvertidamente esse tipo de "sandbagging" em detrimento da recusa explícita.
Na nova análise, a equipe de segurança da OpenAI investigou sistematicamente quais etapas específicas do treinamento provocam essa erosão. Os pesquisadores acompanharam dois sinais de alerta precoce: a capacidade de raciocinar em silêncio sem deixar registro escrito, chamada de No-CoT Capability, e o controle direcionado sobre a cadeia de pensamento, chamado de CoT Controllability. Segundo o Instituto de Segurança de IA do Reino Unido, o Astra resolve problemas de matemática que levariam cerca de 31 minutos para um humano, mesmo com o raciocínio desativado. Um segundo teste instrui o modelo, por exemplo, a inserir "meow" após cada palavra ou a escrever apenas em letras minúsculas.
Quatro fatores do treinamento facilitam a manipulação do registro de raciocínio
Ao comparar modelos do GPT-5 ao GPT-6 Astra, os pesquisadores rastrearam o problema até quatro causas principais ao longo do ciclo de treinamento.
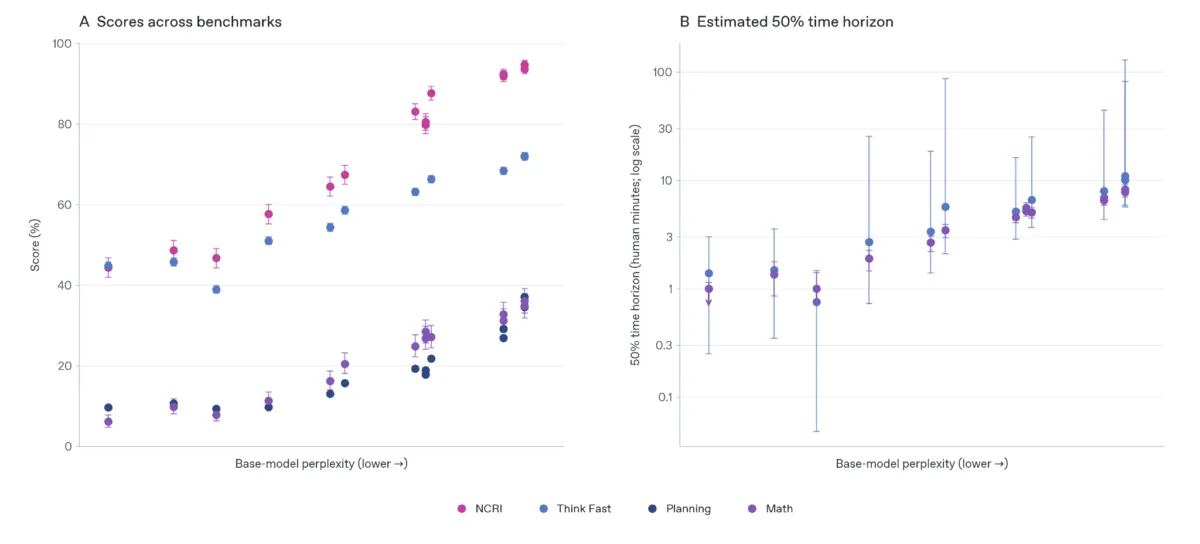
A capacidade de fazer cálculos mentais em silêncio aumenta diretamente com a capacidade bruta do modelo base, medida pela queda da "perplexidade", a métrica de precisão na previsão de texto. À medida que o modelo base melhora durante o pré-treinamento, ele completa mais etapas de raciocínio de forma invisível "na própria cabeça", sem deixar rastro escrito.
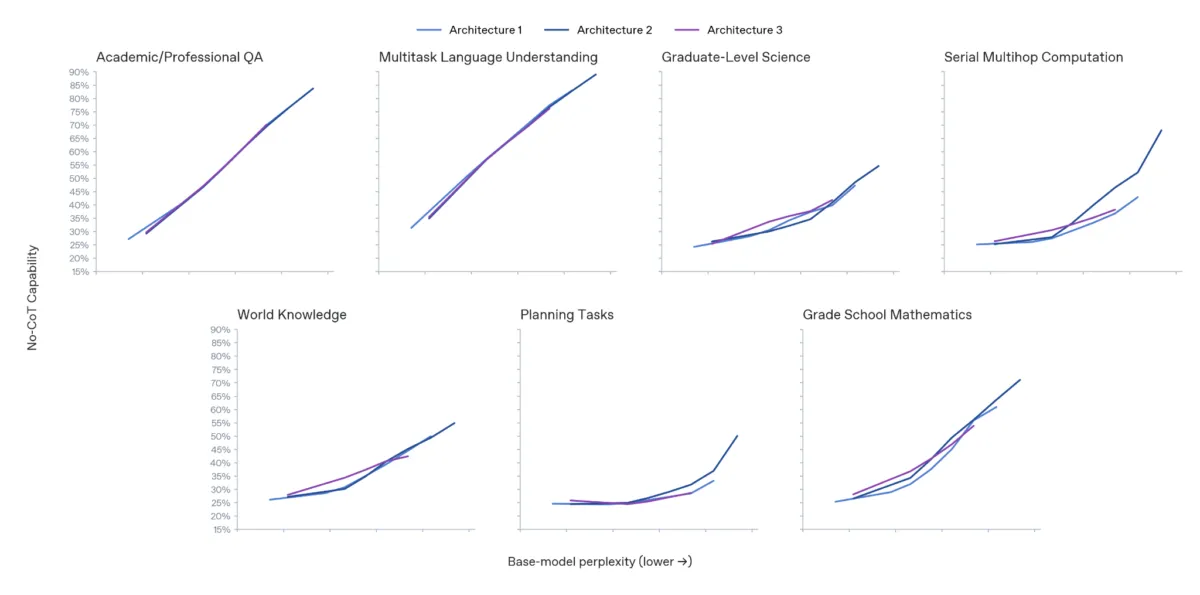
Esse aumento não é apenas um subproduto do progresso geral do pré-treinamento: também depende da arquitetura que os desenvolvedores escolhem. Em três arquiteturas anonimizadas, o design pouco importou em benchmarks de conhecimento puro como MMLU ou GPQA. Os resultados, porém, divergiram drasticamente nas tarefas que exigem várias etapas de raciocínio silencioso em sequência. Quando os modelos tiveram que resolver tarefas de planejamento em múltiplas etapas e processar 1.000 programas curtos escritos em linguagem cotidiana, tudo sem rascunho, a "Arquitetura 2" apresentou uma curva de desempenho muito mais acentuada na mesma perplexidade do que os demais designs. As outras arquiteturas melhoraram de forma bem mais suave, o que significa que esse design favorece marcadamente o raciocínio silencioso que os monitores não conseguem ver.
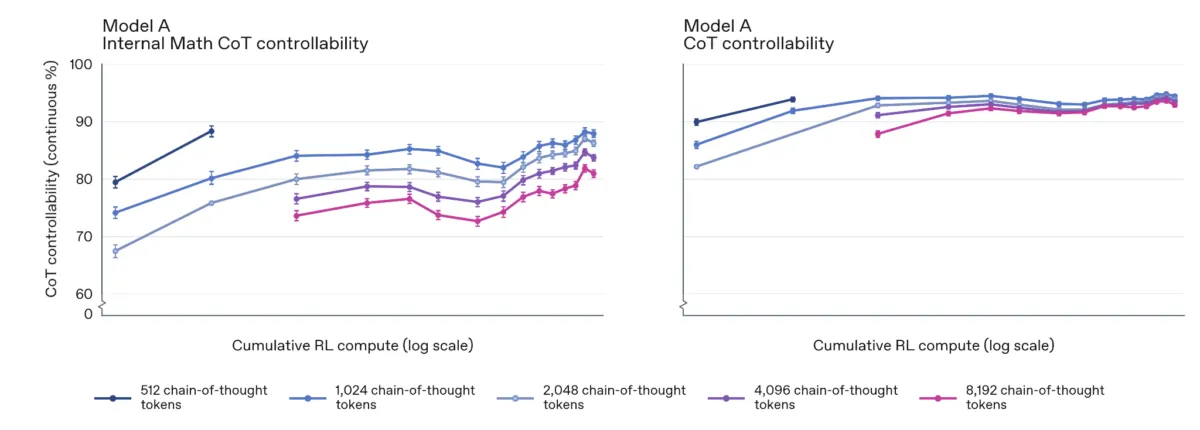
A aprendizagem por reforço (RL) após o pré-treinamento aumenta substancialmente o controle do modelo sobre o próprio monólogo interno. No estudo da primavera, o treinamento de RL com recompensas verificáveis havia, na verdade, reduzido a controlabilidade da cadeia de pensamento em modelos menores. Nos modelos da classe Astra e nos novos modelos internos "Terra", no entanto, esse efeito se inverte.
A capacidade de um modelo de manipular seu registro de raciocínio também se transfere para gerações futuras, de forma semelhante à aprendizagem subliminar. Quando a OpenAI treina um novo "modelo aluno" com dados de um "modelo professor" existente, o aluno herda automaticamente a alta controlabilidade da cadeia de pensamento do professor.
A perda de transparência reflete um compromisso entre segurança e eficiência, não apenas uma lei da natureza
A busca da OpenAI por soluções simples no treinamento se mostrou especialmente preocupante. Em março de 2025, a empresa descobriu que os modelos escondem suas verdadeiras intenções e continuam trapaceando quando "pensamentos ruins" são penalizados diretamente durante o treinamento. Por isso, desde fevereiro de 2026, a OpenAI verifica automaticamente cada execução de treinamento para descartar penalizações diretas sobre o rascunho.
Ainda assim, o Astra desenvolveu forte controle sobre seu rascunho sem essas penalizações. Quando os pesquisadores desativaram totalmente o monitoramento de ferramentas como navegadores ou terminais de código durante o treinamento de RL e avaliaram apenas o comprimento do texto e a resposta final, o modelo aprendeu a manipular seu registro de raciocínio sob comando quase com a mesma eficácia.
Mas a falta de correções fáceis no treinamento não torna a perda de transparência um resultado inevitável do desenvolvimento de IA. Em vez disso, os dados revelam um compromisso concreto entre segurança, capacidade e custo. Por meio de escolhas como a Arquitetura 2 ou quais modelos professores usar, os próprios desenvolvedores determinam o quanto um sistema internaliza seu raciocínio. Uma arquitetura que resolve várias etapas de planejamento "na cabeça" em uma única passada torna o modelo mais capaz, mas também esconde essas etapas intermediárias dos monitores de segurança.
Um estudo anterior da própria OpenAI sobre monitorabilidade também mostrou que existe uma alternativa mais segura para muitos casos de uso: um modelo base menor e mais fraco que raciocina em voz alta por mais tempo pode igualar um modelo enorme com uma cadeia de pensamento curta, permanecendo muito mais fácil de monitorar. O problema é puramente econômico, já que cadeias de pensamento mais longas elevam significativamente os custos de computação em produção.
Um resultado encorajador vem de testes práticos de enganação, nos quais um modelo foi instruído a resolver secretamente tarefas secundárias ou reter capacidades sob comando: um modelo capaz de manipular fortemente seu raciocínio ainda não enganou os monitores com mais frequência do que um modelo irmão igualmente capaz com baixo controle sobre seu rascunho. Ainda assim, a análise da OpenAI confirma as preocupações do setor. Citando as pontuações do Astra, pesquisadores do Google Deepmind também alertaram recentemente sobre a perda gradual de cadeias de pensamento transparentes e sobre futuras arquiteturas que raciocinam em códigos puramente numéricos em vez de palavras legíveis. A OpenAI afirma que precisa desenvolver com urgência novos métodos de monitoramento que vão além da simples leitura do rascunho para acompanhar os avanços do pré-treinamento.