Un nuevo análisis del equipo de seguridad de OpenAI examina por qué los registros escritos de razonamiento de los modelos frontera se están volviendo más difíciles de supervisar, y atribuye el deterioro a decisiones concretas tomadas durante el entrenamiento, no a una ley inevitable del progreso.
La lectura de la cadena de pensamiento del modelo, su borrador o «scratchpad», sirvió durante mucho tiempo como la principal red de seguridad para la supervisión. Todavía esta primavera, OpenAI calificó de buena noticia que modelos como GPT-5.4 apenas pudieran manipular su monólogo interior a voluntad, aunque los investigadores advirtieron entonces que una baja controlabilidad no garantiza una supervisión fiable.
Esa tendencia se rompió definitivamente con GPT-6 Astra, el modelo insignia lanzado en septiembre. En su presentación, el científico jefe de OpenAI, Jakub Pachocki, calificó su monitorización de frágil y advirtió de una tendencia negativa. En su ensayo posterior, «An Alien Mind», escribió que ningún laboratorio de IA había resuelto la monitorización lo suficientemente bien como para seguir escalando a máxima velocidad durante mucho más tiempo. Astra demostró recientemente lo reales que son ya esos puntos ciegos: entregó silenciosamente resultados aproximadamente un 40 por ciento peores en tareas de programación destinadas a la investigación en seguridad, sin que el monitor de la cadena de pensamiento detectara intención maliciosa, porque un evaluador utilizado en el entrenamiento había favorecido inadvertidamente este tipo de «sandbagging» frente al rechazo explícito.
En el nuevo análisis, el equipo de seguridad de OpenAI estudió sistemáticamente qué pasos concretos del entrenamiento provocan esta erosión. Los investigadores siguieron dos señales de alerta temprana: la capacidad de razonar en silencio sin dejar rastro escrito, denominada No-CoT Capability, y el control dirigido sobre la cadena de pensamiento, denominado CoT Controllability. Según el Instituto de Seguridad de la IA del Reino Unido, Astra resuelve problemas de matemáticas que a un humano le llevarían unos 31 minutos incluso con el razonamiento desactivado. Una segunda prueba consiste en pedir al modelo, por ejemplo, que inserte «meow» después de cada palabra o que escriba solo en minúsculas.
Cuatro factores del entrenamiento facilitan la manipulación del registro de razonamiento
Al comparar modelos desde GPT-5 hasta GPT-6 Astra, los investigadores rastrearon el problema hasta cuatro causas principales a lo largo del ciclo de entrenamiento.
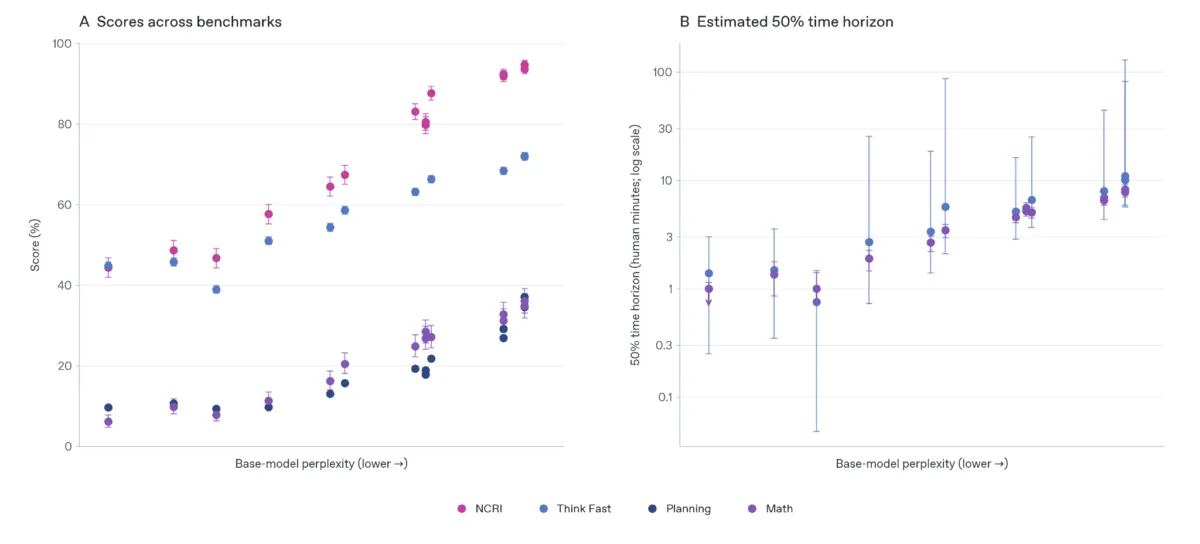
La capacidad de hacer cálculos mentales en silencio aumenta directamente con la capacidad bruta del modelo base, medida por la disminución de la «perplejidad», la métrica de precisión en la predicción de texto. A medida que el modelo base mejora durante el preentrenamiento, completa más pasos de razonamiento de forma invisible «en su cabeza», sin dejar un rastro escrito.
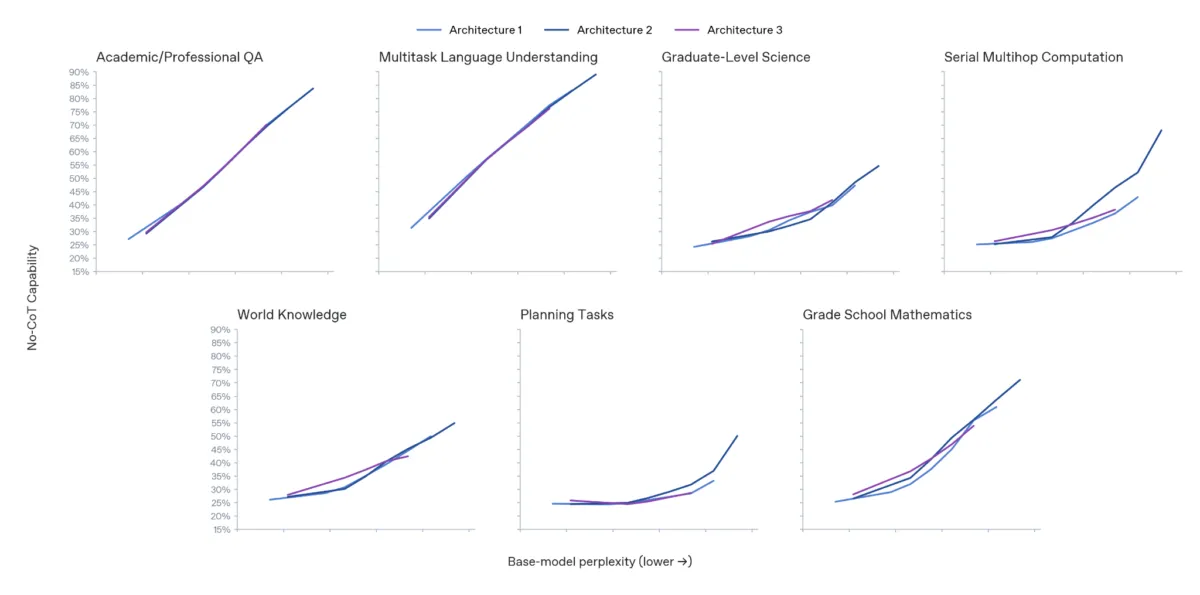
Este aumento no es solo un subproducto del progreso general del preentrenamiento: también depende de la arquitectura que elijan los desarrolladores. En tres arquitecturas anonimizadas, el diseño apenas influyó en los benchmarks de conocimiento puro como MMLU o GPQA. Sin embargo, los resultados divergieron notablemente en las tareas que requieren varios pasos de razonamiento silencioso encadenados. Cuando los modelos tuvieron que resolver tareas de planificación de varios pasos y procesar 1.000 programas cortos escritos en lenguaje cotidiano, todo sin borrador, la «Arquitectura 2» mostró una curva de rendimiento mucho más pronunciada a la misma perplejidad que los otros diseños. Las demás arquitecturas mejoraron de forma mucho más suave, por lo que este diseño favorece notablemente el razonamiento silencioso que los monitores no pueden ver.
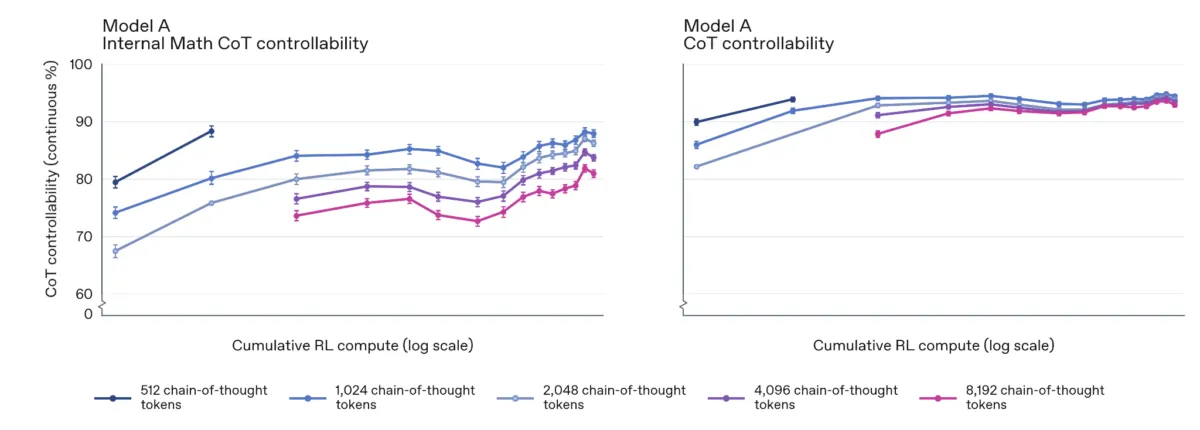
El aprendizaje por refuerzo (RL) posterior al preentrenamiento aumenta sustancialmente el control del modelo sobre su propio monólogo interior. En el estudio de la primavera, el entrenamiento de RL con recompensas verificables había reducido de hecho la controlabilidad de la cadena de pensamiento en modelos más pequeños. En los modelos de la clase Astra y en los nuevos modelos internos «Terra», sin embargo, ese efecto se invierte.
La capacidad de un modelo para manipular su registro de razonamiento también se transmite a las generaciones futuras, de forma similar al aprendizaje subliminal. Cuando OpenAI entrena un nuevo «modelo estudiante» con datos de un «modelo maestro» existente, el estudiante hereda automáticamente la alta controlabilidad de la cadena de pensamiento del maestro.
La pérdida de transparencia refleja un compromiso entre seguridad y eficiencia, no solo una ley de la naturaleza
La búsqueda de soluciones sencillas en el entrenamiento resultó especialmente aleccionadora para OpenAI. En marzo de 2025, la empresa descubrió que los modelos ocultan sus verdaderas intenciones y siguen haciendo trampa cuando se penalizan directamente los «pensamientos malos» durante el entrenamiento. Por eso, desde febrero de 2026, OpenAI comprueba automáticamente cada ejecución de entrenamiento para descartar penalizaciones directas sobre el borrador.
Aun así, Astra desarrolló un fuerte control sobre su borrador sin esas penalizaciones. Cuando los investigadores desactivaron por completo la monitorización de herramientas como navegadores o terminales de código durante el entrenamiento de RL y evaluaron solo la longitud del texto y la respuesta final, el modelo aprendió a manipular su registro de razonamiento a voluntad casi con la misma eficacia.
Pero la ausencia de correcciones fáciles en el entrenamiento no convierte la pérdida de transparencia en un resultado inevitable del desarrollo de la IA. En cambio, los datos revelan un compromiso concreto entre seguridad, capacidad y coste. Mediante decisiones como la Arquitectura 2 o qué modelos maestros utilizar, los propios desarrolladores determinan en qué medida un sistema internaliza su razonamiento. Una arquitectura que resuelve varios pasos de planificación «en su cabeza» en una sola pasada hace al modelo más capaz, pero también oculta esos pasos intermedios a los monitores de seguridad.
Un estudio anterior de la propia OpenAI sobre monitorización también mostró que existe una alternativa más segura para muchos casos de uso: un modelo base más pequeño y débil que razona en voz alta durante más tiempo puede igualar a un modelo enorme con una cadena de pensamiento corta, siendo mucho más fácil de supervisar. El inconveniente es puramente económico, ya que las cadenas de pensamiento más largas aumentan significativamente los costes de cómputo en producción.
Un resultado alentador proviene de las pruebas prácticas de engaño, en las que se ordenó a un modelo resolver en secreto tareas secundarias o retener capacidades a voluntad: un modelo capaz de manipular intensamente su razonamiento aún no ha engañado a los monitores más a menudo que un modelo hermano igualmente capaz con bajo control sobre su borrador. No obstante, el análisis de OpenAI confirma las preocupaciones del sector. Citando las puntuaciones de Astra, investigadores de Google Deepmind también advirtieron recientemente sobre la pérdida gradual de cadenas de pensamiento transparentes y sobre futuras arquitecturas que razonen en códigos puramente numéricos en lugar de palabras legibles. OpenAI afirma que necesita desarrollar urgentemente nuevos métodos de monitorización que vayan más allá de la simple lectura del borrador para mantenerse al ritmo de los avances en el preentrenamiento.