Desenvolvedores querem assistentes de codificação com IA que exijam quase nenhuma configuração. Combinar um gateway de modelo de linguagem grande (LLM) com o LiteLLM permite que eles acessem rapidamente os modelos de fundação (FMs) disponíveis no Amazon Bedrock, enquanto a organização ganha visibilidade e controle sobre esse uso. Equipes de plataforma precisam monitorar latência e erros, equipes financeiras precisam atribuir os custos de inferência a equipes e projetos, e equipes de segurança precisam de controles de acesso consistentes. Um gateway de LLM pode atender a essas necessidades atuando como um ponto de acesso gerenciado centralmente para os modelos por trás dos assistentes de codificação.
Este artigo mostra como montar um gateway de LLM de autoatendimento com os Amazon Bedrock Application Inference Profiles e o LiteLLM executado no AWS Fargate, ocultando o Amazon Bedrock atrás de uma API compatível com OpenAI. Nesse padrão, os desenvolvedores acessam os modelos de fundação por uma única API com uma chave dedicada, e a organização obtém controles de custo por usuário além de observabilidade do desempenho dos modelos. O passo a passo se baseia em trechos ilustrativos e construtos do AWS Cloud Development Kit (AWS CDK), e não em uma stack implantável completa; ao final, o leitor deve entender o padrão o suficiente para criar sua própria versão. Os modelos Claude Sonnet e Claude Haiku são usados como exemplos; para a lista de modelos e a disponibilidade por região da AWS, consulte "Supported models by AWS Region" na documentação do Amazon Bedrock.
O fluxo de requisições é direto: o tráfego vai do desenvolvedor, passa pela camada do LiteLLM e segue até o Amazon Bedrock e o modelo de fundação subjacente. O diagrama a seguir ilustra a topologia de produção por trás desse fluxo. O artigo não aborda a adição do Amazon Bedrock Guardrails, como filtragem de conteúdo e grounding, embora os controles adequados de IA responsável normalmente sejam incluídos antes de uma implantação em produção.
O cliente compatível com OpenAI do desenvolvedor chega ao gateway por meio do Amazon Route 53, do Amazon CloudFront e de um Application Load Balancer (ALB), e se autentica no LiteLLM no Fargate com uma chave de API por usuário. A requisição usa o Amazon Relational Database Service (Amazon RDS) com PostgreSQL para o estado das chaves virtuais e dos gastos, e também interage com o Amazon ElastiCache for Valkey como cache e com o AWS Secrets Manager para os segredos. Por fim, o LiteLLM invoca os Amazon Bedrock Application Inference Profiles por meio de uma role de tarefa do AWS Identity and Access Management (IAM) com escopo restrito, enquanto o Amazon CloudWatch registra as métricas de requisições por minuto (RPM) e tokens por minuto (TPM), junto com o alarme de cota.
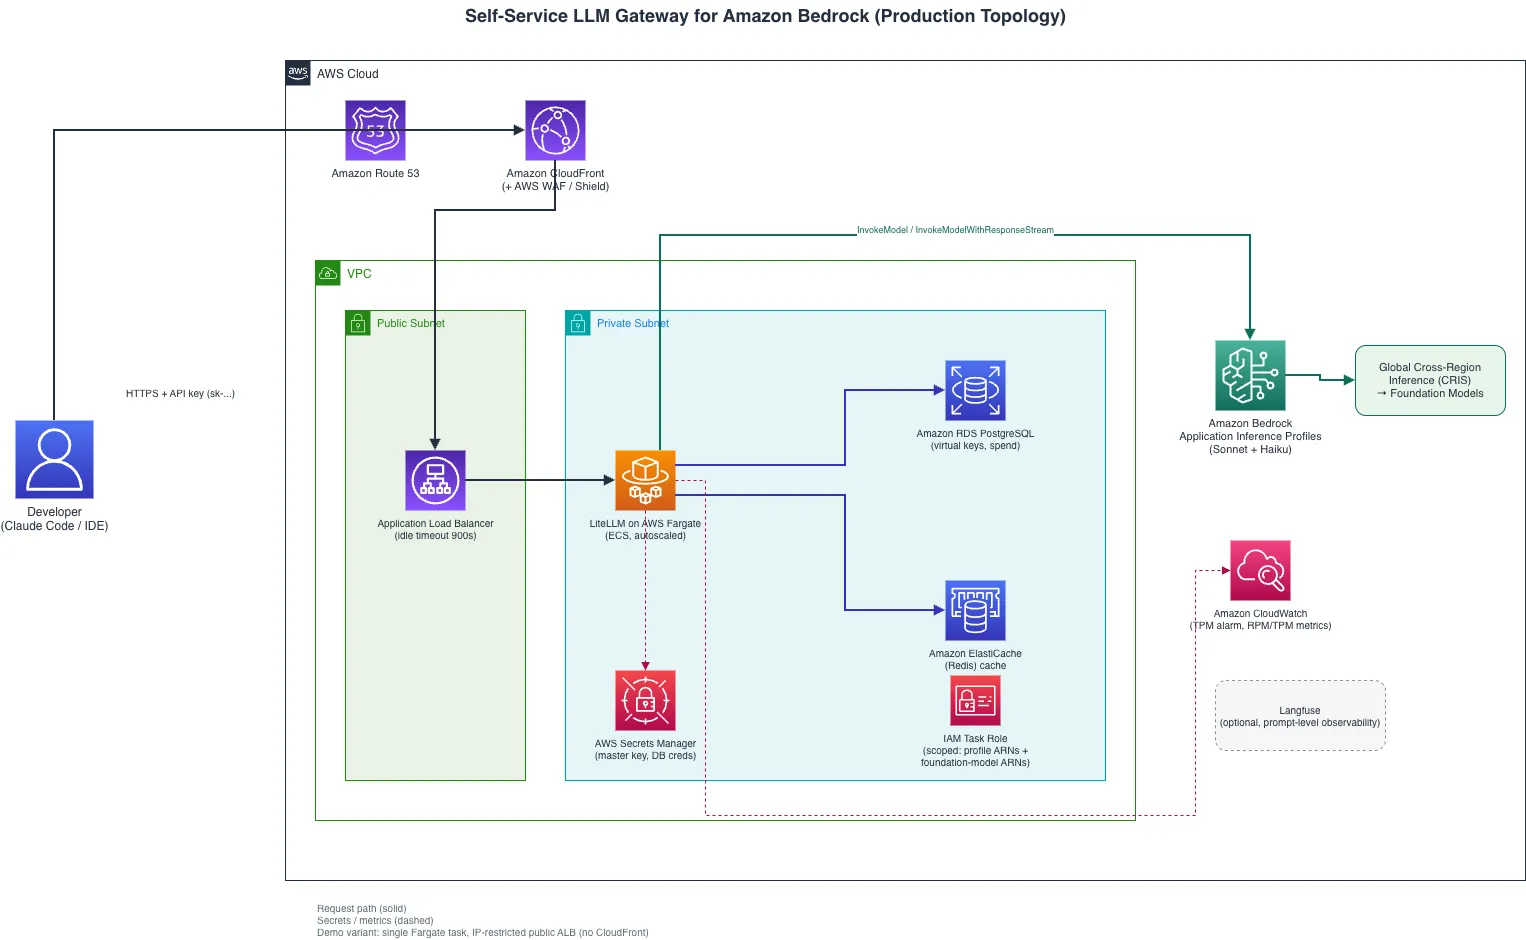
Os componentes principais são os seguintes:
LiteLLM no AWS Fargate. O LiteLLM fornece um proxy que expõe uma API compatível com OpenAI. Ele roda como uma tarefa do AWS Fargate com Auto Scaling de rastreamento de alvo sobre a utilização de CPU. Os desenvolvedores apontam suas ferramentas para esse endpoint e nunca interagem diretamente com o Amazon Bedrock.
Portal de autoatendimento. O LiteLLM inclui um portal leve para o autoatendimento de administradores e desenvolvedores, que pode ser integrado ao single sign-on (SSO) corporativo. Engenheiros de operações o usam para definir a política de gastos, e os desenvolvedores provisionam suas próprias chaves de API dentro desses limites.
Armazenamento persistente e cache. O LiteLLM usa o Amazon ElastiCache for Valkey para cache de respostas não persistente e para coordenar a limitação de taxa entre as tarefas do Fargate. Um banco de dados Amazon RDS (PostgreSQL) separado é o registro oficial do estado persistente, como metadados de chaves de API e o acompanhamento de gastos.
Amazon Bedrock Application Inference Profiles. Cada modelo — por exemplo, Claude Sonnet e Claude Haiku — recebe seu próprio perfil de inferência gerenciado pelo AWS CDK, o que oferece isolamento de cotas por modelo e uma camada de abstração limpa entre a configuração do LiteLLM e o versionamento de modelos do Amazon Bedrock.
Langfuse. Observabilidade de LLM de código aberto que oferece telemetria em nível de prompt, acompanhamento de latência e depuração; complementa as métricas de infraestrutura do CloudWatch com visão em nível de aplicação.
Como o gateway fala um protocolo compatível com OpenAI, os desenvolvedores configuram ferramentas como Claude Code, Continue e Cursor com uma única URL base e uma única chave de API. Assim, eles trabalham um nível acima do backend do Amazon Bedrock, de modo que é possível trocar modelos, adicionar fallbacks ou migrar de provedor de modelos sem tocar nas configurações dos desenvolvedores.
Pré-requisitos
O projeto exige uma conta da AWS, acesso a modelos do Amazon Bedrock, as permissões de IAM necessárias para a implantação e o próprio LiteLLM. O componente LiteLLM AI Gateway é de código aberto e atende a um piloto pequeno, com algumas limitações: o LiteLLM documenta o AI Gateway como gratuito para até cinco usuários, com licença obrigatória além disso. O LiteLLM Enterprise é a versão licenciada, escalável e voltada à produção, que adiciona single sign-on, logs de auditoria, papéis de administração delegados e suporte sobre o gateway de código aberto. O nível gratuito aceita chaves virtuais, mas a emissão de chaves em autoatendimento descrita neste artigo exige a versão Enterprise.
Configuração de ponta a ponta
Cada camada de configuração é percorrida em ordem, da máquina do desenvolvedor até o modelo de fundação.
Etapa 1: Configuração do IDE do desenvolvedor (Claude Code como exemplo)
O desenvolvedor aponta o assistente de codificação para o gateway de LLM; é a única mudança de configuração necessária na ferramenta:
{
  "apiProvider": "openai-compatible",
  "apiBaseUrl": "https://llm-gateway.internal.example.com/v1",
  "apiKey": "sk-user-abc123",
  "model": "claude-sonnet-4-20250514"
}
Cada desenvolvedor obtém sua própria chave de API no portal de autoatendimento e a insere na configuração da ferramenta.
Etapa 2: Configuração do gateway LiteLLM
Implante o LiteLLM em um serviço de contêineres seguindo a documentação do LiteLLM; neste exemplo é usado o AWS Fargate. A implantação inclui o portal, acessível em http://localhost:4000/ui durante os testes locais.
A configuração do gateway mapeia nomes de modelos para ARNs de perfis de inferência do Amazon Bedrock e aplica limites de gasto por chave:
model_list:
  - model_name: claude-sonnet-4-20250514
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/sonnet-profile-id
      aws_region_name: us-east-1
      max_retries: 3
      timeout: 900  # 15 min for extended thinking
    # REQUIRED for spend tracking: when `model` is a raw inference-profile ARN,
    # LiteLLM can't find it in its built-in cost map and defaults the cost to $0
    # which means per-key `spend` stays 0 and budgets NEVER enforce. Set the
    # per-token costs explicitly.
    model_info:
      input_cost_per_token: 0.000003        # example cost
      output_cost_per_token: 0.000015    # example cost
  - model_name: claude-haiku-4-5
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/haiku-profile-id
      aws_region_name: us-east-1
      timeout: 120
    model_info:
      input_cost_per_token: 0.000001       # example cost
      output_cost_per_token: 0.000005    # example cost
litellm_settings:
  max_budget: 250            # example per key cost
  budget_duration: 7d      # Rolling 7-day window
  max_parallel_requests: 10
  set_verbose: false
  cache: true
  cache_params:
    type: redis    # Valkey is protocol-compatible, so this stays "redis"
    host: elasticache-endpoint
    port: 6379
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
Ambos os valores são definidos na tarefa do Fargate a partir do AWS Secrets Manager:
LITELLM_MASTER_KEY=sk-platform-admin-... DATABASE_URL=postgresql://user:password@rds-endpoint:5432/litellm
Não grave a chave mestra nem as credenciais do banco de dados diretamente no config.yaml. O LiteLLM resolve as referências os.environ/VAR_NAME ao carregar o arquivo, portanto LITELLM_MASTER_KEY e DATABASE_URL devem ser definidas como variáveis de ambiente na tarefa do Fargate, vindas do AWS Secrets Manager. As credenciais do Langfuse da Etapa 5 são tratadas da mesma forma.
Quando um desenvolvedor chama claude-sonnet-4-20250514, por exemplo, o LiteLLM resolve esse nome para o ARN do perfil de inferência, autentica-se no Amazon Bedrock com a role de IAM da tarefa do Fargate e devolve a resposta em streaming no formato OpenAI.
Etapa 3: Perfis de inferência do Bedrock (CDK)
Os Amazon Bedrock Application Inference Profiles criam endpoints nomeados vinculados a modelos específicos, o que proporciona isolamento de cotas e controle de IAM granular.
Escolha da inferência entre regiões (CRIS): geográfica ou global. O CRIS do Amazon Bedrock elimina o trabalho de implementar por conta própria o roteamento de requisições entre regiões. Além disso, oferece acesso a um conjunto mais amplo de capacidade regional, roteamento automático das requisições para uma região compatível com capacidade disponível e uma seleção de modelos maior, porque alguns modelos só são acessíveis por meio de um perfil de inferência.
Para esse padrão de proxy, a recomendação é a inferência global entre regiões sempre que os modelos escolhidos a suportarem e as políticas da organização permitirem o processamento de inferência nas regiões comerciais da AWS compatíveis no mundo todo. A inferência geográfica entre regiões mantém o processamento dentro de uma geografia definida: um perfil de inferência dos EUA, por exemplo, roteia as requisições apenas para regiões compatíveis dos EUA. A inferência global entre regiões aproveita um conjunto mais amplo de capacidade regional e pode oferecer vantagens de preço em relação à opção geográfica. A disponibilidade de modelos, as cotas de serviço aplicáveis e os preços por modelo podem ser verificados na documentação atual da AWS e nas páginas de preços da AWS.
O construto de CDK:
import * as cdk from 'aws-cdk-lib';
import * as bedrock from 'aws-cdk-lib/aws-bedrock';
import * as iam from 'aws-cdk-lib/aws-iam';
// Create an Application Inference Profile pointing to the Global CRIS
// system-defined inference profile (note the `global.` prefix in the ARN).
const sonnetProfile = new bedrock.CfnApplicationInferenceProfile(this, 'SonnetProfile', {
  inferenceProfileName: 'claude-sonnet-gateway',
  modelSource: {
    copyFrom: `arn:aws:bedrock:us-east-1:${this.account}:inference-profile/global.anthropic.claude-sonnet-4-20250514-v1:0`,
  },
  description: 'Claude Sonnet for developer coding assistants (Global CRIS)',
});
// Grant LiteLLM's task role access to invoke the profile.
// For Global CRIS, include the inference profile, the regional FM, and the global FM resources.
litellmTaskRole.addToPolicy(new iam.PolicyStatement({
  effect: iam.Effect.ALLOW,
  actions: ['bedrock:InvokeModel', 'bedrock:InvokeModelWithResponseStream'],
  resources: [
    sonnetProfile.attrInferenceProfileArn,
    'arn:aws:bedrock:us-east-1::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
    'arn:aws:bedrock:*::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
  ],
}));
Dois detalhes são importantes aqui. Para o CRIS global, o ARN de copyFrom precisa referenciar o perfil de inferência definido pelo sistema que carrega o prefixo global., e não o ARN do modelo de fundação diretamente: usar o ARN do modelo de fundação cria um perfil de região única sem roteamento entre regiões. A política de IAM também precisa cobrir todos os ARNs de recursos que a invocação realmente toca: o perfil de inferência de aplicação mais o modelo de fundação subjacente em qualquer região para a qual possa ser roteado (com curinga de região). Limitar o escopo apenas ao ARN do perfil de inferência de aplicação falha no momento da invocação com "not authorized to perform: bedrock:InvokeModel on resource: arn:aws:bedrock:us-east-1::foundation-model/...". Continua sendo um escopo de privilégio mínimo, pois nomeia os modelos exatos em uso em vez de bedrock:* ou *.
Etapa 4: O Bedrock invoca o modelo de fundação
O perfil de inferência resolve o modelo e faz o roteamento entre regiões de forma transparente, sem configuração adicional. Quando o LiteLLM chama o ARN do perfil, o Amazon Bedrock envia a requisição para a capacidade disponível entre as regiões da AWS configuradas e retorna a resposta.
Etapa 5: Observabilidade com Langfuse
O LiteLLM se integra ao Langfuse por meio de callbacks de log, o que dá visibilidade às invocações de modelos sem alterar a configuração das ferramentas dos desenvolvedores. Para ativar a integração, mescle as seguintes entradas no bloco litellm_settings existente da configuração da Etapa 2, preservando os callbacks já presentes:
litellm_settings:
  success_callback: ["langfuse"]
  failure_callback: ["langfuse"]  # also log failed requests
Defina a chave pública, a chave secreta e o endpoint de implantação do Langfuse como variáveis de ambiente na tarefa do Fargate, armazenando as credenciais no AWS Secrets Manager:
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://us.cloud.langfuse.com  # or your self-hosted URL
O endpoint precisa corresponder à região do Langfuse Cloud selecionada ou à implantação auto-hospedada, e a escolha de hospedagem deve seguir os requisitos de governança de dados e de operação. Antes de ativar o registro de prompts e respostas, revise o que a integração captura e configure as medidas adequadas de redação, retenção e controle de acesso.
Dependendo da integração e da configuração de log, os traces do Langfuse podem incluir prompts, respostas, parâmetros do modelo, uso de tokens e latência. Essas informações ajudam a investigar respostas inesperadas do modelo e complementam as métricas operacionais coletadas no Amazon CloudWatch.
Implementação de controles de custo
O controle de custos é uma dimensão importante de uma estratégia de IA bem-sucedida. Sem ele, o uso intenso dos recursos de pensamento estendido pode gerar cobranças inesperadamente altas, algo que os autores observaram em seus pilotos iniciais.
Os limites de gasto configurados na Etapa 2 (max_budget: 250, budget_duration: 7d) aplicam uma janela móvel de sete dias por chave de API, desde que os custos model_info por modelo indicados na Etapa 2 estejam definidos. Quando um usuário atinge o limite, o LiteLLM responde com um código HTTP 429 e uma mensagem clara de que o orçamento foi excedido: sem degradação silenciosa nem fatura surpresa. O gasto atual e o momento de reinício podem ser consultados por qualquer um destes caminhos:
- Gasto diário: uma consulta a GET /user/daily/activity com um intervalo start_date e end_date retorna métricas por dia — gasto, tokens de prompt, tokens de conclusão e requisições de API — detalhadas por modelo, provedor e chave de API.
- Gasto por usuário: uma consulta a GET /user/info?user_id=… resume o gasto total de um usuário e o gasto de cada uma de suas chaves de API associadas.
- Painel do portal: a interface de administração em https:///ui inclui uma aba Usage em que desenvolvedores e administradores podem consultar gastos por modelo, usuário e tag sem chamar a API diretamente.
Esses mesmos endpoints permitem à equipe financeira obter a atribuição por usuário sem construir uma infraestrutura de medição própria. Um job agendado consultando /user/daily/activity ou /global/spend/report basta para alimentar um painel de custos ou um relatório de chargeback.
Portal de autoatendimento para desenvolvedores
O portal também gerencia o ciclo de vida das chaves. Os desenvolvedores se autenticam pelo SSO corporativo para gerar uma chave vinculada à sua identidade, que pode ser regenerada depois caso a chave seja exposta ou para cumprir uma política de rotação. Engenheiros de plataforma configuram a política de orçamento uma única vez, e cada desenvolvedor opera de forma autônoma dentro desses limites. Duas coisas que os desenvolvedores usam diretamente:
- Geração de chaves: na página Virtual Keys da interface de administração (https:///ui), desenvolvedores autenticados via SSO escolhem Generate Key para criar uma chave vinculada à sua identidade.
- Visibilidade de limites de taxa: toda resposta de /chat/completions traz os cabeçalhos x-litellm-key-remaining-requests-{model} e x-litellm-key-remaining-tokens-{model}, de modo que os desenvolvedores vejam a margem restante de RPM e TPM para aquele modelo diretamente na resposta da ferramenta. Isso é independente do acompanhamento de gastos em dólares descrito anteriormente.
Monitoramento e observabilidade
Em um gateway de LLM, métricas tradicionais como percentis de latência podem ser enganosas, sobretudo com modelos de pensamento estendido, em que uma única requisição pode levar vários minutos. Em vez disso, requisições por minuto e tokens por minuto servem como sinais principais, e o Amazon CloudWatch pode monitorá-los e gerar alarmes com a seguinte configuração:
new cloudwatch.Alarm(this, 'BedrockTPMAlarm', {
  metric: new cloudwatch.Metric({
    namespace: 'LiteLLM/Gateway',
    metricName: 'TokensPerMinute',
    statistic: 'Sum',
    period: cdk.Duration.minutes(1),
  }),
  // Alert at ~60% of your account's TPM quota (check Service Quotas for your
  // actual limit, defaults vary by model and account).
  threshold: 600000,
  evaluationPeriods: 3,
  comparisonOperator: cloudwatch.ComparisonOperator.GREATER_THAN_THRESHOLD,
  alarmDescription: 'TPM approaching Bedrock quota - request increase proactively',
});
O alarme dispara em torno de 60 a 70 por cento da utilização da cota, em vez de esperar pela limitação, o que deixa tempo para aumentar as cotas do Amazon Bedrock antes que os usuários percebam degradação.
Emissão da métrica. O LiteLLM não tem um callback embutido que publique uma métrica chamada TokensPerMinute em um namespace LiteLLM/Gateway, portanto o alarme precisa de uma fonte. Um pequeno callback de logger personalizado que chame PutMetricData do CloudWatch a cada requisição resolve isso. Ele deve ser registrado por litellm_settings.success_callback, que é aditivo, e não por callbacks, pois a lista callbacks substitui a lista interna de loggers do LiteLLM — que inclui o logger embutido de acompanhamento de gastos — e desativaria silenciosamente a aplicação de orçamentos.
Uma versão mínima desse callback, baseada na classe CustomLogger do LiteLLM:
import boto3
from litellm.integrations.custom_logger import CustomLogger
cloudwatch = boto3.client("cloudwatch")
class TPMEmitter(CustomLogger):
    async def async_log_success_event(self, kwargs, response_obj, start_time, end_time):
        total_tokens = kwargs.get("standard_logging_object", {}).get("total_tokens", 0)
        cloudwatch.put_metric_data(
            Namespace="LiteLLM/Gateway",
            MetricData=[{
                "MetricName": "TokensPerMinute",
                "Value": total_tokens,
                "Unit": "Count",
            }],
        )
# Register alongside success_callback, not in place of it:
import litellm
litellm.callbacks = [TPMEmitter()]
Para depuração em nível de prompt, o Langfuse roda ao lado do CloudWatch: quando um desenvolvedor relata que o modelo deu uma resposta ruim, o Langfuse permite inspecionar o prompt exato, as contagens de tokens e os parâmetros do modelo. Em ambientes sensíveis à conformidade, o log de invocações nativo do Amazon Bedrock para o Amazon Simple Storage Service (Amazon S3) fornece uma trilha de auditoria imutável.
Lições aprendidas em escala
Os autores implantaram o padrão de ponta a ponta em uma conta nova da AWS para confirmar que os trechos de exemplo funcionam e depois escalaram o gateway em sua própria implantação para várias centenas de desenvolvedores. As principais conclusões operacionais:
- O pensamento estendido muda tudo em relação à latência. Requisições que usam o pensamento estendido do Claude podem levar vários minutos ou mais, dependendo do orçamento de pensamento. Um balanceador de carga com tempo limite de ociosidade de 60 segundos descarta essas requisições silenciosamente. Os tempos limite de ociosidade do balanceador devem ser definidos em pelo menos 900 segundos, com o timeout de requisição do LiteLLM configurado de forma correspondente (timeout: 900 na configuração da Etapa 2).
- Em caso de limitação, recue e tente novamente com o mesmo modelo antes de acionar um fallback. O primeiro impulso — fazer fallback de Sonnet para Haiku ao sofrer limitação — mostrou-se subótimo para assistentes de codificação, porque trocar de modelo quebra o comportamento consistente do qual os desenvolvedores dependem. Em vez disso, tente novamente o mesmo modelo com backoff exponencial no proxy (max_retries: 3 na Etapa 2). Quando uma requisição não puder ser atendida após as novas tentativas, exiba o erro com clareza em vez de devolver conclusões de outro modelo.
- Separe o tráfego de automação do tráfego de desenvolvedores. Pipelines de integração e entrega contínuas (CI/CD) e ferramentas automáticas de revisão de código devem chamar o Amazon Bedrock diretamente com seus próprios perfis de inferência e cotas. Misturar tráfego de automação com tráfego interativo de desenvolvedores gera latência imprevisível e dificulta uma atribuição de custos significativa.
- Comece com o CRIS global desde o primeiro dia, se possível. A equipe usou inicialmente o CRIS geográfico (EUA) e migrou seus perfis de inferência ao atingir os limites de cota regionais. Sem restrições de residência de dados, pôde usar o CRIS global, que roteia as requisições entre regiões para aproveitar um conjunto de capacidade mais amplo e simplificar o gerenciamento em escala.
Considerações de implantação
Dois erros de configuração são comuns e difíceis de perceber até que os gastos ou a conectividade quebrem:
- Os custos por modelo são obrigatórios para aplicar orçamentos. O bloco model_info de cada modelo não é opcional se forem desejados controles de custo por usuário. Quando model aponta para um ARN de perfil de inferência do Bedrock, o LiteLLM não consegue localizá-lo em sua tabela de preços embutida e registra $0 por token, de modo que max_budget e a limitação com 429 nunca disparam e o gasto permanece em $0 independentemente do volume de tokens. A correção é definir input_cost_per_token e output_cost_per_token (ou input_cost_per_million_tokens).
- Banco de dados versus cache. database_url precisa ser PostgreSQL; as chaves virtuais do LiteLLM (/key/generate), store_model_in_db e o acompanhamento de gastos são baseados em Postgres.
Alguns detalhes menores completaram a checklist:
- O IAM do CRIS global precisa incluir os recursos do modelo de fundação, e não apenas o ARN do perfil de inferência de aplicação; caso contrário, a invocação é negada em tempo de execução.
- Dê memória suficiente à tarefa do Fargate: a imagem do gateway do LiteLLM fica sem memória e é encerrada com 512 MB (saída 137) antes de passar por uma verificação de integridade; cerca de 2 GB é um piso seguro.
- Sobrescreva o entryPoint do contêiner: o entrypoint da imagem oficial é litellm, portanto, se uma configuração for gerada na inicialização por um script de shell, defina entryPoint: ['/bin/sh','-c']; caso contrário, o script é passado como argumentos para o litellm.
- As descrições de roles do IAM e de grupos de segurança precisam ser ASCII; o IAM e o Amazon EC2 rejeitam travessões (em-dash) e sequências de setas.
- Confirme a disponibilidade do modelo na conta e na região. IDs de modelo e perfis de CRIS mudam; verifique com aws bedrock list-inference-profiles (a equipe usou claude-haiku-4-5 porque claude-haiku-3-5 não estava disponível).
Limpeza
Como o artigo percorre o padrão com trechos ilustrativos em vez de uma única stack implantável, não existe um comando único de desmontagem. Vários recursos, porém, continuam gerando cobrança enquanto rodam: o serviço do AWS Fargate, o Amazon RDS (PostgreSQL), o Amazon ElastiCache for Valkey e o Application Load Balancer, além dos segredos do Secrets Manager, dos alarmes do CloudWatch e dos perfis de inferência de aplicação do Bedrock de apoio. Remova-os ao terminar os testes para evitar cobranças contínuas.
Implantações feitas pelo Guidance for Multi-Provider Generative AI Gateway on AWS devem seguir as instruções de limpeza dessa solução; com o AWS CDK, execute cdk destroy, e com o AWS CloudFormation, exclua a stack. Para uma versão montada manualmente, remova cada recurso:
- Serviço e cluster do AWS Fargate: exclua o serviço do Amazon Elastic Container Service (Amazon ECS) para parar e drenar as tarefas e, em seguida, exclua o cluster.
- Application Load Balancer: exclua o ALB junto com seus listeners e target groups.
- Amazon RDS (PostgreSQL): exclua a instância de banco de dados; faça um snapshot final antes somente se precisar reter os dados de chaves de API e de gastos.
- Amazon ElastiCache for Valkey: exclua o grupo de replicação ou o cluster; ele contém apenas dados de cache, portanto nenhum snapshot é necessário.
- Perfis de inferência de aplicação do Amazon Bedrock: exclua os perfis criados na Etapa 3 removendo o construto do AWS CDK ou executando aws bedrock delete-inference-profile.
- Segredos do AWS Secrets Manager: agende a exclusão dos segredos do proxy, como a chave mestra e as credenciais do banco de dados.
- Alarmes e grupos de logs do Amazon CloudWatch: exclua o alarme de TPM e quaisquer grupos de logs do LiteLLM.
Exclua o serviço do Fargate e o ALB antes dos endpoints de RDS e ElastiCache dos quais dependem, para que as tarefas em execução não gerem erros contra backends já removidos durante a desmontagem.
Conclusão
O padrão descrito abstrai a arquitetura multimodelo do Amazon Bedrock em um gateway gerenciado centralmente que oferece às equipes acesso de autoatendimento escalável e observável. Como o Amazon Bedrock roteia entre modelos por uma única interface sem mudanças de infraestrutura, os desenvolvedores obtêm acesso imediato aos modelos de fundação por APIs familiares. As equipes de engenharia e segurança recebem governança de custos, observabilidade e um único plano de controle, enquanto a área financeira obtém atribuição por usuário sem infraestrutura de medição personalizada.
Os trechos de AWS CDK cobrem o perfil de inferência de aplicação do Bedrock, sua política de IAM e o alarme do CloudWatch; os recursos ao redor de Fargate, RDS, ElastiCache, ALB e Secrets Manager seguem padrões comuns do AWS CDK e não são mostrados. Para uma implementação completa e implantável, o Guidance for Multi-Provider Generative AI Gateway on AWS se alinha de perto a este padrão e está disponível na AWS Solutions Library com um post de blog e projetos no GitHub que o acompanham. Essa solução mais ampla adiciona suporte a múltiplos provedores, Amazon ECS ou Amazon Elastic Kubernetes Service (Amazon EKS), opções de Amazon CloudFront e AWS WAF e uma interface de administração; este artigo percorreu o mesmo padrão central focado no Amazon Bedrock para assistentes de codificação de desenvolvedores. Há documentação adicional sobre Amazon Bedrock Inference Profiles, o gateway LiteLLM, AWS Fargate e Langfuse. O caminho sugerido é pilotar o padrão com uma equipe, validar os controles de custo e escalar a partir daí.