Los desarrolladores quieren asistentes de codificación con IA que apenas requieran configuración. Combinar una puerta de enlace de modelos de lenguaje de gran tamaño (LLM) con LiteLLM les permite acceder rápidamente a los modelos de fundación (FM) disponibles en Amazon Bedrock, mientras la organización obtiene visibilidad y control sobre ese uso. Los equipos de plataforma deben supervisar la latencia y los errores, los equipos de finanzas deben atribuir los costos de inferencia a equipos y proyectos, y los equipos de seguridad necesitan controles de acceso coherentes. Una puerta de enlace de LLM puede ayudar a cubrir estas necesidades al actuar como un punto de acceso administrado de forma centralizada a los modelos que impulsan los asistentes de codificación.
Este artículo muestra cómo construir una puerta de enlace de LLM de autoservicio con los perfiles de inferencia de aplicaciones de Amazon Bedrock (Amazon Bedrock Application Inference Profiles) y LiteLLM ejecutándose en AWS Fargate, de modo que Amazon Bedrock quede oculto detrás de una API compatible con OpenAI. Con este patrón, los desarrolladores acceden a los modelos de fundación mediante una única API con una clave dedicada, y la organización obtiene controles de costos por usuario además de observabilidad del rendimiento de los modelos. La guía se apoya en fragmentos ilustrativos y construcciones de AWS Cloud Development Kit (AWS CDK), no en una pila desplegable completa; al final, el lector debería comprender el patrón lo suficiente como para crear su propia versión. Se utilizan los modelos Claude Sonnet y Claude Haiku como ejemplos; para consultar la lista de modelos y su disponibilidad por región de AWS, véase «Supported models by AWS Region» en la documentación de Amazon Bedrock.
El flujo de solicitudes es sencillo: el tráfico va del desarrollador, a través de la capa de LiteLLM, hasta Amazon Bedrock y el modelo de fundación subyacente. El siguiente diagrama ilustra la topología de producción detrás de ese flujo. El artículo no cubre la incorporación de Amazon Bedrock Guardrails, como el filtrado de contenido y la fundamentación, aunque normalmente se incluirían los controles de IA responsable adecuados antes de un despliegue en producción.
El cliente compatible con OpenAI del desarrollador llega a la puerta de enlace a través de Amazon Route 53, Amazon CloudFront y un Application Load Balancer (ALB), y se autentica en LiteLLM en Fargate con una clave de API por usuario. La solicitud utiliza Amazon Relational Database Service (Amazon RDS) con PostgreSQL para el estado de las claves virtuales y del gasto, y además interactúa con Amazon ElastiCache for Valkey como caché y con AWS Secrets Manager para los secretos. Finalmente, LiteLLM invoca los perfiles de inferencia de aplicaciones de Amazon Bedrock mediante un rol de tarea de AWS Identity and Access Management (IAM) con permisos limitados, mientras Amazon CloudWatch registra las métricas de solicitudes por minuto (RPM) y tokens por minuto (TPM), junto con la alarma de cuota.
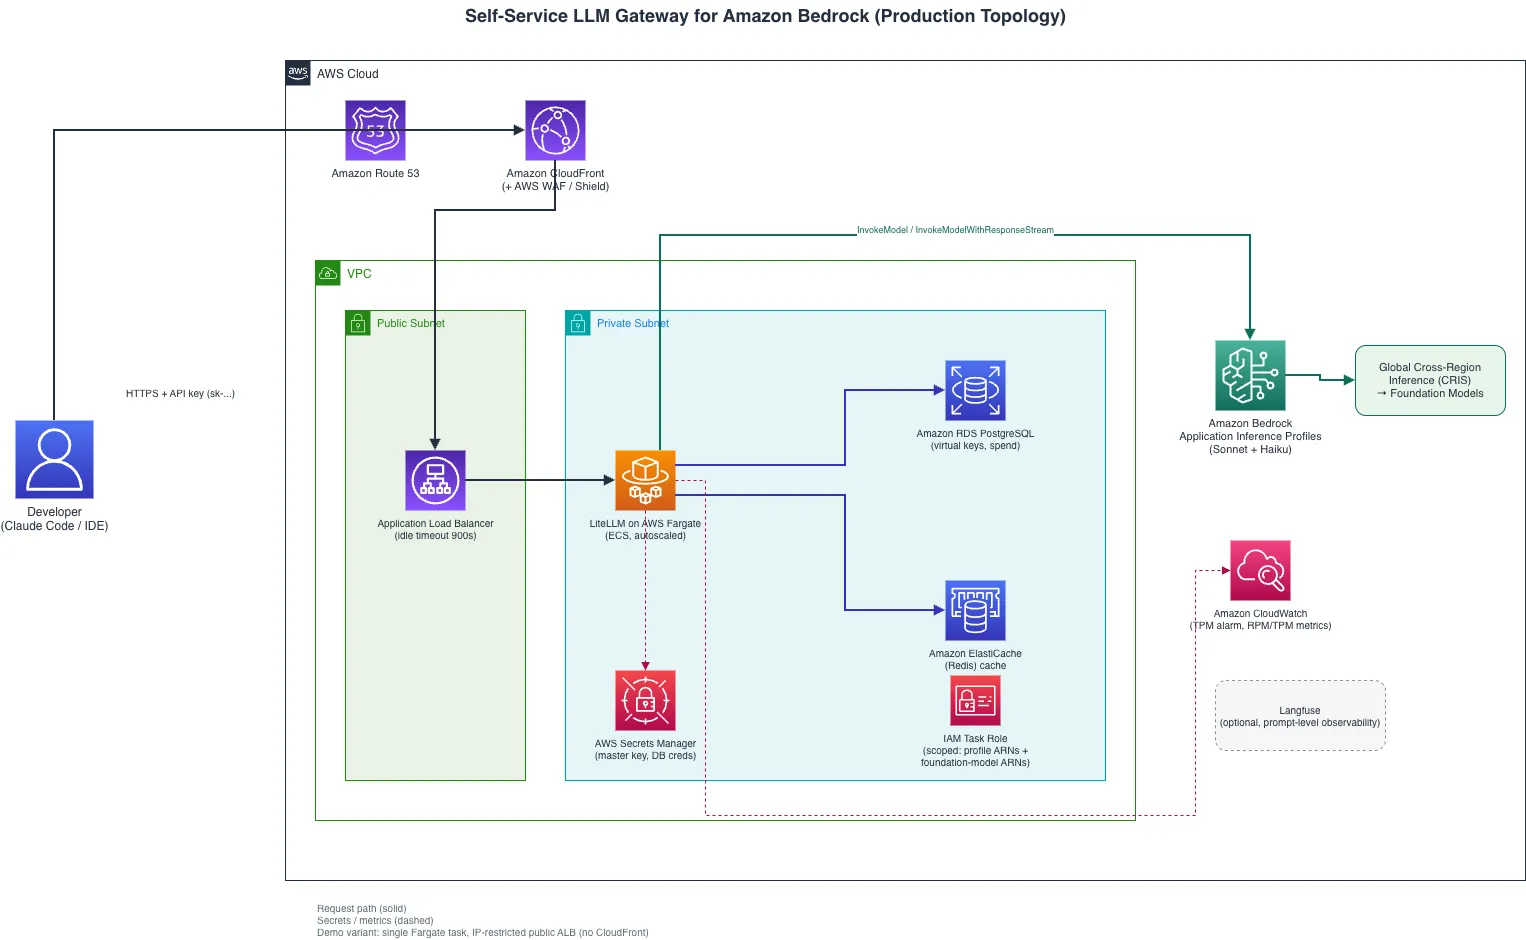
Los componentes principales son los siguientes:
LiteLLM en AWS Fargate. LiteLLM proporciona un proxy que expone una API compatible con OpenAI. Se ejecuta como una tarea de AWS Fargate con Auto Scaling de seguimiento de objetivos sobre la utilización de CPU. Los desarrolladores apuntan sus herramientas a este punto de enlace y nunca interactúan directamente con Amazon Bedrock.
Portal de autoservicio. LiteLLM incluye un portal ligero para el autoservicio de administradores y desarrolladores, que puede integrarse con el inicio de sesión único (SSO) corporativo. Los ingenieros de operaciones lo usan para definir la política de gasto, y los desarrolladores aprovisionan sus propias claves de API dentro de esos límites.
Almacenamiento persistente y caché. LiteLLM emplea Amazon ElastiCache for Valkey para el almacenamiento en caché no persistente de respuestas y para coordinar la limitación de velocidad entre las tareas de Fargate. Una base de datos Amazon RDS (PostgreSQL) independiente actúa como registro oficial del estado persistente, como los metadatos de claves de API y el seguimiento del gasto.
Perfiles de inferencia de aplicaciones de Amazon Bedrock. Cada modelo —por ejemplo, Claude Sonnet y Claude Haiku— recibe su propio perfil de inferencia administrado mediante AWS CDK, lo que ofrece aislamiento de cuotas por modelo y una capa de abstracción limpia entre la configuración de LiteLLM y el versionado de modelos de Amazon Bedrock.
Langfuse. Observabilidad de LLM de código abierto que aporta telemetría a nivel de prompt, seguimiento de latencia y depuración; complementa las métricas de infraestructura de CloudWatch con información a nivel de aplicación.
Al usar un protocolo compatible con OpenAI, los desarrolladores configuran herramientas como Claude Code, Continue y Cursor con una única URL base y una única clave de API. Así trabajan un nivel por encima del backend de Amazon Bedrock, de modo que se pueden cambiar modelos, añadir respaldos (fallbacks) o migrar de proveedor de modelos sin tocar las configuraciones de los desarrolladores.
Requisitos previos
El proyecto requiere una cuenta de AWS, acceso a modelos de Amazon Bedrock, los permisos de IAM necesarios para el despliegue y LiteLLM. El componente LiteLLM AI Gateway es de código abierto y sirve para un piloto pequeño, con algunas limitaciones: LiteLLM documenta AI Gateway como gratuito para hasta cinco usuarios, con licencia obligatoria a partir de ahí. LiteLLM Enterprise es la versión con licencia, escalable y orientada a producción, que añade inicio de sesión único, registros de auditoría, roles de administración delegados y soporte sobre la puerta de enlace de código abierto. El nivel gratuito admite claves virtuales, pero la emisión de claves en autoservicio descrita en este artículo requiere la versión Enterprise.
Configuración de extremo a extremo
Se recorre cada capa de configuración en orden, desde la máquina del desarrollador hasta el modelo de fundación.
Paso 1: Configuración del IDE del desarrollador (Claude Code como ejemplo)
El desarrollador apunta el asistente de codificación hacia la puerta de enlace de LLM; es el único cambio de configuración necesario en la herramienta:
{
  "apiProvider": "openai-compatible",
  "apiBaseUrl": "https://llm-gateway.internal.example.com/v1",
  "apiKey": "sk-user-abc123",
  "model": "claude-sonnet-4-20250514"
}
Cada desarrollador obtiene su propia clave de API en el portal de autoservicio y la coloca en la configuración de su herramienta.
Paso 2: Configuración de la puerta de enlace de LiteLLM
Despliegue LiteLLM en un servicio de contenedores siguiendo su documentación; en este ejemplo se usa AWS Fargate. El despliegue incluye el portal, accesible en http://localhost:4000/ui durante las pruebas locales.
La configuración de la puerta de enlace asigna nombres de modelos a ARN de perfiles de inferencia de Amazon Bedrock y aplica límites de gasto por clave:
model_list:
  - model_name: claude-sonnet-4-20250514
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/sonnet-profile-id
      aws_region_name: us-east-1
      max_retries: 3
      timeout: 900  # 15 min for extended thinking
    # REQUIRED for spend tracking: when `model` is a raw inference-profile ARN,
    # LiteLLM can't find it in its built-in cost map and defaults the cost to $0
    # which means per-key `spend` stays 0 and budgets NEVER enforce. Set the
    # per-token costs explicitly.
    model_info:
      input_cost_per_token: 0.000003        # example cost
      output_cost_per_token: 0.000015    # example cost
  - model_name: claude-haiku-4-5
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/haiku-profile-id
      aws_region_name: us-east-1
      timeout: 120
    model_info:
      input_cost_per_token: 0.000001       # example cost
      output_cost_per_token: 0.000005    # example cost
litellm_settings:
  max_budget: 250            # example per key cost
  budget_duration: 7d      # Rolling 7-day window
  max_parallel_requests: 10
  set_verbose: false
  cache: true
  cache_params:
    type: redis    # Valkey is protocol-compatible, so this stays "redis"
    host: elasticache-endpoint
    port: 6379
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
Ambos valores se definen en la tarea de Fargate a partir de AWS Secrets Manager:
LITELLM_MASTER_KEY=sk-platform-admin-... DATABASE_URL=postgresql://user:password@rds-endpoint:5432/litellm
No escriba la clave maestra ni las credenciales de la base de datos directamente en config.yaml. LiteLLM resuelve las referencias os.environ/VAR_NAME al cargar el archivo, por lo que LITELLM_MASTER_KEY y DATABASE_URL deben definirse como variables de entorno en la tarea de Fargate, procedentes de AWS Secrets Manager. Las credenciales de Langfuse del Paso 5 se gestionan de la misma manera.
Cuando un desarrollador llama a claude-sonnet-4-20250514, por ejemplo, LiteLLM resuelve ese nombre al ARN del perfil de inferencia, se autentica en Amazon Bedrock con el rol de IAM de la tarea de Fargate y devuelve la respuesta en streaming en formato OpenAI.
Paso 3: Perfiles de inferencia de Bedrock (CDK)
Los perfiles de inferencia de aplicaciones de Amazon Bedrock crean puntos de enlace con nombre vinculados a modelos específicos, lo que proporciona aislamiento de cuotas y un control de IAM detallado.
Elección de la inferencia entre regiones (CRIS): geográfica o global. Amazon Bedrock CRIS elimina el trabajo de implementar por cuenta propia el enrutamiento de solicitudes entre regiones. Además, ofrece acceso a un conjunto más amplio de capacidad regional, el enrutamiento automático de solicitudes a una región compatible con capacidad disponible y una selección de modelos más amplia, porque algunos modelos solo son accesibles a través de un perfil de inferencia.
Para este patrón de proxy se recomienda la inferencia global entre regiones cuando los modelos elegidos la admitan y las políticas de la organización permitan el procesamiento de inferencia en las regiones comerciales de AWS admitidas en todo el mundo. La inferencia geográfica entre regiones mantiene el procesamiento dentro de una geografía definida: un perfil de inferencia de EE. UU., por ejemplo, enruta las solicitudes solo a regiones de EE. UU. compatibles. La inferencia global entre regiones aprovecha un conjunto más amplio de capacidad regional y puede ofrecer ventajas de precios frente a la opción geográfica. La disponibilidad de modelos, las cuotas de servicio aplicables y los precios por modelo pueden verificarse en la documentación actual de AWS y en las páginas de precios de AWS.
La construcción de CDK:
import * as cdk from 'aws-cdk-lib';
import * as bedrock from 'aws-cdk-lib/aws-bedrock';
import * as iam from 'aws-cdk-lib/aws-iam';
// Create an Application Inference Profile pointing to the Global CRIS
// system-defined inference profile (note the `global.` prefix in the ARN).
const sonnetProfile = new bedrock.CfnApplicationInferenceProfile(this, 'SonnetProfile', {
  inferenceProfileName: 'claude-sonnet-gateway',
  modelSource: {
    copyFrom: `arn:aws:bedrock:us-east-1:${this.account}:inference-profile/global.anthropic.claude-sonnet-4-20250514-v1:0`,
  },
  description: 'Claude Sonnet for developer coding assistants (Global CRIS)',
});
// Grant LiteLLM's task role access to invoke the profile.
// For Global CRIS, include the inference profile, the regional FM, and the global FM resources.
litellmTaskRole.addToPolicy(new iam.PolicyStatement({
  effect: iam.Effect.ALLOW,
  actions: ['bedrock:InvokeModel', 'bedrock:InvokeModelWithResponseStream'],
  resources: [
    sonnetProfile.attrInferenceProfileArn,
    'arn:aws:bedrock:us-east-1::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
    'arn:aws:bedrock:*::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
  ],
}));
Aquí importan dos detalles. Para CRIS global, el ARN de copyFrom debe referenciar el perfil de inferencia definido por el sistema que lleva el prefijo global., y no el ARN del modelo de fundación directamente: usar el ARN del modelo de fundación crea un perfil de una sola región sin enrutamiento entre regiones. La política de IAM también debe cubrir todos los ARN de recursos que la invocación toca realmente: el perfil de inferencia de aplicación más el modelo de fundación subyacente en cualquier región a la que pueda enrutarse (con comodín de región). Limitar el alcance únicamente al ARN del perfil de inferencia de aplicación falla en el momento de la invocación con «not authorized to perform: bedrock:InvokeModel on resource: arn:aws:bedrock:us-east-1::foundation-model/...». Sigue siendo un alcance de privilegio mínimo, porque nombra los modelos exactos en uso en lugar de bedrock:* o *.
Paso 4: Bedrock invoca el modelo de fundación
El perfil de inferencia resuelve el modelo y enruta entre regiones de forma transparente, sin configuración adicional. Cuando LiteLLM llama al ARN del perfil, Amazon Bedrock envía la solicitud a la capacidad disponible entre las regiones de AWS configuradas y devuelve la respuesta.
Paso 5: Observabilidad con Langfuse
LiteLLM se integra con Langfuse mediante callbacks de registro, lo que ofrece visibilidad de las invocaciones de modelos sin cambiar la configuración de las herramientas de los desarrolladores. Para activar la integración, combine las siguientes entradas en el bloque litellm_settings existente de la configuración del Paso 2, conservando los callbacks que ya estén presentes:
litellm_settings:
  success_callback: ["langfuse"]
  failure_callback: ["langfuse"]  # also log failed requests
Defina la clave pública, la clave secreta y el punto de enlace de despliegue de Langfuse como variables de entorno en la tarea de Fargate, guardando las credenciales en AWS Secrets Manager:
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://us.cloud.langfuse.com  # or your self-hosted URL
El punto de enlace debe coincidir con la región de Langfuse Cloud seleccionada o con el despliegue autoalojado, y la elección del alojamiento debe seguir los requisitos de gobernanza de datos y operación. Antes de activar el registro de prompts y respuestas, revise lo que captura la integración y configure las medidas adecuadas de anonimización, retención y control de acceso.
Según la integración y la configuración de registro, las trazas de Langfuse pueden incluir prompts, respuestas, parámetros del modelo, uso de tokens y latencia. Esa información ayuda a investigar respuestas inesperadas del modelo y complementa las métricas operativas recopiladas en Amazon CloudWatch.
Implementación de controles de costos
El control de costos es una dimensión importante de una estrategia de IA exitosa. Sin él, el uso intensivo de las funciones de pensamiento extendido puede generar cargos inesperadamente altos, algo que los autores observaron en sus primeros pilotos.
Los límites de gasto configurados en el Paso 2 (max_budget: 250, budget_duration: 7d) aplican una ventana móvil de siete días por clave de API, siempre que se definan los costos model_info por modelo indicados en el Paso 2. Cuando un usuario alcanza su límite, LiteLLM responde con un código HTTP 429 y un mensaje claro de que se superó el presupuesto: sin degradación silenciosa ni factura sorpresa. El gasto actual y el momento de reinicio pueden consultarse por cualquiera de estas vías:
- Gasto diario: una consulta a GET /user/daily/activity con un rango start_date y end_date devuelve métricas por día —gasto, tokens de prompt, tokens de completado y solicitudes de API— desglosadas por modelo, proveedor y clave de API.
- Gasto por usuario: una consulta a GET /user/info?user_id=… resume el gasto total de un usuario y el gasto de cada una de sus claves de API asociadas.
- Panel del portal: la interfaz de administración en https:///ui incluye una pestaña Usage donde desarrolladores y administradores pueden consultar el gasto por modelo, usuario y etiqueta sin llamar directamente a la API.
Esos mismos puntos de enlace permiten al equipo de finanzas obtener la atribución por usuario sin construir una infraestructura de medición propia. Un trabajo programado que consulte /user/daily/activity o /global/spend/report basta para alimentar un panel de costos o un informe de contracargo.
Portal de autoservicio para desarrolladores
El portal también gestiona el ciclo de vida de las claves. Los desarrolladores se autentican con el SSO corporativo para generar una clave vinculada a su identidad, que pueden regenerar más adelante si la clave queda expuesta o para cumplir una política de rotación. Los ingenieros de plataforma configuran la política de presupuesto una sola vez, y cada desarrollador opera después de forma autónoma dentro de esos límites. Dos cosas que los desarrolladores usan directamente:
- Generación de claves: en la página Virtual Keys de la interfaz de administración (https:///ui), los desarrolladores autenticados mediante SSO eligen Generate Key para crear una clave vinculada a su identidad.
- Visibilidad de límites de velocidad: cada respuesta de /chat/completions incluye los encabezados x-litellm-key-remaining-requests-{model} y x-litellm-key-remaining-tokens-{model}, de modo que los desarrolladores ven el margen restante de RPM y TPM para ese modelo directamente en la respuesta de su herramienta. Esto es independiente del seguimiento de gasto en dólares descrito antes.
Supervisión y observabilidad
En una puerta de enlace de LLM, las métricas tradicionales como los percentiles de latencia pueden resultar engañosas, sobre todo con modelos de pensamiento extendido en los que una sola solicitud puede tardar varios minutos. En su lugar, las solicitudes por minuto y los tokens por minuto sirven como señales principales, y Amazon CloudWatch puede supervisarlas y generar alarmas con la siguiente configuración:
new cloudwatch.Alarm(this, 'BedrockTPMAlarm', {
  metric: new cloudwatch.Metric({
    namespace: 'LiteLLM/Gateway',
    metricName: 'TokensPerMinute',
    statistic: 'Sum',
    period: cdk.Duration.minutes(1),
  }),
  // Alert at ~60% of your account's TPM quota (check Service Quotas for your
  // actual limit, defaults vary by model and account).
  threshold: 600000,
  evaluationPeriods: 3,
  comparisonOperator: cloudwatch.ComparisonOperator.GREATER_THAN_THRESHOLD,
  alarmDescription: 'TPM approaching Bedrock quota - request increase proactively',
});
La alarma se dispara en torno al 60–70 por ciento de utilización de la cuota, en lugar de esperar a la limitación, lo que deja margen para ampliar las cuotas de Amazon Bedrock antes de que los usuarios noten degradación.
Emisión de la métrica. LiteLLM no incluye un callback integrado que publique una métrica llamada TokensPerMinute en un espacio de nombres LiteLLM/Gateway, así que la alarma necesita una fuente. Un pequeño callback de registrador personalizado que llame a PutMetricData de CloudWatch en cada solicitud cumple esa función. Debe registrarse a través de litellm_settings.success_callback, que es aditivo, y no mediante callbacks, porque la lista callbacks sustituye la lista interna de registradores de LiteLLM —que incluye el registrador integrado de seguimiento de gasto— y desactivaría silenciosamente la aplicación de presupuestos.
Una versión mínima de ese callback, basada en la clase CustomLogger de LiteLLM:
import boto3
from litellm.integrations.custom_logger import CustomLogger
cloudwatch = boto3.client("cloudwatch")
class TPMEmitter(CustomLogger):
    async def async_log_success_event(self, kwargs, response_obj, start_time, end_time):
        total_tokens = kwargs.get("standard_logging_object", {}).get("total_tokens", 0)
        cloudwatch.put_metric_data(
            Namespace="LiteLLM/Gateway",
            MetricData=[{
                "MetricName": "TokensPerMinute",
                "Value": total_tokens,
                "Unit": "Count",
            }],
        )
# Register alongside success_callback, not in place of it:
import litellm
litellm.callbacks = [TPMEmitter()]
Para la depuración a nivel de prompt, Langfuse se ejecuta junto a CloudWatch: cuando un desarrollador informa de que el modelo dio una mala respuesta, Langfuse permite inspeccionar el prompt exacto, los recuentos de tokens y los parámetros del modelo. En entornos sensibles al cumplimiento, el registro de invocaciones nativo de Amazon Bedrock hacia Amazon Simple Storage Service (Amazon S3) proporciona un rastro de auditoría inmutable.
Lecciones aprendidas a escala
Los autores desplegaron el patrón de extremo a extremo en una cuenta de AWS nueva para confirmar que los fragmentos de ejemplo funcionan, y después escalaron la puerta de enlace en su propio despliegue hasta varios cientos de desarrolladores. Las principales conclusiones operativas:
- El pensamiento extendido lo cambia todo en materia de latencia. Las solicitudes que usan el pensamiento extendido de Claude pueden tardar varios minutos o más según el presupuesto de pensamiento. Un balanceador de carga con un tiempo de inactividad de 60 segundos descartará esas solicitudes silenciosamente. Los tiempos de inactividad del balanceador deben fijarse en al menos 900 segundos, con el tiempo de espera de LiteLLM configurado en consecuencia (timeout: 900 en la configuración del Paso 2).
- Ante la limitación, retroceda y reintente con el mismo modelo antes de pasar a un respaldo. El primer impulso —cambiar de Sonnet a Haiku al producirse limitación— resultó subóptimo para los asistentes de codificación, porque cambiar de modelo rompe el comportamiento consistente del que dependen los desarrolladores. En su lugar, reintente el mismo modelo con retroceso exponencial en el proxy (max_retries: 3 en el Paso 2). Cuando una solicitud no pueda atenderse tras los reintentos, muestre el error con claridad en lugar de devolver los completados de otro modelo.
- Separe el tráfico de automatización del tráfico de desarrolladores. Las canalizaciones de integración y entrega continuas (CI/CD) y las herramientas automáticas de revisión de código deben llamar a Amazon Bedrock directamente con sus propios perfiles de inferencia y cuotas. Mezclar tráfico de automatización con tráfico interactivo de desarrolladores produce latencia impredecible y dificulta una atribución de costos significativa.
- Empiece con CRIS global desde el primer día si es posible. El equipo utilizó inicialmente CRIS geográfica (EE. UU.) y migró sus perfiles de inferencia al alcanzar los límites de cuota regionales. Al no tener restricciones de residencia de datos, pudo usar CRIS global, que enruta las solicitudes entre regiones para aprovechar un conjunto de capacidad más amplio y simplificar la gestión a escala.
Consideraciones de despliegue
Dos errores de configuración son habituales y difíciles de detectar hasta que el gasto o la conectividad fallan:
- Los costos por modelo son obligatorios para aplicar presupuestos. El bloque model_info de cada modelo no es opcional si se desean controles de costos por usuario. Cuando model apunta a un ARN de perfil de inferencia de Bedrock, LiteLLM no puede localizarlo en su tabla de precios integrada y registra $0 por token, de modo que max_budget y la limitación con 429 nunca se activan y el gasto permanece en $0 sin importar el volumen de tokens. La solución es definir input_cost_per_token y output_cost_per_token (o input_cost_per_million_tokens).
- Base de datos frente a caché. database_url debe ser PostgreSQL; las claves virtuales de LiteLLM (/key/generate), store_model_in_db y el seguimiento de gasto se basan en Postgres.
Varios detalles menores completaron la lista de comprobación:
- El IAM de CRIS global debe incluir los recursos del modelo de fundación, no solo el ARN del perfil de inferencia de aplicación; de lo contrario, la invocación se deniega en tiempo de ejecución.
- Asigne memoria suficiente a la tarea de Fargate: la imagen de la puerta de enlace de LiteLLM se queda sin memoria y es terminada con 512 MB (salida 137) antes de superar una comprobación de estado; unos 2 GB son un piso seguro.
- Sustituya el entryPoint del contenedor: el punto de entrada de la imagen oficial es litellm, así que si se genera una configuración al arrancar con un script de shell, defina entryPoint: ['/bin/sh','-c']; de lo contrario, el script se pasa como argumentos a litellm.
- Las descripciones de roles de IAM y grupos de seguridad deben ser ASCII; IAM y Amazon EC2 rechazan los guiones largos (em-dash) y las secuencias de flechas.
- Confirme la disponibilidad del modelo en la cuenta y la región. Los identificadores de modelo y los perfiles CRIS cambian; verifíquelo con aws bedrock list-inference-profiles (el equipo usó claude-haiku-4-5 porque claude-haiku-3-5 no estaba disponible).
Limpieza
Como el artículo recorre el patrón con fragmentos ilustrativos en lugar de una única pila desplegable, no existe un solo comando de desmantelamiento. Sin embargo, varios recursos siguen facturando mientras se ejecutan: el servicio de AWS Fargate, Amazon RDS (PostgreSQL), Amazon ElastiCache for Valkey y el Application Load Balancer, además de los secretos de Secrets Manager, las alarmas de CloudWatch y los perfiles de inferencia de aplicaciones de Bedrock de apoyo. Eliminélos al terminar las pruebas para evitar cargos continuos.
Los despliegues realizados mediante Guidance for Multi-Provider Generative AI Gateway on AWS deben seguir las instrucciones de limpieza de esa solución; con AWS CDK, ejecute cdk destroy, y con AWS CloudFormation, elimine la pila. Para una versión construida a mano, elimine cada recurso:
- Servicio y clúster de AWS Fargate: elimine el servicio de Amazon Elastic Container Service (Amazon ECS) para detener y drenar las tareas, y después elimine el clúster.
- Application Load Balancer: elimine el ALB junto con sus listeners y grupos de destino.
- Amazon RDS (PostgreSQL): elimine la instancia de base de datos; haga primero una instantánea final solo si necesita conservar los datos de claves de API y de gasto.
- Amazon ElastiCache for Valkey: elimine el grupo de replicación o el clúster; solo contiene datos de caché, por lo que no hace falta instantánea.
- Perfiles de inferencia de aplicaciones de Amazon Bedrock: elimine los perfiles creados en el Paso 3 quitando la construcción de AWS CDK o ejecutando aws bedrock delete-inference-profile.
- Secretos de AWS Secrets Manager: programe la eliminación de los secretos del proxy, como la clave maestra y las credenciales de la base de datos.
- Alarmas y grupos de registros de Amazon CloudWatch: elimine la alarma de TPM y cualquier grupo de registros de LiteLLM.
Elimine el servicio de Fargate y el ALB antes que los puntos de enlace de RDS y ElastiCache de los que dependen, para que las tareas en ejecución no generen errores contra backends ya eliminados durante el desmantelamiento.
Conclusión
El patrón descrito abstrae la arquitectura multimodelo de Amazon Bedrock en una puerta de enlace administrada de forma centralizada que ofrece a los equipos acceso de autoservicio escalable y observable. Como Amazon Bedrock enruta entre modelos a través de una única interfaz sin cambios de infraestructura, los desarrolladores obtienen acceso inmediato a los modelos de fundación mediante API conocidas. Los equipos de ingeniería y seguridad reciben gobernanza de costos, observabilidad y un único plano de control, mientras que finanzas obtiene atribución por usuario sin infraestructura de medición personalizada.
Los fragmentos de AWS CDK cubren el perfil de inferencia de aplicación de Bedrock, su política de IAM y la alarma de CloudWatch; los recursos circundantes de Fargate, RDS, ElastiCache, ALB y Secrets Manager siguen patrones estándar de AWS CDK y no se muestran. Para una implementación completa y desplegable, Guidance for Multi-Provider Generative AI Gateway on AWS se alinea estrechamente con este patrón y está disponible en AWS Solutions Library con una entrada de blog y proyectos de GitHub que la acompañan. Esa solución más amplia añade compatibilidad con múltiples proveedores, Amazon ECS o Amazon Elastic Kubernetes Service (Amazon EKS), opciones de Amazon CloudFront y AWS WAF, y una interfaz de administración; este artículo recorrió el mismo patrón central centrado en Amazon Bedrock para asistentes de codificación de desarrolladores. Existe documentación adicional sobre los perfiles de inferencia de Amazon Bedrock, la puerta de enlace de LiteLLM, AWS Fargate y Langfuse. El camino sugerido es pilotar el patrón con un equipo, validar los controles de costos y escalar a partir de ahí.