A Amplitude construiu seu negócio mostrando às equipes como as pessoas realmente usam seus produtos, e seu agente de produto proativo, o Wave, foi projetado para transformar esses insights em mudanças publicadas. Segundo a Amplitude, o Wave roda com modelos da OpenAI em cerca de 80% de sua carga de trabalho, utilizando o GPT-6.1 Sol, o GPT-6 Luna e o GPT-Image-2.5 Flare. O agente converte descobertas sobre o produto em planos de implementação que as equipes podem entregar a agentes de codificação, incluindo o Codex, e depois mede os resultados. A Amplitude estima que, com o Wave, as equipes podem lançar melhorias de produto em um ou dois dias em vez de cerca de um mês.
"A IA agora consegue encontrar trabalho útil que nunca pensamos em lhe atribuir. Os modelos da OpenAI podem investigar um problema, escrever e executar código e usar os resultados para decidir o que tentar em seguida", afirmou Spenser Skates, CEO da Amplitude.
Dos dados de produto às melhorias publicadas
As equipes direcionam o Wave a uma área de produto junto com as metas e métricas que desejam melhorar. O agente combina dados da Amplitude, repetições de sessões, feedback de clientes e código para identificar e priorizar oportunidades, desenvolver soluções e coordenar a implementação tanto com pessoas quanto com agentes de codificação. Em seguida, acompanha os resultados e usa o que aprende para informar a próxima rodada de melhorias.
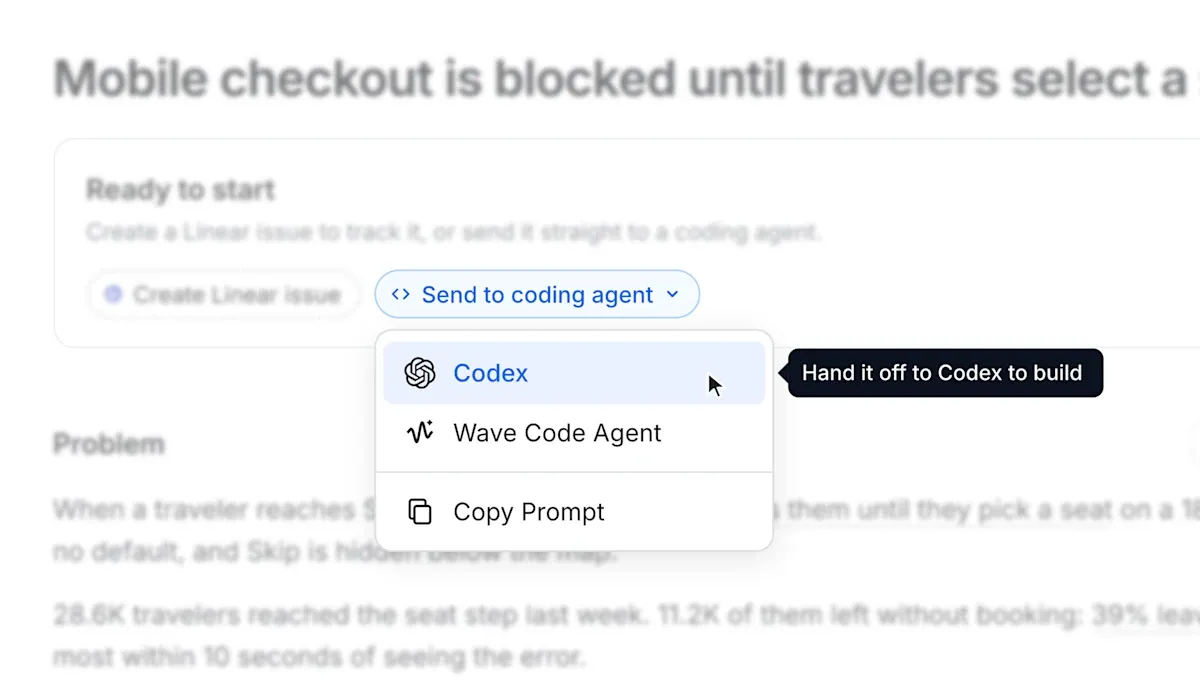
A Amplitude atribui modelos diferentes da OpenAI a partes diferentes desse fluxo de trabalho. O GPT-6.1 Sol alimenta o gerenciador de oportunidades e as investigações profundas em código e dados. O GPT-6 Luna cuida das tarefas frequentes e de baixo custo, como varrer código e executar pequenas verificações de avaliação. O GPT-Image-2.5 Flare gera maquetes de produto usando capturas de tela das repetições de sessões como referências visuais. Quando uma oportunidade está pronta para ser construída, as equipes podem enviá-la do Wave diretamente para agentes de codificação, incluindo o Codex, junto com um plano técnico e critérios de aceitação.
Como o Wave gerou um aumento de 160% no engajamento com o agente
"A ideia do Wave é ter uma plataforma unificada com agentes que vasculham quantidades enormes de repetições de sessões, análises e código para encontrar oportunidades de melhorar produtos", explica Jacob Newman, Principal AI Product Manager da Amplitude.
A Amplitude testou o Wave em sua própria página inicial, onde cartões de sugestões genéricos deveriam ajudar os visitantes a iniciar uma conversa com um agente de IA. O Wave descobriu que os usuários em grande parte os ignoravam: em uma amostra de 100 repetições de sessões, 80 pessoas digitaram suas próprias perguntas enquanto apenas 12 escolheram uma das sugestões.
O agente propôs personalizar os cartões com base em gráficos ou painéis recentes do usuário ou na página de onde ele tinha vindo. Ele produziu uma ilustração da mudança e um plano técnico que mantinha a digitação livre e voltava às sugestões genéricas sempre que não havia contexto de personalização disponível. Após uma breve revisão, a equipe entregou o trabalho a um agente de codificação e fez um teste A/B.
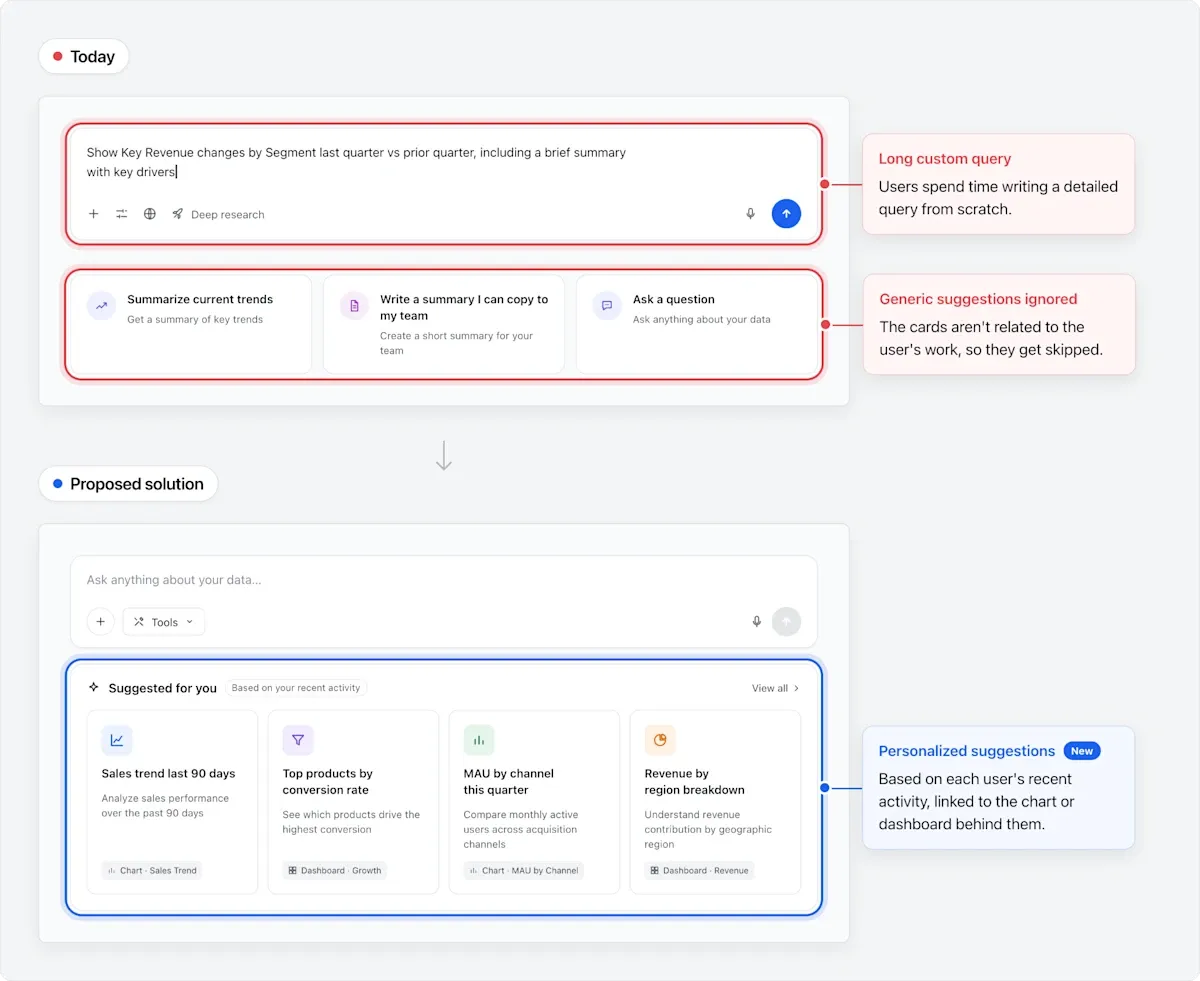
No relatório do experimento que a Amplitude compartilhou, as mensagens enviadas pelos cartões de sugestões da página inicial aumentaram 160% em relação ao controle após um dia. "É um ótimo exemplo de como coisas nada revolucionárias que simplesmente são ignoradas podem aumentar a adoção de recursos de maneiras inesperadas", explica Eric Carlson, Senior Principal AI Engineer da Amplitude.
Escolhendo o modelo da OpenAI certo para cada tarefa
As tarefas do Wave impõem exigências muito diferentes aos seus modelos: uma investigação profunda exige raciocínio forte e conclusões bem fundamentadas, enquanto uma pequena verificação repetida centenas de vezes precisa ser rápida e barata. A Amplitude avalia qualidade, latência e custo para cada tarefa e atribui os modelos de acordo.
"A OpenAI nos deu tanto modelos de raciocínio fortes quanto modelos menores e mais rápidos, para que pudéssemos equilibrar qualidade, latência e custo de inferência em todo o produto", afirmou Skates.
Para o Opportunity Investigator do Wave, a Amplitude avaliou se os modelos corroboravam as descobertas, evitavam falsos positivos, incorporavam o feedback dos avaliadores, se recuperavam de falhas de ferramentas e mantinham as afirmações alinhadas com as evidências. O GPT-6.1 Sol obteve pontuação geral de 4,06 em 5, contra 3,62, 3,52 e 2,94 de três modelos alternativos. Ele liderou os cinco critérios de investigação e registrou o tempo mediano de investigação mais rápido, de 54 minutos.
Em uma avaliação separada do Data Science Agent do Wave, o GPT-6.1 Sol marcou 67,5 em 100 contra 69,3 de outro modelo líder, enquanto seu custo médio de modelo foi de US$ 1,28 contra US$ 2,63 por envio. O GPT-6.1 Sol também pontuou mais alto em conformidade com o contrato de ferramentas, estimativa e incerteza e fundamentação em evidências.
Para o trabalho de alto volume, como varrer código e executar pequenas verificações de avaliação, a Amplitude usa o GPT-6 Luna para manter a latência e o custo baixos. Distribuir tarefas entre agentes especializados permite à equipe reservar o raciocínio mais caro para o trabalho que mais precisa dele. Na geração de wireframes e maquetes, o modelo de geração de imagens da OpenAI marcou 80,3 em 100 em wireframes de soluções contra 63,9 de outro modelo de geração de imagens; a avaliação cobriu qualidade de comunicação, fidelidade ao produto, adesão a instruções, legibilidade de texto e interface e coerência visual em 15 oportunidades.
Mantendo as equipes no comando do que é publicado
O Wave está em beta, e clientes de diversos setores já o usam para identificar e lançar melhorias de produto. O agente analisa dados de sessões e de análise e depois desenvolve recomendações que chegam com uma correção proposta, um plano técnico e critérios de aceitação.
As equipes decidem quanto de automação querem. A Amplitude diz que a maioria envia correções de bugs diretamente a agentes de codificação, enquanto novos recursos e apostas maiores passam por revisão humana. Quando as mudanças chegam ao lançamento, o caminho da descoberta à execução pode ser curto: entre experimentos, flags e guias lançados por clientes, um em cada quatro entrou no ar no mesmo dia em que o Wave apontou a oportunidade, metade em menos de quatro dias e dois em cada três em uma semana. A empresa apresenta esses números como marcos em uma curva ilustrativa, e não como observações individuais.
O que vem a seguir
"Nossa ambição com a OpenAI é fazer dos produtos que se autoaprimoram a maneira como as empresas constroem software", diz Skates. À medida que os modelos da OpenAI melhoram em raciocínio e codificação, ele espera que as equipes deleguem mais trabalho de investigação e implementação a agentes, o que, em sua visão, levará produtos melhores aos usuários mais rápido. A Amplitude diz que já está vendo esse padrão, com agentes encontrando e ajudando a entregar melhorias em seu próprio produto enquanto a equipe trabalha em outras prioridades: "Acho que as equipes vão se surpreender com o quanto podem realizar quando o software trabalha ao lado delas para tornar o produto melhor".