O que é
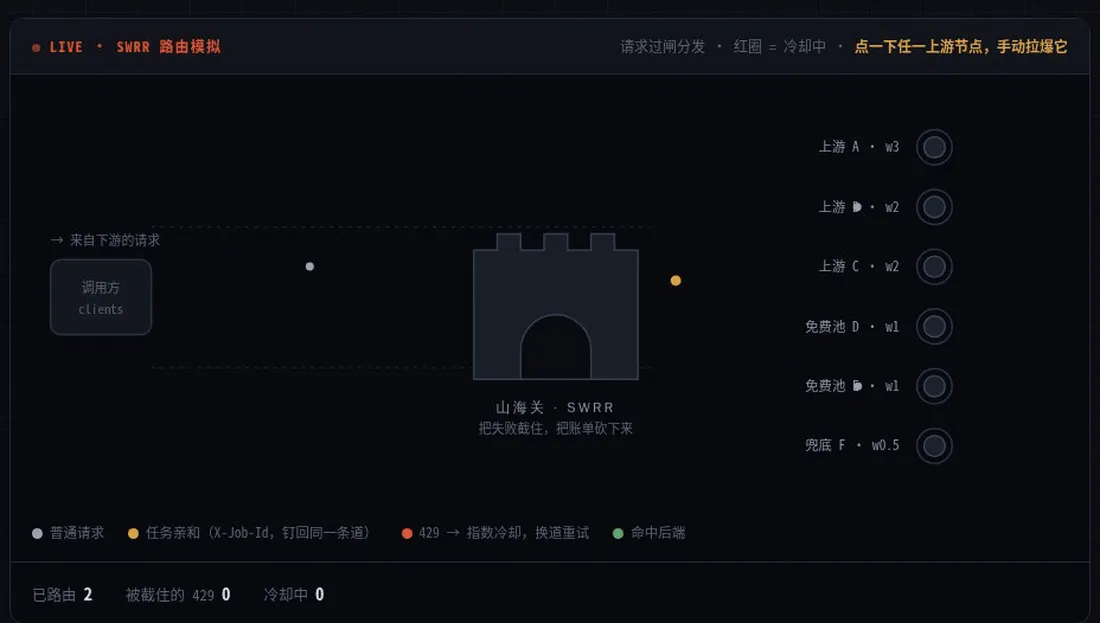
ShanHaiGateway é um gateway auto-hospedado escrito em Go que consolida vários provedores de modelos upstream atrás de um único endpoint compatível com OpenAI. O projeto está em github.com/ffseika0304/shanhai-gateway com seu site em seika.ltd, é distribuído sob licença MIT e seu endpoint de saúde reporta a versão 0.5.1. Seus mecanismos principais são o round robin ponderado suave (SWRR), o resfriamento exponencial para erros de cota, a afinidade de sessão em nível de tarefa, a observabilidade por retenção em sombra e uma implantação com Docker que o README descreve como três comandos até a produção.
Por que o autor o construiu
O autor descreve a motivação sem rodeios: quando provedores estrangeiros abrem níveis gratuitos de modelos, alguns usuários registram lotes de contas, esgotam a cota e até revendem o acesso até o provedor retirar a oferta. O autor afirma seguir um padrão semelhante de aproveitamento, com duas diferenças: ensina o método abertamente e não consome tudo de graça, gastando pouco mais de ¥100 por mês para manter a infraestrutura funcionando. Canais comerciais, cupons e pools gratuitos são misturados, o que é devido é pago e a capacidade gratuita absorve o resto. Em um teste de produção em outubro de 2026, o autor relata ter reduzido um volume mensal de 20 bilhões de tokens a uma conta em dinheiro de cerca de ¥170.
O README apresenta cada regra operacional como o resíduo de um incidente real, um tropeço trocado por uma regra, todas reunidas em uma tabela de semântica operacional em vez de saídas da teoria.
Problemas que ele ataca
O gateway trata de modos de falha que o autor encontrou ao fazer rodízio entre três provedores upstream:
- Um upstream instável derruba o produto inteiro com erros 503. Tentar de novo sem critério é grosseiro demais; as falhas precisam ser encaminhadas por classe de erro, com recuo exponencial para as de cota, fila para os backends saturados e apenas observação, sem punição, para as de rede.
- A taxa de acertos do cache de prefixos nunca sobe. A rotação simples joga o segundo turno de uma conversa para outro provedor, mas o cache de prefixos vive no lado do provedor, então trocar de provedor o anula. O autor mediu uma taxa de acertos de 51 a 56 por cento para grupos de mesmo prefixo sob rotação solta, exatamente a probabilidade de amostragem do pool, o que o README chama de teto do round robin.
- Um upstream removeu um modelo sem avisar e um backend de reserva girou em vazio com 0% de sucesso por quatro dias e meio antes de alguém perceber. Um 4xx não é necessariamente culpa do cliente; alguém precisa assumir essa classe de falha em nome do backend.
- Uma tempestade de desconexões produziu 1720 vezes 503: desconexões de clientes foram registradas como falhas de backend, os backends saudáveis entraram em resfriamento um após o outro e ao final não sobrou nenhum disponível.
- As chaves acabam espalhadas por toda parte e o repositório nunca pode ser mostrado em público.
Conjunto de recursos
- Round robin ponderado SWRR com isolamento da cadeia de reserva: peso, concorrência e tempo limite ajustáveis por backend, e os backends de reserva isolados do pool principal para não se contaminarem mutuamente.
- Resfriamento guiado por uma taxonomia de erros: respostas 403 e 429 recuam exponencialmente, 5 minutos, depois 10, dobrando até um teto de 4 horas; um backend saturado enfileira as requisições por até 60 segundos em vez de lançar um 503; desconexões de cliente não geram resfriamento.
- Afinidade de sessão em nível de tarefa: o gateway prefere o cabeçalho X-Job-Id e recorre ao X-Session-Key como reserva, fixando cada turno de uma tarefa no mesmo backend para que o cache de prefixos do provedor se torne a unidade de reutilização. O autor relata que a taxa medida subiu de 27% para 51%, com pico de 69%.
- Uma camada de quirks para comportamentos específicos de cada provedor: corpos de erro, chaves de uso e ajustes de saída próprios de um provedor vivem em um pacote dedicado (core/quirk); o núcleo não contém nenhum desvio por nome de provedor e upstreams sem quirks não precisam de configuração.
- Cobrança de chaves downstream multiusuário: emissão de cotas sk-user-*, login plugável sob um padrão de registro e um centro de usuários incluído.
- Observabilidade por retenção em sombra: um único banco SQLite registra attempts e captures, depurados automaticamente antes de serem gravados, com um painel detalhado em /api/stats.
- Recarga a quente da configuração: backends.json é recarregado por mudanças de mtime, de modo que pesos e backends podem ser alterados sem reiniciar.
- Um sidecar de autocura de ciclo lento: um processo Python independente, sem dependências de terceiros, toma decisões de limitação e degradação a partir de taxas de falha incrementais por janela, dividindo o trabalho com o caminho rápido do gateway.
- Sonda de janelas de cota com remoção automática: scripts/quota_probe.py consulta as janelas de cota de 5h/7d/30d de cada provedor agrupadas por nome de backend e grava um instantâneo em quota.json a cada 180 segundos; o sidecar avalia a cada 60 segundos, remove um backend cuja janela se esgota e o reincorpora quando volta a cair abaixo do limiar. Cada assinatura é medida de forma independente, então adicionar uma assinatura não toca nenhuma tabela de mapeamento.
- Implantação Docker: build multiestágio, SQLite em Go puro sem CGO, execução sem root, healthcheck e zero segredos dentro da imagem.
A afirmação sobre custos
Segundo o README, alguém executa o gateway em produção com 20 bilhões de tokens por mês a um custo em dinheiro de cerca de ¥170 mensais; o mesmo volume cobrado ao preço de tabela de cada provedor chegaria a cerca de $3.800 por mês, aproximadamente ¥26.600.
Os pools gratuitos sustentaram cerca de 63% do tráfego. O autor descreve como uma das capacidades centrais do gateway misturar cotas gratuitas e de brinde, muito instáveis, em um pool principal de alta disponibilidade: ele não distingue upstreams principais de auxiliares e despacha de forma totalmente aleatória. O resultado relatado é que os canais de pagamento puramente comerciais (Volcano Pro/Plan e similares) carregaram apenas cerca de 37% das requisições reais, enquanto os pools de modelos gratuitos incluídos em assinaturas baratas, os pools de proxy e as leituras de cache absorveram cerca de 63% do throughput.
Os 429 e travamentos dos pools gratuitos ficam isolados pelo disjuntor, um tempo limite bidirecional de 600 segundos e a classificação de falhas; apesar dos erros frequentes dos pools gratuitos, o negócio principal continuou vendo zero 429 de upstream. A resiliência vem de ambos os lados esgotarem o tempo aos 600 segundos: corte o lado que cortar, a requisição é reenviada por outra rota. Se o upstream corta, essa rota entra em resfriamento e a nova tentativa do chamador cai em outra; se o gateway esgota o tempo primeiro, troca de rota internamente e o chamador quase não percebe.
Cada assinatura adicional traz outro pool gratuito, já que toda assinatura Go vem com seu próprio pool de modelos gratuitos, de modo que a fração paga continua caindo (o autor a mediu cair de 43,6% para cerca de 37% após anexar mais uma assinatura) enquanto o throughput total cresce. A conta depende de qual canal é barato, não de quantos tokens são consumidos; os provedores são entradas de roteamento intercambiáveis na configuração, não pressupostos de arquitetura.
O detalhamento de conta do autor, com uma carga de produção de 1 bilhão de tokens por dia, combina repartição por roteamento, afinidade de cache (70% de acertos) e rotação contínua de cupons multiconta mais pools gratuitos para um gasto mensal em dinheiro de cerca de ¥170:
| Canal | Quantidade | Capacidade mensal de tokens | Dinheiro mensal |
|---|---|---|---|
| Assinaturas Volcano | 4 | 4 vezes 2 bilhões igual a 8 bilhões | Duas pagas em dinheiro por ¥99,8; as outras duas cobertas por dois cupons de canal de ¥50 (sobram ¥10) |
| opencode Go | 2 | 2 vezes 600 milhões de tokens pagos igual a 1,2 bilhão | Compradas de segunda mão pela metade do preço, $5 cada (cerca de ¥70) |
| Pools gratuitos de brinde, créditos ganhos, leituras de cache | — | Sustentaram os ~63% restantes | ¥0 |
Isso equivale a cerca de ¥0,85 por 100 milhões de tokens, e apenas 23% do volume foi cobrado como tokens novos a preço cheio; o mesmo volume a preço de tabela custaria cerca de $3.800 por mês. O autor afirma que o código por si só (afinidade de cache mais mistura de níveis gratuitos), junto com a repartição por tamanho de requisição na camada de configuração do pool, comprime a fração paga a preço de tabela para entre um quarto e um terço, e que a estratégia de canais eleva a redução total de custo a 99%.
Como ele consegue isso
- Afinidade de sessão interna: cada turno de uma tarefa (X-Job-Id, com reserva em X-Session-Key) é fixado de novo na mesma rota. Sob rotação solta a taxa medida de acertos para grupos de mesmo prefixo foi de 51 a 56 por cento, igual à probabilidade de amostragem do pool; após a fixação, o autor mediu uma subida de 27% para 51% com pico de 69%.
- Repasse de cabeçalho de sessão externo: uma opção session_header por backend (por exemplo x-opencode-session) grava o valor de sessão no cabeçalho próprio do fornecedor. Os caches de alguns fornecedores só reconhecem o próprio cabeçalho; o README diz que ativar o campo é uma mudança de uma linha em attempt.go, sem modificar código.
- Camada de quirks: corpos de erro, chaves de uso e ajustes de saída próprios de cada provedor vão para internal/core/quirk enquanto o núcleo mantém zero desvios por nome. Um upstream sem quirks não precisa de configuração, e o comportamento sem a camada de quirks é idêntico bit a bit ao de um upstream genérico.
- Medição independente por assinatura com remoção automática por janela de cota: a sonda consulta as janelas de 5h/7d/30d agrupadas por nome de backend e grava um instantâneo quota.json a cada 180 segundos; o sidecar julga a cada 60 segundos. Rotacionar uma assinatura que expira é questão de desativar uma e ativar outra, escalonadas para que cada uma seja consumida por completo sem derrubar a concorrência.
- Repartição por tamanho de requisição, feita na camada de configuração do pool e não no núcleo: requisições pequenas vão para pools cobrados por token e as grandes para pools cobrados por requisição, com um ponto de equilíbrio medido em 22.222 tokens; o autor relata economia de 35%.
- Mistura de canais gratuitos e de baixo custo: os pools gratuitos rodam no mesmo pool que os canais comerciais; a instabilidade é aceitável precisamente porque o colapso de um pool gratuito não afeta o negócio principal.
Adicionar uma assinatura leva dois passos e o resto é automático. Primeiro, adiciona-se uma entrada em accounts[] com um nome único, api_keys[] para as chamadas e credenciais de consulta de cota (AK/SK entregues com a configuração de implantação; se faltarem, o painel informa credenciais ausentes e não age, nunca pegando emprestadas as de outra conta). Segundo, adiciona-se um backend em backends[] cujo base_url aponte para o endpoint do plano daquele provedor e cujo account referencie a primeira entrada. A mudança é carregada a quente em cerca de 30 segundos, a sonda começa a consultar suas janelas de cota por nome de backend e o sidecar passa a gerenciar remoção e reincorporação.
As ressalvas do próprio autor
O README insiste que seus números sejam lidos junto com cinco qualificações:
- Preços promocionais têm prazo de validade: cupons e ofertas pela metade do preço podem acabar a qualquer momento; voltar aos preços normais custaria cerca de ¥340 por mês, ainda uma redução de mais de 98%.
- O número de "gratuito e de baixo custo sustenta 63%" flutua com a generosidade do upstream e as taxas de obtenção; a faixa medida foi de 37% a 57%, maior contando as leituras de cache, e nenhuma fração específica é prometida.
- As cotas gratuitas e de brinde são concedidas pelos provedores upstream, não por este projeto. O que o projeto mantém em código aberto permanentemente é a afinidade de cache, a nova tentativa com troca de rota e a medição independente por assinatura com remoção automática.
- Os números são medições de produção em uma única máquina de 2026-10 (consumo diário de 441,3 milhões de tokens), na mesma base de cálculo da tabela de conta; o método de medição está documentado em registros de calibração publicados com a versão.
- Nenhum fornecedor fica preso: a fração do pool principal oscilou entre 11% e 43% em três dias, mudando apenas contas e pesos na configuração, enquanto roteamento, afinidade de cache e lógica de reserva permaneceram intocados.
Início rápido
Docker é o caminho recomendado. O contêiner escuta por padrão na porta :18016 do host, substituível com SHG_PORT:
git clone https://github.com/ffseika0304/shanhai-gateway.git && cd shanhai-gateway
mkdir -p runtime/config runtime/data
cp config/backends.example.json runtime/config/backends.json   # edite seus backends
cp config/keys.example.json    runtime/config/keys.json        # edite suas chaves downstream
docker compose -f deploy/docker-compose.yml up -d --build
curl -s http://127.0.0.1:18016/health          # {"status":"ok","version":"0.5.1"}
curl -s http://127.0.0.1:18016/api/stats | head -c 400
Executar o binário diretamente exige Go 1.27 ou superior:
make build                          # equivalente a go build -o shg ./cmd/shg
cp config/backends.example.json config/backends.json   # credenciais falsas servem para a primeira execução
export LISTEN=":18006"              # porta LAN sem cobrança
export ROUTER_VALIDATE=0            # pula a autoverificação de inicialização (remova com chaves reais)
./shg &
curl -s http://127.0.0.1:18006/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"demo-model","messages":[{"role":"user","content":"hi"}]}'
Uma resposta 200 significa que o caminho está aberto; GET /health é a verificação de saúde e GET /api/stats o painel de tráfego. A porta LAN não exige chave para POST /v1/chat/completions; a cobrança por chave downstream só é ativada na porta pública e no centro de usuários. As duas formas de implantação compartilham a mesma semântica de caminhos: a execução direta lê arquivos reais (ignorados pelo git) de /config/ e guarda dados em ~/.local/share/shg/, enquanto o Docker monta ./runtime/config/ em /etc/shg e ./runtime/data/ em /var/lib/shg. Ambas se identificam como shg/0.5.1 no user agent, /healthz e nos prefixos de log, e ambas recarregam a configuração por mtime.
Arquitetura
As dependências apontam em um só sentido, de api para service e para core, enquanto config e runtime atuam como camadas de alimentação horizontais que não dependem nem uma da outra nem de service. cmd/shg apenas monta: ambiente, caminhos, diretórios, SQLite e dois listeners.
- internal/api — os portões HTTP do plano de controle: o portão LAN sem cobrança e o portão público (portão de painel mais chave), além de centro de usuários, admin, dashboard e portões públicos. Quem pode entrar não tem relação com como uma requisição é roteada; mudar entradas ou frontends só toca este pacote.
- internal/service — negócio do plano de dados e do de controle: routing (rotação ponderada, filtragem de candidatos, isolamento de reserva, troca atômica), proxy (reescrita de requisições, streaming, tempo limite em fila, detecção de desconexão), auth (provedores de login plugáveis) e apikey (cobrança de chaves downstream). Um algoritmo de roteamento pode ser substituído por P2C ou least-connections sem que core nem o formato de configuração o acompanhem; um novo método de login é apenas um novo arquivo de provedor.
- internal/core — errclass é a única fonte de verdade para a classificação de erros de upstream mais o vocabulário global, e uma única definição deve servir ao mesmo tempo a resfriamento, disjuntor, estatísticas e reserva; quirk; upstream guarda a máquina de estados de capacidade e saúde do backend (vagas de concorrência, disjuntor, resfriamento exponencial, contadores de falha por classe) cujos números mágicos foram ajustados cada um por um incidente de produção; store é o único banco SQLite com um único ponto de escrita, de modo que a evolução do esquema e a lógica de negócio não se arrastam mutuamente.
- internal/config — o que conta como backend legal, o pipeline de carga, validação e recarga por mtime, e a lista negra da autoverificação.
- internal/runtime — a identidade do programa e seus locais em disco: caminhos, env, rotação de logs, varredura e manutenção do SQLite.
cmd/shg foi feito para permanecer fino para sempre: a lógica de negócio desce de camada e ali só vive a ordem de inicialização e desligamento.
Um backends.json mínimo tem este aspecto (todas as credenciais falsas; o conjunto completo de campos está em config/backends.example.json):
{
  "accounts": [
    { "name": "vendor-a", "base_url": "https://api.example-llm.com/v1",
      "api_keys": ["sk-xxxxx"] }
  ],
  "backends": [
    {
      "name": "vendor-a-main",
      "account": "vendor-a",
      "model": "demo-model",
      "base_url": "https://api.example-llm.com/v1",
      "weight": 1,
      "concurrency": 8,
      "enabled": true,
      "is_primary": true
    }
  ]
}
Variáveis de ambiente: GATEWAY_DATA_DIR define a raiz de dados (padrão ~/.local/share/shg), GATEWAY_CONFIG_DIR o diretório de configuração (padrão /config), GATEWAY_DB_FILE o arquivo SQLite principal (/shg.db), GATEWAY_BACKENDS_FILE o arquivo base de backends (/backends.json), GATEWAY_KEYS_FILE o livro-razão de chaves downstream (/keys.json) e GATEWAY_QUOTA_FILE o instantâneo de cotas (/quota.json). ROUTER_BACKENDS injeta configuração JSON diretamente com prioridade sobre os arquivos; ROUTER_VALIDATE vale 1 por padrão e pula a autoverificação de inicialização em 0; LISTEN e LISTEN_PUBLIC valem por padrão :18006 e sem escuta; SESSION_AFFINITY está ativa por padrão e desativá-la deixa o comportamento idêntico bit a bit ao de um gateway sem afinidade — AFFINITY_TTL, AFFINITY_MAX e AFFINITY_CONTENTION_LIMIT controlam a vida das entradas, a capacidade LRU e o limiar de migração por saturação (6h, 8192 e 3). REASONING_EFFORT vale low por padrão: quando o cliente não definiu explicitamente reasoning_effort, o gateway injeta um valor padrão para limitar os orçamentos de raciocínio dos modelos pensantes, respeita um valor explícito do cliente e uma string vazia desativa a injeção; um guarda detecta um valor já injetado por um gateway anterior para que implantações em cadeia nunca injetem duas vezes.
O prefixo é GATEWAY_* e não SHG_* porque o contrato do sidecar (py/sidecar.py lê GATEWAY_BACKENDS_FILE e GATEWAY_QUOTA_FILE) está ancorado nesses nomes; a identidade da aplicação vive em internal/runtime/identity.go como AppName "shg". backends.blocked.json não tem variável própria: compartilha o diretório de backends.json e deve se mover com ele.
Segredos e higiene de dados
Nenhum segredo é distribuído no repositório nem na imagem: os arquivos reais backends.json, keys.json, backends.blocked.json e quota.env estão todos no gitignore e só existem nos locais de execução, enquanto o repositório só contém modelos .example.json. Os dados (.db, logs) nunca são commitados, porque os captures contêm texto de requisições em bruto e contam como dados em produção, não como configuração; a recuperação de desastres significa portanto código mais o diretório de configuração em execução. Qualquer chave real que apareça no repositório é tratada como bug e redigida na hora.
Semântica operacional: regras destiladas de incidentes
O README mantém uma tabela de regras onde cada entrada cita o incidente que a produziu; SLR se refere ao roteador frontal anterior do projeto, seika_llm_router, substituído por inteiro por este gateway, cujas entradas são conservadas como história semântica.
- Desconexões de cliente nunca disparam resfriamento. Uma tempestade de desconexões em 03.10.2026 produziu 1720 vezes 503: as desconexões foram registradas como falhas de backend, os backends saudáveis resfriaram um a um e o pool inteiro secou. As desconexões são classificadas como eventos de rede apenas para observação, isentas de resfriamento e de disjuntor.
- Um modelo inexistente é culpa do backend. Quando um upstream removeu um modelo sem avisar, o gateway mostrou comportamento de 4xx e buraco negro; desde 06.10.2026 um backend de reserva girou em vazio com 0% de sucesso por quatro dias e meio antes de ser descoberto. Esse 4xx não pode ser cobrado do cliente; recai sobre o backend responsável para resfriamento ou remoção de reserva, com a identidade corrigida via model_expire e model_fallback.
- Erros de cota recuam exponencialmente; saturação enfileira. Respostas 403 e 429 resfriam 5 minutos, depois 10, dobrando até um teto de 4 horas em vez de bater repetidamente; um backend cheio enfileira até 60 segundos (QUEUE_WAIT) em vez de responder 503.
- A lista negra só é escrita e limpa à mão. backends.blocked.json é a lista da autoverificação de inicialização de upstreams permanentemente mortos; não há caminho de desbloqueio automático, porque a limpeza automática usaria a taxa de falhas como evidência enquanto a lista negra repousa em fatos de sondagem, então as entradas exigem revisão humana e remoção do arquivo.
- Strikes só zeram com sucesso. A tempestade de autobloqueio 403 de 01.10.2026: zerar o strike antes de a cota se recuperar deixou o backend voltar ao pool, falhar outro 403 na hora e reentrar em resfriamento em loop. Toda a cadeia de recuo exponencial depende de strikes consecutivos serem zerados somente pelo sucesso, então o endpoint de edição a quente do admin deliberadamente não oferece campo de strike.
- Afinidade de sessão é uma camada de preferência sobre a rotação. Em 10.10.2026 a produção mediu 0% de acertos de cache de prefixos porque o SWRR dispersava os turnos de uma conversa entre provedores cujos caches vivem no lado do provedor. Sessões estabelecidas são fixadas no mesmo backend; as novas continuam caindo por peso SWRR. A tabela de afinidade só é escrita após uma entrega final bem-sucedida para que sessões falhas não fiquem presas a backends ruins, e o despejo e a retenção compartilham fonte com o resfriamento e o disjuntor (errclass.ReleaseAffinity) em vez de uma segunda camada de saúde. As chaves de afinidade preferem X-Job-Id, em nível de tarefa, com todos os turnos de uma tarefa compartilhando um id —exatamente a unidade de reutilização do cache de prefixos— e recorrem a X-Session-Key.
- Quirks de cada fornecedor vão para a camada de quirks; o núcleo nunca desvia por nome. Tropeços anteriores foram generalizados em regras universais —remoção incondicional de Content-Length, modificar apenas a chave model, o campo session_header e um vocabulário genérico—, mas um tropeço não generalizável não deve nem ser incorporado às regras compartilhadas onde prejudicaria outros fornecedores nem tratado como verificações de nome espalhadas pelo núcleo. O terceiro caminho é internal/core/quirk/xxx.go consultado em três costuras fixas.
- O contrato de observabilidade espelha o SLR. A tabela attempts carrega uma coluna job_id, migrada de forma idempotente via ALTER em bancos existentes, para que os scripts de atribuição por job e de análise de cache continuem funcionando sem mudanças; /api/stats expõe um objeto affinity{hits,misses,puts,pinned_jobs} com formato de SLR onde pinned_jobs toma o comprimento bruto da tabela (Len deve preceder CountPerBackend, que de passagem limpa entradas TTL), e as três chaves sticky_* são conservadas como nomes históricos que o painel ainda lê. puts conta cada Put real incluindo as atualizações do mesmo backend, idêntico bit a bit ao SLR.
- Instâncias só são levantadas pelo gerenciador de serviços, nunca à mão. Em 21.10.2026 outro agente lançou ./slr manualmente e desacoplado (PPID=1), ocupando as portas 18006 e 18012; a instância do systemd não conseguiu fazer bind e entrou em loop de quedas, deixando o painel instável o dia todo. Três regras acompanhantes: esperar a porta antes de iniciar e reportar o PID que a ocupa; o desligamento elegante pode reter a porta até 600 segundos (o timeout de um backend), então a unidade precisa de TimeoutStopSec=45 mais Restart=always; mudanças de frontend são go:embed, então é preciso recompilar o binário e parar o serviço antes, porque um executável em execução não pode ser sobrescrito. Após a implantação é preciso verificar o estado estável —ActiveState, NRestarts sem crescer, o PID dono da porta pertencendo ao serviço— porque um curl logo após o reinício pode ser respondido pela instância velha.
A camada de quirks
O núcleo a invoca em exatamente três costuras fixas do ciclo de vida da requisição:
- Decorate(req, backend) roda na saída, após a limpeza genérica de cabeçalhos (remover Content-Length, credenciais de cliente e Accept-Encoding, fixar Content-Type e o user agent) e antes de enviar ao upstream; pode adicionar cabeçalhos ou parâmetros de consulta do fornecedor e aparar o corpo condicionalmente. O comportamento padrão é no-op.
- Classify(status, body) (Class, bool) roda durante a classificação; retornar (Class, false) significa que o caso não é reivindicado e o chamador recorre ao julgamento genérico, deixando que um fornecedor seja dono apenas das próprias frases sem sequestrar o vocabulário compartilhado. O padrão reivindica 400 e 404 mais o vocabulário genérico de modelo removido, que continua vivendo em errclass.
- ParseUsage(body) Usage roda durante a análise de uso; OK=false recorre ao padrão OpenAI. O padrão analisa o usage da OpenAI mais prompt_tokens_details.cached_tokens.
Um driver ausente ou não registrado recai no singleton OpenAI em nível de pacote, idêntico bit a bit a não ter a camada; o registro é uma busca por nome protegida por um RWMutex, mantendo o núcleo livre de desvios por nome: quirks são dados, um campo de configuração, não caminhos de código.
Adicionar um quirk sem tocar o núcleo: criar internal/core/quirk/xxx.go com type Xxx struct{ OpenAI } embutindo a implementação base e sobrescrevendo só o que difere, registrá-lo em func init() { Register(Xxx{}) } —nomes duplicados causam panic— e depois definir "driver": "xxx" no backend do backends.json. É um campo de configuração, não uma variável de ambiente; um nome errado apenas degrada para comportamento genérico e não pode impedir a inicialização. O README dá três formas reais: um provedor que retorna mensagens de inadimplência só em chinês (a costura dois reivindica essas frases e põe seus 403 na lista negra); um provedor cujo corpo de erro de modelo removido usa um termo inventado (a costura dois o reivindica em fail_streak para que falhas consecutivas disparem o disjuntor); e um provedor cuja chave de acerto de cache é prompt_cache_hit_tokens em vez de cached_tokens (a costura três a analisa para que a cobrança por tokens de cache não caia a zero). A distribuição padrão não inclui quirks concretos; a interface fica reservada antecipadamente.
O contrato de consumo de captures
Os captures são instantâneos retidos, um caminho lateral vinculado a attempts por rid. O README diz que os consumidores devem julgar um capture com exatamente quatro critérios, um contrato extraído à força de dados de tráfego real:
- usable=false é o sinal positivo de entrega incompleta: entregue por completo é usable (1), enquanto respostas cortadas no meio, truncadas ou não entregues são usable (0). partial_ratio, truncated e status não são sinais positivos de incompletude.
- partial_ratio só responde se existe conteúdo: 0 significa nenhum, acima de 0 significa algum. partial_ratio=1.0 é a forma normal de uma entrega completa, não uma entrega totalmente parcial, e graduar a severidade por partial_ratio é um erro porque não há linha de base P50 nem haverá.
- truncated=true marca truncamento, não falha: o truncamento pode ocorrer dentro de uma entrega completa quando o corpo excede o limite do tee, e a inutilizabilidade continua regida pelo usable da regra 1.
- Várias linhas que compartilham rid são ordenadas por ts, e a última linha com usable=true é a entrega final: novas tentativas e parciais produzem legitimamente várias linhas por rid, o que não são dados duplicados.
A regra mnemônica: disponibilidade pelo usable, presença de conteúdo pelo partial_ratio, truncamento pelo truncated, desduplicação pela ordenação da regra 4. status só é referência quando existe um código HTTP com sentido —um parcial cortado no meio ainda mostra 200—, então status não deve ser usado como critério de conclusão.
Instâncias de desenvolvimento e serviços vizinhos
A unidade de produção slr-router.service é dona das portas 18006 (LAN) e 18012 (pública) mais o diretório shadow-data/; qualquer ./slr lançado à mão as rouba e manda a instância do systemd para um loop de quedas. Testes locais devem usar portas e diretórios de dados separados:
LISTEN=:28006 LISTEN_PUBLIC=:28012 \
GATEWAY_DATA_DIR=/tmp/slr-dev/data \
GATEWAY_CONFIG_DIR=/tmp/slr-dev/config \
GATEWAY_DB_FILE=/tmp/slr-dev/data/slr-dev.db \
ROUTER_VALIDATE=0 \
./slr
Credenciais falsas como sk-xxxxx bastam; as reais podem ser copiadas de shadow-config/backends.json, e uma instância de desenvolvimento nunca deve apontar para diretórios de produção.
O link WorkBuddy Panel do dashboard é um projeto separado fora deste repositório: WorkBuddy2API Panel empacota contas Tencent CodeBuddy em um gateway multiconta compatível com OpenAI com um painel web de operações cobrindo pools de contas, disjuntor, sessões aderentes e keep-alive. Seu repositório é github.com/linguo2625469/workbuddy2api-panel, um fork do branch aprimorado de Sliverkiss/workbuddy2api. UI e API compartilham uma porta, com o processo wb2api ligado a *:7863: o painel está em http://:7863/panel/ e a fonte de API em http://127.0.0.1:7863/v1, para onde apontam todos os backends com account=workbuddy. A navegação do dashboard aponta por padrão para o :7863/panel/ do mesmo host; se o painel vive em outra máquina, é preciso executar localStorage.setItem("wbPanelUrl","http://:7863/panel/") uma vez no console do navegador, já que o endereço real nunca é armazenado. Uma UI de painel antiga escutava em :18011 e desde então foi fundida em 7863; qualquer documento que ainda cite 18011 está desatualizado. wb-panel e wb2api não são reiniciados junto com este gateway, e atualizações de um lado não implicam o outro.
Resolução de problemas
- O gateway não inicia e informa que não há configuração de backends: o ambiente aponta para o diretório errado — GATEWAY_CONFIG_DIR deve conter backends.json — e no Docker a montagem runtime/config/ pode estar vazia (docker logs shg mostra quantos backends a seção de inicialização analisou).
- Um backend nunca é escolhido: inspecionar enabled (desativado na configuração), cooldown_remain_s (resfriamento de cota, exponencial até quatro horas) e circuit_open em /api/stats; circuit_open:false não significa que não há resfriamento, pois os dois contadores são independentes.
- Todos os backends estão resfriando e todas as requisições falham —exatamente a forma que a regra 1 existe para prevenir—: verificar fail_breakdown; uma massa de falhas de classe network sugere uma versão antiga classificando mal tempestades de desconexão, enquanto uma rajada concentrada de 401 significa chaves mortas que o resfriamento não resolverá até serem substituídas.
- Para requisições em bruto, consultar a tabela captures do SQLite após ler o contrato de consumo; as entradas são depuradas antes de serem armazenadas, com segredos, caminhos de intranet, números de telefone e cabeçalhos Bearer substituídos por [mask], o que o README classifica como recurso e não defeito.
- Um contêiner reiniciando em loop: docker logs shg revela a causa da saída, normalmente arquivos ausentes em runtime/config/ ou JSON inválido; falhas repetidas do healthcheck marcam o contêiner como unhealthy, mas restart: unless-stopped só reage à saída do processo.
Desenvolvimento e estrutura
A estrutura do repositório coloca cmd/shg/ como único ponto de entrada (montagem mais desligamento elegante); internal/ se divide em api/, service/ (routing, proxy, affinity, auth com providers/, apikey), core/ (errclass, quirk, upstream, store), config/ e runtime/; web/dashboard e web/console (o painel de operações e o centro de usuários) são embutidos via go:embed; py/sidecar.py é o daemon de cotas em biblioteca padrão pura; scripts/quota_probe.py coleta as janelas de cota; config/ só contém modelos *.example.json; deploy/ tem o Dockerfile e o docker-compose.yml; API_CONTRACT.md documenta o contrato de api.seika.ltd; e o Makefile expõe os alvos build, test, fmt, vet e docker.
A linha de base de desenvolvimento local exige que gofmt -l internal/ cmd/ web/ retorne vazio, go vet ./... limpo e go test ./... -race -count=1 verde sobre uma base de 12 pacotes antes de make build. Desenvolver sem tocar upstreams reais usa credenciais falsas como sk-xxxxx: as requisições falham em erros de rede ou 401, o que exercita convenientemente a classificação de erros, o resfriamento exponencial e a remoção de reserva em ordem, enquanto os testes unitários fixam roteamento, disjuntor e estatísticas de forma dirigida por tabelas. Uma execução de ponta a ponta sem tráfego de saída injeta uma configuração de upstream loopback via ROUTER_BACKENDS junto com ROUTER_VALIDATE=0.
Segurança, responsabilidade e contribuições
ShanHaiGateway é uma ferramenta auto-hospedada, e como é implantada e credenciada é decisão inteiramente do operador. O repositório e a imagem são distribuídos com zero segredos, então as credenciais reais só existem nos volumes montados ou diretórios locais do operador e nunca no histórico do git. Os captures são depurados por uma tabela de regras ordenada antes de persistir, mas a retenção é inerentemente sensível e a custódia do arquivo de banco de dados recai sobre o operador. Na porta pública o README aconselha ativar o portão de login e a cobrança por chave downstream; a porta LAN sem cobrança pertence apenas a segmentos de rede confiáveis, e adicionar HTTPS ou limites de IP depende da superfície de implantação. O projeto é oferecido como está, com o autor declinando responsabilidade por consequências diretas ou indiretas do uso, má configuração, falta de endurecimento, vazamento de credenciais de upstream ou perda de dados.
Issues e pull requests são bem-vindos, embora o README peça aos contribuidores que leiam a tabela de semântica operacional antes de tocar a semântica de roteamento ou os parâmetros de resfriamento, já que cada regra foi paga por um incidente real. O projeto tem licença MIT. Os agradecimentos vão para modernc.org/sqlite pelo SQLite em Go puro que mantém a imagem livre de CGO, rs/cors pelo middleware CORS e o ecossistema workbuddy2api descrito acima.