Qué es
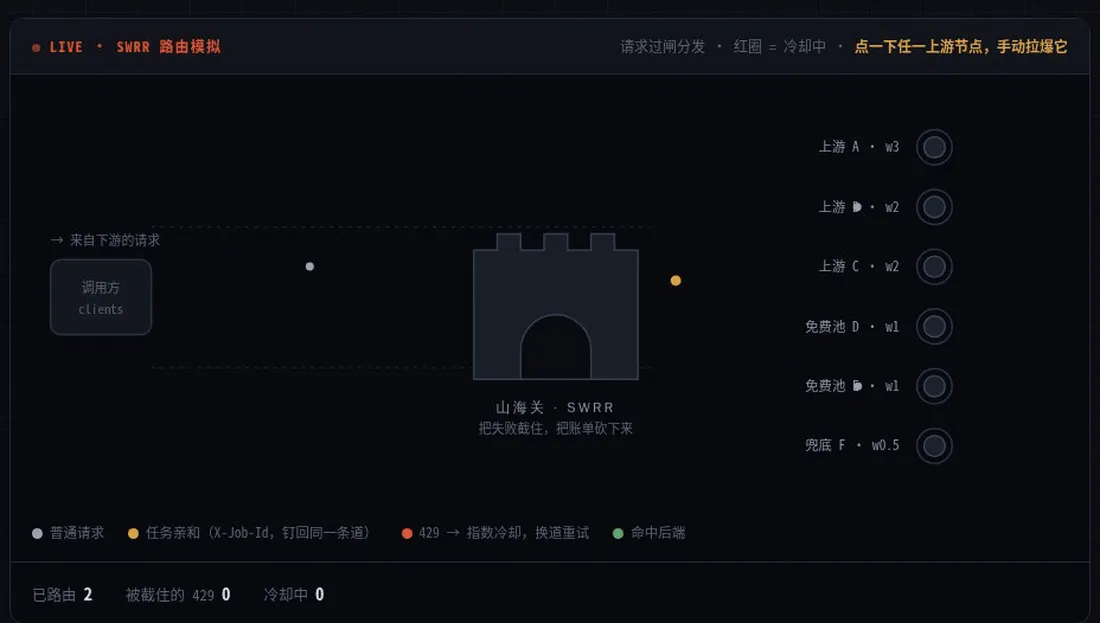
ShanHaiGateway es un gateway autoalojado escrito en Go que consolida varios proveedores de modelos upstream detrás de un único endpoint compatible con OpenAI. El proyecto está en github.com/ffseika0304/shanhai-gateway con su sitio en seika.ltd, se distribuye bajo licencia MIT y su endpoint de salud reporta la versión 0.5.1. Sus mecanismos principales son el round robin ponderado suave (SWRR), el enfriamiento exponencial para errores de cuota, la afinidad de sesión a nivel de tarea, la observabilidad por retención en sombra y un despliegue con Docker que el README describe como tres comandos hasta producción.
Por qué lo construyó el autor
El autor describe la motivación sin rodeos: cuando proveedores extranjeros abren niveles gratuitos de modelos, algunos usuarios registran lotes de cuentas, agotan la cuota e incluso revenden el acceso hasta que el proveedor retira la oferta. El autor afirma seguir un patrón de aprovechamiento similar, con dos diferencias: enseña el método abiertamente y no consume todo gratis, pues gasta algo más de ¥100 al mes en mantener la infraestructura. Se mezclan canales comerciales, cupones y pools gratuitos, se paga lo que corresponde y la capacidad gratuita absorbe el resto. En una prueba de producción de octubre de 2026, el autor reporta haber reducido un volumen mensual de 20 000 millones de tokens a una factura en efectivo de unos ¥170.
El README presenta cada regla operativa como el residuo de un incidente real, un tropiezo canjeado por una regla, todas reunidas en una tabla de semántica operativa en lugar de salir de la teoría.
Problemas que aborda
El gateway ataca modos de fallo que el autor encontró al rotar entre tres proveedores upstream:
- Un upstream inestable derriba todo el producto con errores 503. Reintentar a secas es demasiado tosco; los fallos deben derivarse por clase de error, con retroceso exponencial para los de cuota, cola para los backends saturados y solo observación, sin castigo, para los de red.
- La tasa de aciertos de la caché de prefijos nunca sube. La rotación simple manda el segundo turno de una conversación a otro proveedor, pero la caché de prefijos vive del lado del proveedor, así que cambiar de proveedor la anula. El autor midió una tasa de aciertos de 51 a 56 por ciento para grupos de mismo prefijo bajo rotación suelta, exactamente la probabilidad de muestreo del pool, lo que el README llama el techo del round robin.
- Un upstream retiró un modelo sin avisar y un backend de reserva giró en vacío con 0% de éxito durante cuatro días y medio antes de que alguien lo notara. Un 4xx no es necesariamente culpa del cliente; alguien tiene que reclamar esa clase de fallo en nombre del backend.
- Una tormenta de desconexiones produjo 1720 veces 503: las desconexiones de clientes se registraron como fallos de backend, los backends sanos entraron en enfriamiento uno tras otro y al final no quedó ninguno disponible.
- Las claves acaban desperdigadas por todas partes y el repositorio no puede mostrarse en público jamás.
Conjunto de características
- Round robin ponderado SWRR con aislamiento de la cadena de reserva: peso, concurrencia y tiempo de espera ajustables por backend, y los backends de reserva aislados del pool principal para no contaminarse mutuamente.
- Enfriamiento guiado por una taxonomía de errores: las respuestas 403 y 429 retroceden exponencialmente, 5 minutos, luego 10, duplicando hasta un tope de 4 horas; un backend saturado encola las solicitudes hasta 60 segundos en lugar de lanzar un 503; las desconexiones de cliente no generan enfriamiento.
- Afinidad de sesión a nivel de tarea: el gateway prefiere la cabecera X-Job-Id y recurre a X-Session-Key como respaldo, fijando cada turno de una tarea al mismo backend para que la caché de prefijos del proveedor se convierta en la unidad de reutilización. El autor reporta que la tasa medida subió de 27% a 51%, con un pico de 69%.
- Una capa de quirks para comportamientos específicos de cada proveedor: cuerpos de error, claves de uso y ajustes de salida propios de un proveedor viven en un paquete dedicado (core/quirk); el núcleo no contiene ninguna rama por nombre de proveedor y los upstreams sin quirks no requieren configuración.
- Facturación de claves downstream multiusuario: emisión de cuotas sk-user-*, inicio de sesión conectable bajo un patrón de registro y un centro de usuarios incluido.
- Observabilidad por retención en sombra: una única base SQLite registra attempts y captures, depurados automáticamente antes de escribirse, con un panel detallado en /api/stats.
- Recarga en caliente de la configuración: backends.json se recarga por cambios de mtime, de modo que pesos y backends pueden modificarse sin reiniciar.
- Un sidecar de autocuración de ciclo lento: un proceso Python independiente, sin dependencias de terceros, toma decisiones de limitación y degradación a partir de tasas de fallo incrementales por ventana, repartiendo el trabajo con la ruta rápida del gateway.
- Sonda de ventanas de cuota con retirada automática: scripts/quota_probe.py consulta las ventanas de cuota de 5h/7d/30d de cada proveedor agrupadas por nombre de backend y escribe una instantánea en quota.json cada 180 segundos; el sidecar evalúa cada 60 segundos, retira un backend cuya ventana se agota y lo reincorpora cuando vuelve a caer por debajo del umbral. Cada suscripción se mide de forma independiente, así que añadir una suscripción no toca ninguna tabla de mapeo.
- Despliegue Docker: compilación multietapa, SQLite en Go puro sin CGO, ejecución sin root, healthcheck y cero secretos dentro de la imagen.
La afirmación sobre costes
Según el README, alguien ejecuta el gateway en producción con 20 000 millones de tokens al mes por un coste en efectivo de unos ¥170 mensuales; el mismo volumen facturado al precio de catálogo de cada proveedor ascendería a unos $3,800 al mes, aproximadamente ¥26,600.
Los pools gratuitos soportaron cerca del 63% del tráfico. El autor describe como una de las capacidades centrales del gateway el mezclar cuotas gratuitas y regaladas, muy inestables, en un pool principal de alta disponibilidad: no distingue upstreams principales de auxiliares y despacha de forma totalmente aleatoria. El resultado reportado es que los canales de pago puramente comerciales (Volcano Pro/Plan y similares) solo cargaron con un 37% de las solicitudes reales, mientras que los pools de modelos gratuitos incluidos con suscripciones baratas, los pools de proxy y las lecturas de caché absorbieron cerca del 63% del rendimiento.
Los 429 y bloqueos de los pools gratuitos quedan aislados por el cortacircuitos, un tiempo de espera bidireccional de 600 segundos y la clasificación de fallos; pese a los errores frecuentes de los pools gratuitos, el negocio principal siguió viendo cero 429 de upstream. La resiliencia viene de que ambos extremos agotan el tiempo a los 600 segundos: corte el lado que corte, la solicitud se reenvía por otro carril. Si el upstream corta, ese carril entra en enfriamiento y el reintento del llamante cae en otro; si el gateway agota el tiempo primero, cambia de carril internamente y el llamante apenas lo nota.
Cada suscripción adicional aporta otro pool gratuito, ya que toda suscripción Go trae su propio pool de modelos gratuitos, de modo que la fracción de pago sigue bajando (el autor la midió caer de 43,6% a cerca de 37% tras añadir una suscripción más) mientras el rendimiento total crece. La factura depende de qué canal es barato, no de cuántos tokens se consumen; los proveedores son entradas de enrutamiento intercambiables en la configuración, no supuestos de arquitectura.
El desglose de factura del autor, con una carga de producción de 1 000 millones de tokens diarios, combina reparto por enrutamiento, afinidad de caché (70% de aciertos) y rotación continua de cupones multicuenta más pools gratuitos para un gasto mensual en efectivo de unos ¥170:
| Canal | Cantidad | Capacidad mensual de tokens | Efectivo mensual |
|---|---|---|---|
| Suscripciones Volcano | 4 | 4 por 2 000 millones igual a 8 000 millones | Dos pagadas en efectivo por ¥99,8; las otras dos cubiertas por dos cupones de canal de ¥50 (sobran ¥10) |
| opencode Go | 2 | 2 por 600 millones de tokens de pago igual a 1 200 millones | Compradas de segunda mano a mitad de precio, $5 cada una (unos ¥70) |
| Pools gratuitos de regalo, créditos ganados, lecturas de caché | — | Soportaron el ~63% restante | ¥0 |
Esto equivale a unos ¥0,85 por cada 100 millones de tokens, y solo el 23% del volumen se facturó como tokens nuevos a precio pleno; el mismo volumen a precio de catálogo costaría unos $3,800 al mes. El autor afirma que el código por sí solo (afinidad de caché más mezcla de niveles gratuitos), junto con el reparto por tamaño de solicitud en la capa de configuración del pool, comprime la fracción pagada a precio de catálogo a entre un cuarto y un tercio, y que la estrategia de canales eleva la reducción total de coste al 99%.
Cómo lo consigue
- Afinidad de sesión interna: cada turno de una tarea (X-Job-Id, con respaldo en X-Session-Key) se fija de nuevo al mismo carril. Bajo rotación suelta la tasa medida de aciertos para grupos de mismo prefijo fue de 51 a 56 por ciento, igual a la probabilidad de muestreo del pool; tras la fijación, el autor midió una subida de 27% a 51% con un pico de 69%.
- Passthrough de cabecera de sesión externa: una opción session_header por backend (por ejemplo x-opencode-session) escribe el valor de sesión en la cabecera propia del proveedor. Las cachés de algunos proveedores solo reconocen su propia cabecera; el README dice que activar el campo es un cambio de una línea en attempt.go, sin modificar código.
- Capa de quirks: los cuerpos de error, claves de uso y ajustes de salida propios de cada proveedor van a internal/core/quirk mientras el núcleo mantiene cero ramas por nombre. Un upstream sin quirks no necesita configuración, y el comportamiento sin la capa de quirks es idéntico bit a bit al de un upstream genérico.
- Medición independiente por suscripción con retirada automática por ventana de cuota: la sonda consulta las ventanas de 5h/7d/30d agrupadas por nombre de backend y escribe una instantánea quota.json cada 180 segundos; el sidecar juzga cada 60 segundos. Rotar una suscripción que vence es cuestión de desactivar una y activar otra, escalonadas para que cada una se consuma por completo sin derrumbar la concurrencia.
- Reparto por tamaño de solicitud, hecho en la capa de configuración del pool y no en el núcleo: las solicitudes pequeñas van a pools facturados por token y las grandes a pools facturados por petición, con un punto de equilibrio medido en 22 222 tokens; el autor reporta un ahorro del 35%.
- Mezcla de canales gratuitos y de bajo coste: los pools gratuitos rotan en el mismo pool que los canales comerciales; la inestabilidad es aceptable precisamente porque el colapso de un pool gratuito no afecta al negocio principal.
Añadir una suscripción requiere dos pasos y lo demás es automático. Primero, se añade una entrada en accounts[] con un nombre único, api_keys[] para las llamadas y credenciales de consulta de cuota (AK/SK entregadas con la configuración de despliegue; si faltan, el panel informa de credenciales ausentes y no actúa, sin pedir jamás prestadas las de otra cuenta). Segundo, se añade un backend en backends[] cuyo base_url apunte al endpoint del plan de ese proveedor y cuyo account referencie la primera entrada. El cambio se carga en caliente en unos 30 segundos, la sonda empieza a consultar sus ventanas de cuota por nombre de backend y el sidecar pasa a gestionar la retirada y reincorporación.
Las salvedades del propio autor
El README insiste en que sus cifras se lean junto con cinco matizaciones:
- Los precios promocionales tienen fecha de caducidad: los cupones y las ofertas a mitad de precio pueden desaparecer en cualquier momento; volver a precios normales costaría unos ¥340 al mes, aún una reducción de más del 98%.
- La cifra de «gratuito y de bajo coste soporta el 63%» fluctúa con la generosidad del upstream y las tasas de obtención; el rango medido fue de 37% a 57%, mayor si se cuentan las lecturas de caché, y no se promete ninguna fracción concreta.
- Las cuotas gratuitas y regaladas las conceden los proveedores upstream, no este proyecto. Lo que el proyecto deja en abierto de forma permanente es la afinidad de caché, el reintento con cambio de carril y la medición independiente por suscripción con retirada automática.
- Las cifras son mediciones de producción en una sola máquina de 2026-10 (consumo diario de 441,3 millones de tokens), con la misma base de cálculo que la tabla de factura; el método de medición está documentado en registros de calibración publicados con la versión.
- Ningún proveedor queda atado: la fracción del pool principal osciló entre 11% y 43% en tres días, cambiando solo cuentas y pesos en la configuración, mientras el enrutamiento, la afinidad de caché y la lógica de reserva quedaban intactos.
Inicio rápido
Docker es la vía recomendada. El contenedor escucha por defecto en el puerto :18016 del host, sobreescribible con SHG_PORT:
git clone https://github.com/ffseika0304/shanhai-gateway.git && cd shanhai-gateway
mkdir -p runtime/config runtime/data
cp config/backends.example.json runtime/config/backends.json   # edita tus backends
cp config/keys.example.json    runtime/config/keys.json        # edita tus claves downstream
docker compose -f deploy/docker-compose.yml up -d --build
curl -s http://127.0.0.1:18016/health          # {"status":"ok","version":"0.5.1"}
curl -s http://127.0.0.1:18016/api/stats | head -c 400
Ejecutar el binario directamente requiere Go 1.27 o superior:
make build                          # equivalente a go build -o shg ./cmd/shg
cp config/backends.example.json config/backends.json   # las credenciales falsas sirven para la primera ejecución
export LISTEN=":18006"              # puerto LAN sin facturación
export ROUTER_VALIDATE=0            # omite el autochequeo de arranque (quítalo con claves reales)
./shg &
curl -s http://127.0.0.1:18006/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"demo-model","messages":[{"role":"user","content":"hi"}]}'
Una respuesta 200 significa que el camino está abierto; GET /health es el chequeo de salud y GET /api/stats el panel de tráfico. El puerto LAN no exige clave para POST /v1/chat/completions; la facturación por clave downstream solo se activa en el puerto público y el centro de usuarios. Ambas formas de despliegue comparten la misma semántica de rutas: la ejecución directa lee archivos reales (ignorados por git) desde /config/ y guarda datos en ~/.local/share/shg/, mientras Docker monta ./runtime/config/ en /etc/shg y ./runtime/data/ en /var/lib/shg. Ambas se identifican como shg/0.5.1 en el user agent, /healthz y los prefijos de log, y ambas recargan la configuración por mtime.
Arquitectura
Las dependencias apuntan en un solo sentido, de api a service y a core, mientras config y runtime actúan como capas de alimentación horizontales que no dependen ni entre sí ni de service. cmd/shg solo ensambla: entorno, rutas, directorios, SQLite y dos listeners.
- internal/api — las puertas HTTP del plano de control: la puerta LAN sin facturación y la puerta pública (puerta de panel más clave), además de centro de usuarios, admin, dashboard y puertas públicas. Quién puede entrar no tiene relación con cómo se enruta una solicitud; cambiar entradas o frontends solo toca este paquete.
- internal/service — negocio del plano de datos y del de control: routing (rotación ponderada, filtrado de candidatos, aislamiento de reserva, intercambio atómico), proxy (reescritura de solicitudes, streaming, tiempo de espera en cola, detección de desconexión), auth (proveedores de inicio de sesión conectables) y apikey (facturación de claves downstream). Un algoritmo de enrutamiento puede sustituirse por P2C o least-connections sin que core ni el formato de configuración lo sigan; un nuevo método de inicio de sesión es solo un nuevo archivo de proveedor.
- internal/core — errclass es la única fuente de verdad para la clasificación de errores de upstream más el vocabulario global, y una sola definición debe servir a la vez a enfriamiento, cortacircuitos, estadísticas y reserva; quirk; upstream guarda la máquina de estados de capacidad y salud del backend (huecos de concurrencia, cortacircuitos, enfriamiento exponencial, contadores de fallo por clase) cuyos números mágicos fueron ajustados cada uno por un incidente de producción; store es la única base SQLite con un único punto de escritura, de modo que la evolución del esquema y la lógica de negocio no se arrastran mutuamente.
- internal/config — qué cuenta como backend legal, la canalización de carga, validación y recarga por mtime, y la lista negra del autochequeo.
- internal/runtime — la identidad del programa y sus ubicaciones en disco: rutas, env, rotación de logs, limpieza y mantenimiento de SQLite.
cmd/shg está pensado para permanecer delgado para siempre: la lógica de negocio baja de capa y allí solo vive el orden de arranque y apagado.
Un backends.json mínimo tiene este aspecto (todas las credenciales falsas; el conjunto completo de campos está en config/backends.example.json):
{
  "accounts": [
    { "name": "vendor-a", "base_url": "https://api.example-llm.com/v1",
      "api_keys": ["sk-xxxxx"] }
  ],
  "backends": [
    {
      "name": "vendor-a-main",
      "account": "vendor-a",
      "model": "demo-model",
      "base_url": "https://api.example-llm.com/v1",
      "weight": 1,
      "concurrency": 8,
      "enabled": true,
      "is_primary": true
    }
  ]
}
Variables de entorno: GATEWAY_DATA_DIR fija la raíz de datos (por defecto ~/.local/share/shg), GATEWAY_CONFIG_DIR el directorio de configuración (por defecto /config), GATEWAY_DB_FILE el archivo SQLite principal (/shg.db), GATEWAY_BACKENDS_FILE el archivo base de backends (/backends.json), GATEWAY_KEYS_FILE el libro mayor de claves downstream (/keys.json) y GATEWAY_QUOTA_FILE la instantánea de cuotas (/quota.json). ROUTER_BACKENDS inyecta configuración JSON directamente con prioridad sobre los archivos; ROUTER_VALIDATE vale 1 por defecto y omite el autochequeo de arranque en 0; LISTEN y LISTEN_PUBLIC valen por defecto :18006 y sin escucha; SESSION_AFFINITY está activa por defecto y desactivarla deja el comportamiento idéntico bit a bit al de un gateway sin afinidad — AFFINITY_TTL, AFFINITY_MAX y AFFINITY_CONTENTION_LIMIT controlan la vida de las entradas, la capacidad LRU y el umbral de migración por saturación (6h, 8192 y 3). REASONING_EFFORT vale low por defecto: cuando el cliente no fijó explícitamente reasoning_effort, el gateway inyecta un valor por defecto para limitar los presupuestos de razonamiento de los modelos pensantes, respeta un valor explícito del cliente y una cadena vacía desactiva la inyección; un guarda detecta un valor ya inyectado por un gateway anterior para que los despliegues en cadena nunca inyecten dos veces.
El prefijo es GATEWAY_* y no SHG_* porque el contrato del sidecar (py/sidecar.py lee GATEWAY_BACKENDS_FILE y GATEWAY_QUOTA_FILE) está anclado a esos nombres; la identidad de la aplicación vive en internal/runtime/identity.go como AppName "shg". backends.blocked.json no tiene variable propia: comparte el directorio de backends.json y debe moverse con él.
Secretos e higiene de datos
No se distribuye ningún secreto en el repositorio ni en la imagen: los archivos reales backends.json, keys.json, backends.blocked.json y quota.env están todos en gitignore y solo existen en las ubicaciones de ejecución, mientras el repositorio solo contiene plantillas .example.json. Los datos (.db, logs) nunca se confirman, porque los captures contienen texto de solicitudes en bruto y cuentan como datos en producción, no como configuración; la recuperación ante desastres significa por tanto código más el directorio de configuración en ejecución. Cualquier clave real que aparezca en el repositorio se trata como un bug y se redacta al instante.
Semántica operativa: reglas destiladas de incidentes
El README mantiene una tabla de reglas donde cada entrada cita el incidente que la produjo; SLR se refiere al enrutador frontal anterior del proyecto, seika_llm_router, sustituido por completo por este gateway, cuyas entradas se conservan como historia semántica.
- Las desconexiones de cliente nunca desencadenan enfriamiento. Una tormenta de desconexiones el 03.10.2026 produjo 1720 veces 503: las desconexiones se registraron como fallos de backend, los backends sanos se enfriaron uno a uno y todo el pool se secó. Las desconexiones se clasifican como eventos de red solo para observación, exentas de enfriamiento y de cortacircuitos.
- Un modelo inexistente es culpa del backend. Cuando un upstream retiró un modelo sin avisar, el gateway mostró comportamiento de 4xx y agujero negro; desde el 06.10.2026 un backend de reserva giró en vacío con 0% de éxito durante cuatro días y medio antes de ser descubierto. Ese 4xx no puede cargarse al cliente; recae sobre el backend responsable para enfriamiento o retirada de reserva, con la identidad parchada mediante model_expire y model_fallback.
- Los errores de cuota retroceden exponencialmente; la saturación encola. Las respuestas 403 y 429 se enfrían 5 minutos, luego 10, duplicando hasta un tope de 4 horas en lugar de chocar repetidamente; un backend lleno encola hasta 60 segundos (QUEUE_WAIT) en lugar de responder 503.
- La lista negra solo se escribe y se limpia a mano. backends.blocked.json es la lista del autochequeo de arranque de upstreams permanentemente muertos; no hay vía de desbloqueo automático, porque el borrado automático usaría la tasa de fallos como evidencia mientras la lista negra descansa en hechos de sondeo, así que las entradas requieren revisión humana y borrado del archivo.
- Los strikes solo se ponen a cero con el éxito. La tormenta de autobloqueo 403 del 01.10.2026: poner el strike a cero antes de que la cuota se recuperara dejó volver el backend al pool, fallar otro 403 al instante y reentrar en enfriamiento en bucle. Toda la cadena de retroceso exponencial depende de que los strikes consecutivos solo se anulen con el éxito, así que el endpoint de edición en caliente de admin deliberadamente no ofrece campo de strike.
- La afinidad de sesión es una capa de preferencia sobre la rotación. El 10.10.2026 la producción midió 0% de aciertos de caché de prefijos porque SWRR dispersaba los turnos de una conversación entre proveedores cuyas cachés viven del lado del proveedor. Las sesiones establecidas se fijan al mismo backend; las nuevas siguen cayendo por peso SWRR. La tabla de afinidad solo se escribe tras una entrega final exitosa para que las sesiones fallidas no queden fijadas a backends malos, y el desalojo y la retención comparten fuente con el enfriamiento y el cortacircuitos (errclass.ReleaseAffinity) en lugar de una segunda capa de salud. Las claves de afinidad prefieren X-Job-Id, a nivel de tarea, con todos los turnos de una tarea compartiendo un id —exactamente la unidad de reutilización de la caché de prefijos— y recurren a X-Session-Key.
- Los quirks de cada proveedor van a la capa de quirks; el núcleo nunca ramifica por nombre. Tropiezos anteriores se generalizaron en reglas universales —borrado incondicional de Content-Length, modificar solo la clave model, el campo session_header y un vocabulario genérico—, pero un tropiezo no generalizable no debe ni integrarse en las reglas compartidas donde dañaría a otros proveedores ni manejarse como comprobaciones de nombre desperdigadas por el núcleo. La tercera vía es internal/core/quirk/xxx.go consultada en tres costuras fijas.
- El contrato de observabilidad refleja a SLR. La tabla attempts lleva una columna job_id, migrada de forma idempotente vía ALTER en bases existentes, para que los scripts de atribución por job y de análisis de caché sigan funcionando sin cambios; /api/stats expone un objeto affinity{hits,misses,puts,pinned_jobs} con forma de SLR donde pinned_jobs toma la longitud bruta de la tabla (Len debe preceder a CountPerBackend, que de paso limpia entradas TTL), y las tres claves sticky_* se conservan como nombres históricos que el panel aún lee. puts cuenta cada Put real incluidas las actualizaciones del mismo backend, idéntico bit a bit a SLR.
- Las instancias solo las levanta el gestor de servicios, nunca a mano. El 21.10.2026 otro agente lanzó ./slr manualmente y desacoplado (PPID=1), ocupando los puertos 18006 y 18012; la instancia de systemd no pudo hacer bind y entró en bucle de caídas, dejando el panel inestable todo el día. Tres reglas acompañantes: esperar al puerto antes de arrancar y reportar el PID que lo ocupa; el apagado elegante puede retener el puerto hasta 600 segundos (el timeout de un backend), así que la unidad necesita TimeoutStopSec=45 más Restart=always; los cambios de frontend son go:embed, así que hay que recompilar el binario y parar el servicio antes, porque un ejecutable en ejecución no puede sobrescribirse. Tras el despliegue hay que verificar el estado estable —ActiveState, NRestarts sin crecer, el PID dueño del puerto perteneciendo al servicio— porque un curl justo tras el reinicio puede responderlo la instancia vieja.
La capa de quirks
El núcleo la invoca en exactamente tres costuras fijas del ciclo de vida de la solicitud:
- Decorate(req, backend) corre en la salida, tras la limpieza genérica de cabeceras (borrar Content-Length, credenciales de cliente y Accept-Encoding, fijar Content-Type y el user agent) y antes de enviar al upstream; puede añadir cabeceras o parámetros de consulta del proveedor y recortar el cuerpo condicionalmente. El comportamiento por defecto es no-op.
- Classify(status, body) (Class, bool) corre durante la clasificación; devolver (Class, false) significa que el caso no es reclamado y el llamante recurre al juicio genérico, dejando que un proveedor posea solo sus propias frases sin secuestrar el vocabulario compartido. El valor por defecto reclama 400 y 404 más el vocabulario genérico de modelo retirado, que sigue viviendo en errclass.
- ParseUsage(body) Usage corre durante el análisis de uso; OK=false recurre al valor de OpenAI. El valor por defecto analiza el usage de OpenAI más prompt_tokens_details.cached_tokens.
Un driver ausente o no registrado recae en el singleton OpenAI a nivel de paquete, idéntico bit a bit a no tener la capa; el registro es una búsqueda por nombre protegida por un RWMutex, manteniendo el núcleo libre de ramas por nombre: los quirks son datos, un campo de configuración, no caminos de código.
Añadir un quirk sin tocar el núcleo: crear internal/core/quirk/xxx.go con type Xxx struct{ OpenAI } embebiendo la implementación base y sobrescribiendo solo lo que difiere, registrarlo en func init() { Register(Xxx{}) } —los nombres duplicados provocan panic— y luego poner "driver": "xxx" en el backend de backends.json. Es un campo de configuración, no una variable de entorno; un nombre equivocado solo degrada a comportamiento genérico y no puede impedir el arranque. El README da tres formas reales: un proveedor que devuelve mensajes de impago solo en chino (la costura dos reclama esas frases y pone en lista negra sus 403); un proveedor cuyo cuerpo de error de modelo retirado usa un término inventado (la costura dos lo reclama en fail_streak para que fallos consecutivos disparen el cortacircuitos); y un proveedor cuya clave de acierto de caché es prompt_cache_hit_tokens en lugar de cached_tokens (la costura tres la analiza para que la facturación por tokens de caché no caiga a cero). La distribución por defecto no incluye quirks concretos; la interfaz queda reservada por adelantado.
El contrato de consumo de captures
Los captures son instantáneas retenidas, una vía lateral vinculada a attempts por rid. El README dice que los consumidores deben juzgar un capture con exactamente cuatro criterios, un contrato extraído a la fuerza de datos de tráfico real:
- usable=false es la señal positiva de entrega incompleta: entregado por completo es usable (1), mientras que respuestas cortadas a mitad, truncadas o no entregadas son usable (0). partial_ratio, truncated y status no son señales positivas de incompletitud.
- partial_ratio solo responde si existe contenido: 0 significa ninguno, más de 0 significa algo. partial_ratio=1.0 es la forma normal de una entrega completa, no una entrega totalmente parcial, y graduar la severidad por partial_ratio es un error porque no tiene línea base P50 ni la tendrá.
- truncated=true marca truncamiento, no fallo: el truncamiento puede ocurrir dentro de una entrega completa cuando el cuerpo supera el límite del tee, y la inusabilidad sigue rigiéndose por el usable de la regla 1.
- Varias filas que comparten rid se ordenan por ts, y la última fila con usable=true es la entrega final: los reintentos y los parciales producen legítimamente varias filas por rid, lo cual no son datos duplicados.
La regla mnemotécnica: disponibilidad desde usable, presencia de contenido desde partial_ratio, truncamiento desde truncated, deduplicación desde la ordenación de la regla 4. status solo es referencia cuando existe un código HTTP con sentido —un parcial cortado a mitad sigue mostrando 200—, así que status no debe usarse como criterio de finalización.
Instancias de desarrollo y servicios vecinos
La unidad de producción slr-router.service posee los puertos 18006 (LAN) y 18012 (público) más el directorio shadow-data/; cualquier ./slr lanzado a mano se los arrebata y manda la instancia de systemd a un bucle de caídas. Las pruebas locales deben usar puertos y directorios de datos separados:
LISTEN=:28006 LISTEN_PUBLIC=:28012 \
GATEWAY_DATA_DIR=/tmp/slr-dev/data \
GATEWAY_CONFIG_DIR=/tmp/slr-dev/config \
GATEWAY_DB_FILE=/tmp/slr-dev/data/slr-dev.db \
ROUTER_VALIDATE=0 \
./slr
Basta con credenciales falsas como sk-xxxxx; las reales pueden copiarse desde shadow-config/backends.json, y una instancia de desarrollo jamás debe apuntar a directorios de producción.
El enlace WorkBuddy Panel del dashboard es un proyecto separado fuera de este repositorio: WorkBuddy2API Panel envuelve cuentas de Tencent CodeBuddy en un gateway multicuenta compatible con OpenAI con un panel web de operaciones que cubre pools de cuentas, cortacircuitos, sesiones pegajosas y keep-alive. Su repositorio es github.com/linguo2625469/workbuddy2api-panel, un fork de la rama mejorada de Sliverkiss/workbuddy2api. UI y API comparten un puerto, con el proceso wb2api atado a *:7863: el panel está en http://:7863/panel/ y la fuente de API en http://127.0.0.1:7863/v1, adonde apuntan todos los backends con account=workbuddy. La navegación del dashboard apunta por defecto al :7863/panel/ del mismo host; si el panel vive en otra máquina, hay que ejecutar localStorage.setItem("wbPanelUrl","http://:7863/panel/") una vez en la consola del navegador, ya que la dirección real nunca se almacena. Una UI de panel antigua escuchaba en :18011 y desde entonces se fusionó en 7863; cualquier documento que aún cite 18011 está desactualizado. wb-panel y wb2api no se reinician junto con este gateway, y las actualizaciones de un lado no implican al otro.
Resolución de problemas
- El gateway no arranca e informa de que no hay configuración de backends: el entorno apunta al directorio equivocado — GATEWAY_CONFIG_DIR debe contener backends.json — y bajo Docker el montaje runtime/config/ puede estar vacío (docker logs shg muestra cuántos backends analizó la sección de arranque).
- Un backend nunca es elegido: inspeccionar enabled (desactivado en configuración), cooldown_remain_s (enfriamiento de cuota, exponencial hasta cuatro horas) y circuit_open en /api/stats; circuit_open:false no significa que no haya enfriamiento, pues los dos contadores son independientes.
- Todos los backends están enfriándose y todas las solicitudes fallan —exactamente la forma que la regla 1 existe para prevenir—: revisar fail_breakdown; una masa de fallos de clase network sugiere una versión antigua que clasifica mal las tormentas de desconexión, mientras que una ráfaga concentrada de 401 significa claves muertas que el enfriamiento no arreglará hasta reemplazarlas.
- Para solicitudes en bruto, consultar la tabla captures de SQLite tras leer el contrato de consumo; las entradas se depuran antes de almacenarse, con secretos, rutas de intranet, números de teléfono y cabeceras Bearer sustituidos por [mask], lo que el README califica de característica y no de defecto.
- Un contenedor que se reinicia en bucle: docker logs shg revela la causa de salida, normalmente archivos ausentes en runtime/config/ o JSON inválido; los fallos repetidos del healthcheck marcan el contenedor como unhealthy, pero restart: unless-stopped solo reacciona a la salida del proceso.
Desarrollo y estructura
La estructura del repositorio pone cmd/shg/ como único punto de entrada (ensamblaje más apagado elegante); internal/ se divide en api/, service/ (routing, proxy, affinity, auth con providers/, apikey), core/ (errclass, quirk, upstream, store), config/ y runtime/; web/dashboard y web/console (el panel de operaciones y el centro de usuarios) se embeben vía go:embed; py/sidecar.py es el demonio de cuotas en biblioteca estándar pura; scripts/quota_probe.py recolecta las ventanas de cuota; config/ solo contiene plantillas *.example.json; deploy/ tiene el Dockerfile y docker-compose.yml; API_CONTRACT.md documenta el contrato de api.seika.ltd; y el Makefile expone los objetivos build, test, fmt, vet y docker.
La línea base de desarrollo local exige que gofmt -l internal/ cmd/ web/ devuelva vacío, go vet ./... limpio y go test ./... -race -count=1 en verde sobre una base de 12 paquetes antes de make build. Desarrollar sin tocar upstreams reales usa credenciales falsas como sk-xxxxx: las solicitudes fallan en errores de red o 401, lo que ejercita convenientemente la clasificación de errores, el enfriamiento exponencial y la retirada de reserva en orden, mientras los tests unitarios fijan enrutamiento, cortacircuitos y estadísticas de forma dirigida por tablas. Una ejecución de extremo a extremo sin tráfico saliente inyecta una configuración de upstream loopback vía ROUTER_BACKENDS junto con ROUTER_VALIDATE=0.
Seguridad, responsabilidad y contribuciones
ShanHaiGateway es una herramienta autoalojada, y cómo se despliega y se acredita es decisión enteramente del operador. El repositorio y la imagen se distribuyen con cero secretos, así que las credenciales reales solo existen en los volúmenes montados o directorios locales del operador y nunca en el historial de git. Los captures se depuran con una tabla de reglas ordenada antes de persistir, pero la retención es inherentemente sensible y la custodia del archivo de base de datos recae en el operador. En el puerto público el README aconseja activar la puerta de inicio de sesión y la facturación por clave downstream; el puerto LAN sin facturación pertenece solo a segmentos de red confiables, y añadir HTTPS o límites de IP depende de la superficie de despliegue. El proyecto se ofrece tal cual, con el autor declinando responsabilidad por consecuencias directas o indirectas del uso, mala configuración, falta de endurecimiento, filtración de credenciales de upstream o pérdida de datos.
Las incidencias y pull requests son bienvenidos, aunque el README pide a los contribuidores leer la tabla de semántica operativa antes de tocar la semántica de enrutamiento o los parámetros de enfriamiento, ya que cada regla fue pagada por un incidente real. El proyecto tiene licencia MIT. Los agradecimientos van a modernc.org/sqlite por el SQLite en Go puro que mantiene la imagen libre de CGO, rs/cors por el middleware CORS y el ecosistema workbuddy2api descrito arriba.