A primeira parte desta série apresentou o modelo operacional que mantém sob controle os gastos no Amazon Bedrock: atribuição por meio de tags de entidade principal do AWS Identity and Access Management (IAM) e do Cost and Usage Report 2.0, observabilidade por meio do registro de invocações de modelos, aplicação de políticas em três níveis e uma cadência de revisão regular. Essa camada identifica quem gerou o gasto e permite interrompê-lo, mas não diz se o dinheiro foi bem empregado.
Esta segunda parte responde às duas perguntas que a primeira deixou abertas de propósito. A primeira: por que este fluxo de trabalho é tão caro? Responder exige pensar em custo por tarefa, e não em custo por token. A segunda: o agente é realmente melhor do que as pessoas eram? Para isso são necessárias baselines, experimentos controlados e um scorecard vinculado a decisões.
O framework descrito a seguir mostra como calcular o custo real de um modelo, incluindo quatro fatores de custo ocultos que não aparecem na página de preços; como reduzir o custo por tarefa com cache, roteamento e restrições de saída; e como medir o ROI de um agente usando baselines humanas, experimentos com grupo de holdout e um scorecard de cinco dimensões. O conteúdo é voltado a dois públicos: os engenheiros de aplicações e de plataforma que controlam as alavancas de otimização, e os product owners e parceiros de FinOps que precisam justificar o gasto com agentes perante a liderança.
Custo por tarefa, não custo por token
O preço por token facilita comparações rápidas, mas não reflete o que realmente se paga. A tarifa publicada corresponde ao custo de um único token; a fatura reflete o custo de concluir uma tarefa. Uma tarefa é uma unidade completa de trabalho que a aplicação pede a um modelo — resolver um e-mail de suporte, extrair os campos de uma nota fiscal ou responder a uma pergunta de um usuário — e vai da requisição até um resultado utilizável, não importa quantas chamadas ao modelo forem necessárias.
O modelo com menor preço de tabela não é necessariamente o mais barato de executar. Um modelo nominalmente mais barato pode fragmentar o texto em mais tokens, preencher as respostas com palavras supérfluas, interpretar mal o esquema de ferramentas e entrar em loops de correção, ou consumir milhares de tokens de raciocínio antes de responder. Nada disso aparece na página de preços do Bedrock.
Os quatro fatores de custo ocultos
Quatro características do modelo determinam o que a tarifa publicada realmente custa em cada carga de trabalho.
Eficiência do tokenizador
Um token não é uma palavra, e tokens não são equivalentes entre modelos. Cada família de modelos usa um tokenizador e um vocabulário diferentes, de modo que o mesmo texto, código ou payload JSON se divide em contagens diferentes de tokens. Se o preço de tabela do Modelo A for 15 por cento menor, mas seu tokenizador precisar de 40 por cento mais tokens para os seus dados — algo comum com esquemas estruturados e arrays numéricos —, o Modelo B sai mais barato. A diferença aumenta para textos em idiomas que não o inglês: muitos tokenizadores fragmentam escritas não latinas em duas a três vezes mais tokens do que o inglês equivalente.
Alinhamento de saída e verbosidade
Os tokens de saída costumam custar de três a cinco vezes mais que os de entrada, embora a proporção varie conforme a família (consulte a página de preços do Bedrock). Um modelo que ignora restrições de formato como "return only raw JSON" faz você pagar esse prêmio de saída por palavras de preenchimento. Um modelo que segue com precisão as instruções de formato gera menos desses tokens de saída mais caros e, portanto, economiza dinheiro.
Eficiência do loop agêntico
Os fluxos de trabalho agênticos mudam completamente a matemática de custos. O uso de ferramentas (function calling) permite ao modelo invocar funções externas em um loop de vários turnos: analisar o prompt, decidir chamar uma ferramenta, aguardar a observação e gerar a resposta. Cada turno reenvia todo o histórico da conversa e os resultados das ferramentas como tokens de entrada. Um modelo que precisa de quatro turnos, cada um reenviando um payload de contexto maior, custa muito mais do que um que conclui em uma única passada.
Sobrecusto do raciocínio
Muitos modelos oferecem pensamento estendido, elaborando uma cadeia de pensamento antes da resposta visível. Os tokens de raciocínio são cobrados como tokens de saída, então um modelo que pensa por 2.000 tokens antes de uma resposta de 200 tokens cobra 2.200. Alguns modelos ocultam o raciocínio, mas continuam cobrando por ele. O recomendado é começar com o raciocínio desativado e ativá-lo apenas quando benchmarks mostrarem uma diferença de qualidade que justifique o custo.
Um exemplo resolvido
Considere um fluxo de trabalho agêntico que lê um e-mail de cliente de 750 palavras, extrai entidades, chama uma API para verificar o status da conta e devolve JSON estrito. A comparação a seguir usa preços ilustrativos: faça sempre o benchmark com seus próprios dados e os preços vigentes do Bedrock.
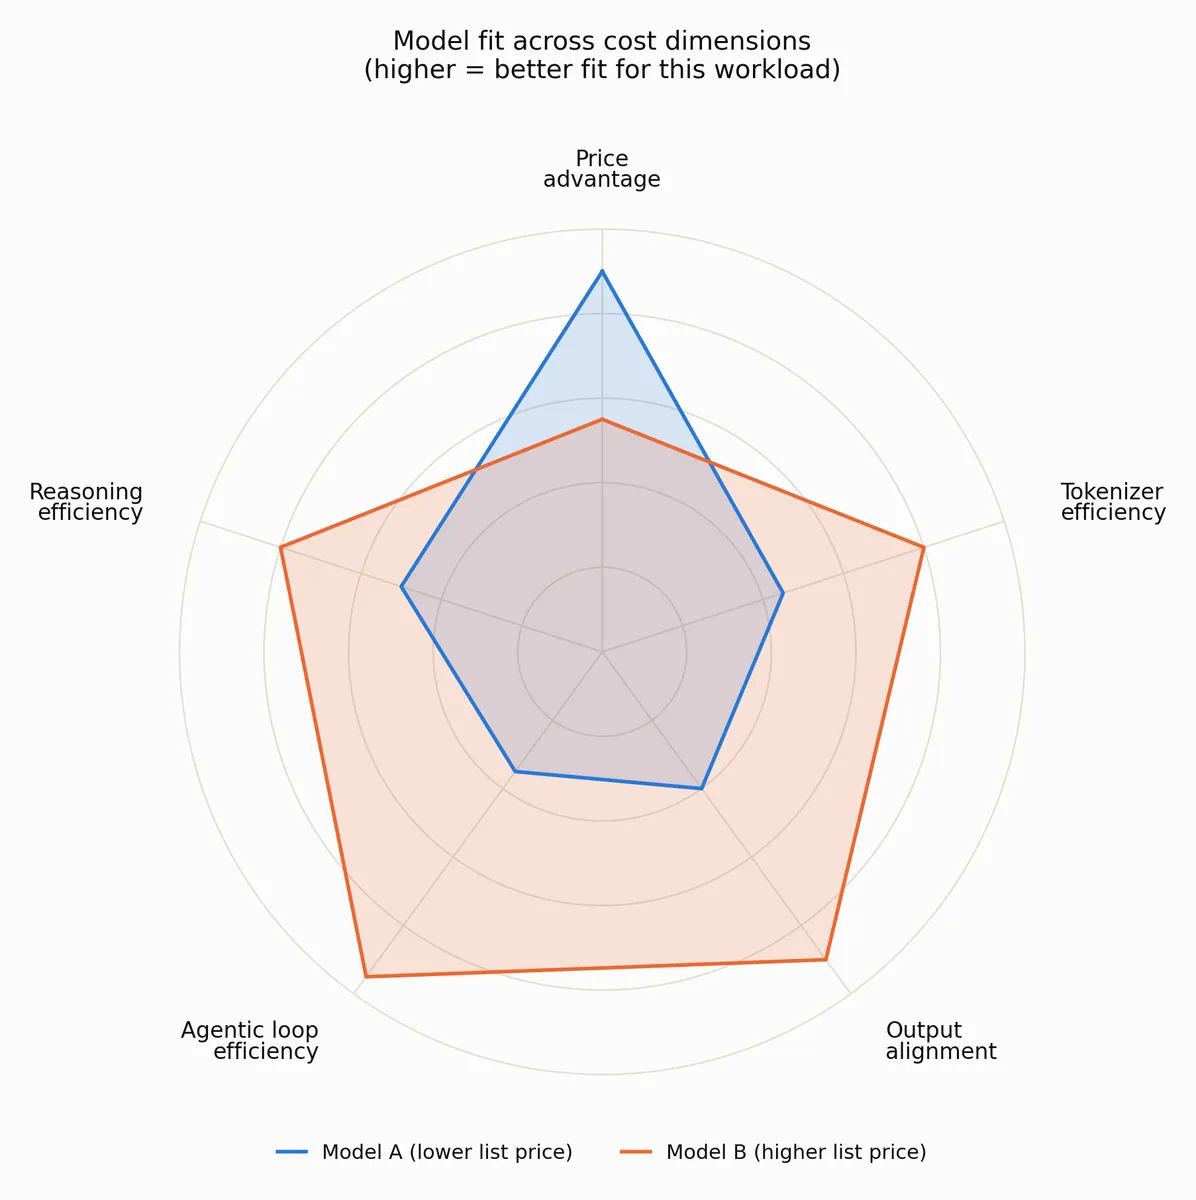
| Métrica | Modelo A (menor preço de tabela) | Modelo B (maior preço de tabela) |
|---|---|---|
| Preço de tabela de entrada | $0.50 / 1M tokens | $1.00 / 1M tokens |
| Preço de tabela de saída | $1.50 / 1M tokens | $3.00 / 1M tokens |
| Eficiência do tokenizador (entrada do turno 1) | 1,500 tokens | 1,000 tokens |
| Verbosidade de saída (resposta final) | 450 tokens | 150 tokens |
| Loops agênticos necessários | 3 turnos (correção de erros) | 1 turno (zero-shot) |
| Tokens de entrada acumulados, todos os turnos | 6,150 | 1,000 |
| Tokens de saída acumulados, todos os turnos | 750 | 150 |
| Custo total por tarefa | $0.0042 | $0.00145 |
Modelo A: (6,150 x $0.50 + 750 x $1.50) / 1,000,000 = $0.0042
Modelo B: (1,000 x $1.00 + 150 x $3.00) / 1,000,000 = $0.00145
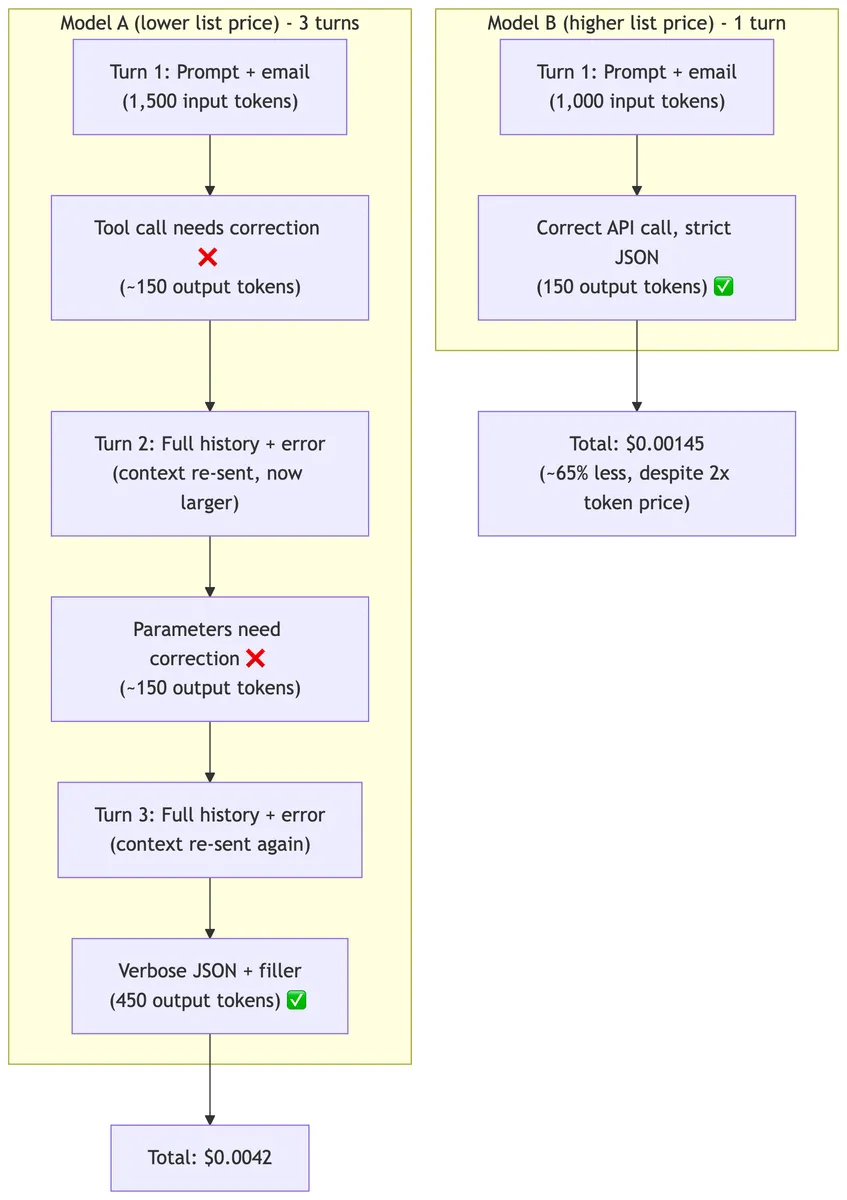
O modelo com o dobro do preço acaba custando 65 por cento menos por causa de três efeitos que se acumulam: o tokenizador do Modelo A fragmenta o e-mail em 50 por cento mais tokens, inflando cada payload de entrada; ele adiciona preenchimento ao JSON, triplicando os tokens de saída; e se desalinha do esquema de ferramentas, exigindo dois turnos de correção em que um histórico cada vez maior é reenviado.
Custo por tarefa bem-sucedida
O exemplo anterior pressupõe que ambos os modelos acabam tendo sucesso. Em produção isso não acontece, e uma falha raramente é gratuita. Para fluxos de trabalho que tentam novamente até obter sucesso:
custo por tarefa bem-sucedida = custo por tentativa / taxa de sucesso
Para fluxos que escalam quando falham:
custo por tarefa bem-sucedida = custo por tentativa + (1 - taxa de sucesso) x custo de escalonamento
Com o cache de prompts ativado, a entrada se divide ainda em três categorias: entrada não cacheada à tarifa base, leituras de cache abaixo da tarifa base e escritas de cache acima dela.
Como medir na própria carga de trabalho
Qual modelo é realmente mais barato só aparece quando se faz o benchmark com os próprios dados. A avaliação de modelos do Amazon Bedrock é o recurso gerenciado que cobre a metade de qualidade desse trabalho: você define critérios, envia conjuntos de dados de prompts e recebe resultados pontuados com métricas automáticas e revisão humana opcional, sem infraestrutura própria.
No entanto, as pontuações de qualidade sozinhas não geram uma fatura. Outros três recursos do Bedrock fornecem as contagens de tokens e turnos com as quais calcular o preço:
- O CountTokens retorna o número de tokens de entrada que um modelo cobraria por um determinado payload sem executar inferência. É a forma mais barata de comparar a eficiência do tokenizador (o primeiro fator) entre candidatos antes de gastar qualquer coisa com geração.
- A resposta de invocação do modelo traz um bloco usage com inputTokens, outputTokens, cacheReadInputTokens e cacheWriteInputTokens. Acumulá-los ao longo dos turnos de uma mesma tarefa fornece os quatro termos da fórmula de custo por tentativa acima. Uma ressalva: quando o cache está ativado, inputTokens conta apenas os tokens não cacheados, de modo que o volume total de entrada é inputTokens + cacheReadInputTokens + cacheWriteInputTokens. Some os três para conhecer a pegada, mas precifique-os separadamente, pois cada um é cobrado a uma taxa diferente. Essa avaliação deve ser repetida ao longo do ciclo de vida e os checkpoints de cache devem acompanhar a carga ativa do momento: conforme a aplicação evolui e as ferramentas ficam desatualizadas, os checkpoints derivam, o que significa mais escritas de cache daqui a três meses. Avaliar continuamente o uso ideal do cache torna-se uma alavanca primária de redução de custos.
- O registro de invocações de modelos grava as contagens de tokens por invocação no Amazon Simple Storage Service (Amazon S3) ou no Amazon CloudWatch Logs, permitindo medir os turnos até a conclusão com tráfego real de produção, e não uma amostra. Marcar as chamadas com metadados de requisição permite segmentar essas contagens por equipe, recurso ou experimento. Trata-se, porém, de campos de log, não de tags de alocação de custos, e eles nunca aparecem no AWS Cost Explorer nem no Cost and Usage Report. Os perfis de inferência de aplicações chegam aos dois, mas com granularidade de um tipo de uso por dia: adequada para chargeback, grosseira demais para o custo por tarefa. Multiplicar as contagens de tokens registradas pelas tarifas publicadas produz uma estimativa quase em tempo real, não uma fatura; ela não reflete compromissos, preços de lote nem throughput provisionado, a menos que você os modele. Reconcilie-a com o Cost and Usage Report antes de tratá-la como a fatura.
Reduzir o custo por tarefa: quatro alavancas
Cada fator tem sua alavanca correspondente, e todas estão documentadas em profundidade. O cache de prompts elimina o contexto reenviado que tornava o Modelo A caro, sendo a maior vitória nos caminhos agênticos. O roteamento inteligente de prompts envia as requisições fáceis a um modelo mais barato da mesma família. Um esquema de ferramentas combinado com um limite de maxTokens contém a verbosidade de forma mais confiável do que instruções em prosa, e o pensamento estendido permanece desligado até que um benchmark mostre que ele recupera o próprio custo. A inferência em lote reduz a tarifa pela metade em trabalho massivo de turno único, embora exclua chamadas de ferramentas e trocas multiturno.
Comprovar o ROI do agente: descrever a baseline humana
Eficiente não é o mesmo que valioso. Um agente pode estar perfeitamente otimizado e ainda assim não valer a pena. A pergunta que decide os orçamentos é se o agente é melhor do que as pessoas eram.
Documentar primeiro o processo humano
O maior erro no ROI de agentes é tentar comprovar valor sem antes descrever o fluxo de trabalho humano. Antes de construir ou escalar um agente, registre o processo atual em termos operacionais: o que dispara o trabalho, quais papéis humanos participam, onde ficam as transferências e como a conclusão é definida. Pode parecer burocracia; na verdade é desenho de medição, pois todas as decisões de instrumentação posteriores — o que conta como execução, o que conta como sucesso, onde o tempo humano é gasto — derivam dessa descrição.
Medir a baseline antes de o agente entrar no ar
Com o processo descrito, meça a baseline humana durante uma janela significativa: tempo até a conclusão, tempo de fila, esforço ativo, taxa de reabertura, taxa de escalonamento, custo por tarefa e qualidade do resultado. As baselines devem ser medidas antes de o agente entrar em produção, não reconstruídas de memória depois. Baselines retrospectivas favorecem sistematicamente o agente: as pessoas lembram do caso médio e esquecem os rápidos.
Instrumentar o fluxo de trabalho como um experimento
Com a baseline estabelecida, o fluxo do agente é instrumentado como um experimento desde o primeiro dia. Cada execução recebe um ID de rastreamento e cada etapa relevante é observável. Um registro de execução de fluxo agrega tudo o que está acima da chamada ao modelo em uma única unidade analisável:
{
  "runId": "run-8f3a2c",
  "workflow": "renewal-risk-summary",
  "agent": "renewal-agent",
  "principalArn": "arn:aws:sts::123456789012:assumed-role/BedrockRuntimeRole/gw-alex",
  "team": "sales-ai",
  "costCenter": "CC-2041",
  "experiment": {
    "variant": "treatment",
    "holdout": False,
    "promptVersion": "v14",
    "policyVersion": "2026-07"
  },
  "ops": {
    "latencyMs": 41200,
    "retries": 1,
    "toolCalls": 6,
    "humanApprovals": 1,
    "humanMinutes": 35,
    "escalations": 0
  },
  "econ": {
    "inputTokens": 48210,
    "outputTokens": 3105,
    "cacheReadTokens": 31500,
    "estCostUsd": 0.87
  },
  "outcome": {
    "status": "success",
    "accepted": True,
    "reopened": False,
    "revenueEventId": "opp-44121"
  }
}
Três campos merecem destaque:
- Bloco experiment: carimbado na criação da execução e propagado para os metadados de requisição do Bedrock, de modo que os registros em nível de modelo e de fluxo se unem de forma limpa.
- humanMinutes: o que a maioria das equipes omite e mais precisa. Sem ele, "o agente fez o trabalho" exclui silenciosamente os 35 minutos que uma pessoa passou revisando.
- revenueEventId: o gancho que torna possível a atribuição de receita mais adiante. Registrá-lo não custa nada e não pode ser reconstruído depois.
A regra: se a telemetria do fluxo não consegue responder à pergunta de negócio, a instrumentação está incompleta.
Unir custos e resultados
Com os logs de invocação chegando ao Amazon S3 (conforme a Parte 1) e os registros de execução no seu armazenamento analítico, uma única junção produz as métricas que importam. Como os logs do Bedrock registram tokens e não dólares, primeiro construa uma visão que precifique cada invocação a partir das contagens de tokens e da sua tabela de tarifas, agregada por ID de execução, e depois consulte-a com o Amazon Athena:
SELECT
  w.workflow,
  w.variant,
  COUNT(*) AS runs,
  SUM(IF(w.outcome_status = 'success', 1, 0)) AS successes,
  ROUND(SUM(c.est_cost_usd) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS cost_per_success,
  ROUND(SUM(w.retries) * 1.0 /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS retries_per_success,
  ROUND(SUM(w.human_minutes) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 1)
    AS human_min_per_success
FROM workflow_runs w
JOIN invocation_costs_by_run c ON c.run_id = w.run_id
GROUP BY w.workflow, w.variant
ORDER BY cost_per_success DESC
Os nomes de colunas e chaves de junção da consulta são ilustrativos; verifique-os com o esquema real dos seus logs de invocação e do seu repositório de telemetria, que podem variar conforme a implementação.
Custo por resultado bem-sucedido, tentativas por sucesso e minutos humanos por sucesso são os três números que resistem ao contato com um CFO cético. O custo por chamada favorece agentes que ficam em loop; o custo por sucesso, não. Note o agrupamento por variante: a mesma consulta dividida por braço de experimento é a comparação de ROI.
Comparar agentes e pessoas corretamente
A avaliação mais confiável é um teste A/B ou com grupo de holdout. Grupos de tratamento e controle comparam o fluxo assistido por agente com a baseline humana sem confundir o resultado com mudanças de mercado, sazonais ou organizacionais.
Para fluxos voltados ao cliente ou ligados a receita, a randomização deve ser feita no nível de visitante, lead, conta ou caso. Para fluxos internos, como operações de suporte ou assistentes de código, usam-se coortes pareadas: equipes, grupos de repositórios ou pods.
A comparação cobre quatro dimensões:
- Eficiência: tempo até a conclusão, horas recuperadas, redução do tempo de fila.
- Qualidade: taxa de erros, taxa de aprovação, taxa de reabertura, taxa de escalonamento.
- Custo: custo por tarefa, custo por resultado bem-sucedido, custo total de atendimento.
- Valor de negócio: aumento de conversão, aumento de retenção, taxa de expansão, receita por representante ou por fluxo de trabalho.
Se o agente melhora uma dimensão enquanto degrada significativamente outra, o resultado é ambíguo e a implantação precisa de ajustes.
Receita: a métrica mais difícil
Os ganhos de eficiência são a parte mais fácil de comprovar da história de ROI. O impacto em receita é mais difícil, e é a métrica sobre a qual a liderança decide o financiamento. Em fluxos próximos à receita, meça se o agente melhora a conversão, o tempo de resposta, a progressão de negócios ou a receita por representante. Testes de holdout são a forma mais confiável de separar a receita incremental atribuível ao agente do momentum geral do negócio.
Quando o aumento de receita é real, a conversa muda: a organização deixa de perguntar se a fatura do Bedrock subiu e passa a perguntar se o gasto adicional compra um aumento significativo da produção do negócio.
O scorecard
Com base no que os autores observaram trabalhando com clientes, um modelo operacional sólido não exige cinquenta métricas. O que funciona é um scorecard pequeno vinculado a decisões, revisado em uma cadência regular para cada agente em produção. Os limites a seguir são pontos de partida, não prescrições: calibre-os com os dados da sua própria frota e o contexto organizacional.
| Dimensão | Métrica | Verde | Amarelo | Vermelho |
|---|---|---|---|---|
| Adoção | Usuários ativos / usuários previstos | >70% | 40-70% | <40% |
| Qualidade | Tarefas concluídas sem retrabalho | >90% | 75-90% | <75% |
| Eficiência | Horas recuperadas por semana | >meta | 50-100% da meta | <50% da meta |
| Custo | Custo por resultado bem-sucedido | ≤orçamento | 1-1.5x orçamento | >1.5x orçamento |
| Impacto no negócio | Melhora do KPI frente à baseline | Significativa | Marginal | Nula ou negativa |
Verde significa escalar: o agente supera a baseline cumprindo os limites de custo e qualidade. Amarelo significa ajustar: promissor, mas precisa de trabalho. Vermelho significa aposentar ou reprojetar: o agente consome custo sem valor mensurável suficiente, e a disposição para realmente aposentar um agente no vermelho é o que dá credibilidade ao restante do scorecard.
Conclusão
Calcular o custo real de um modelo exige levar em conta os quatro fatores ocultos: eficiência do tokenizador, alinhamento de saída, eficiência do loop agêntico e sobrecusto do raciocínio. Reduzir o custo por tarefa passa pelo cache de prompts, pelo roteamento de modelos, pelas restrições de saída e pela inferência em lote. Comprovar o ROI passa por medir baselines humanas, instrumentar fluxos como experimentos, unir custos a resultados e executar comparações com holdout.
A metade de otimização de custos responde por que é caro e como consertar; a metade de ROI responde se o agente é melhor do que as pessoas eram. Junto com o modelo operacional da Parte 1 — atribuir, observar, aplicar, otimizar, operar — formam um framework completo: é possível ver quem gastou, explicar por quê, reduzir o desperdício e justificar o que resta.
Para começar, faça benchmark dos principais modelos candidatos com seus próprios prompts usando a avaliação de modelos do Amazon Bedrock, capture tokens e turnos do bloco usage ou dos seus logs de invocação, precifique-os conforme os preços vigentes do Bedrock e divida pela taxa de sucesso. Para a medição de ROI, consulte o Well-Architected Agentic AI Lens e suas práticas recomendadas de governança de custos de agentes. Os autores também convidam os leitores a compartilhar nos comentários outras técnicas para reduzir o custo por tarefa ou medir o ROI de agentes no Amazon Bedrock.