La primera parte de esta serie presentó el modelo operativo que mantiene bajo control el gasto en Amazon Bedrock: la atribución mediante etiquetas de entidad principal de AWS Identity and Access Management (IAM) y Cost and Usage Report 2.0, la observabilidad mediante el registro de invocaciones de modelos, la aplicación de políticas en tres niveles y una cadencia de revisión periódica. Esa capa permite saber quién generó el gasto y detenerlo, pero no puede indicar si el dinero se invirtió bien.
Esta segunda entrega responde a las dos preguntas que la primera dejó abiertas de forma deliberada. La primera: ¿por qué este flujo de trabajo resulta tan caro? Responder exige razonar en términos de coste por tarea, no de coste por token. La segunda: ¿es el agente realmente mejor que las personas? Para eso hacen falta líneas de base, experimentos controlados y un cuadro de mando vinculado a decisiones.
El marco que se describe a continuación muestra cómo calcular el coste real de un modelo, incluidos cuatro factores de coste ocultos que no aparecen en la página de precios; cómo reducir el coste por tarea mediante almacenamiento en caché, enrutado y restricciones de salida; y cómo medir el ROI de un agente con líneas de base humanas, experimentos con grupo de reserva y un cuadro de mando de cinco dimensiones. Está dirigido a dos públicos: los ingenieros de aplicaciones y de plataforma que controlan las palancas de optimización, y los responsables de producto y socios de FinOps que deben justificar el gasto en agentes ante la dirección.
Coste por tarea, no coste por token
El precio por token facilita comparaciones rápidas, pero no refleja lo que realmente se paga. La tarifa publicada corresponde al coste de un solo token; la factura refleja el coste de completar una tarea. Una tarea es una unidad completa de trabajo que la aplicación solicita a un modelo —resolver un correo de soporte, extraer los campos de una factura o responder a una pregunta de un usuario— y abarca desde la petición hasta un resultado utilizable, independientemente de cuántas llamadas al modelo requiera.
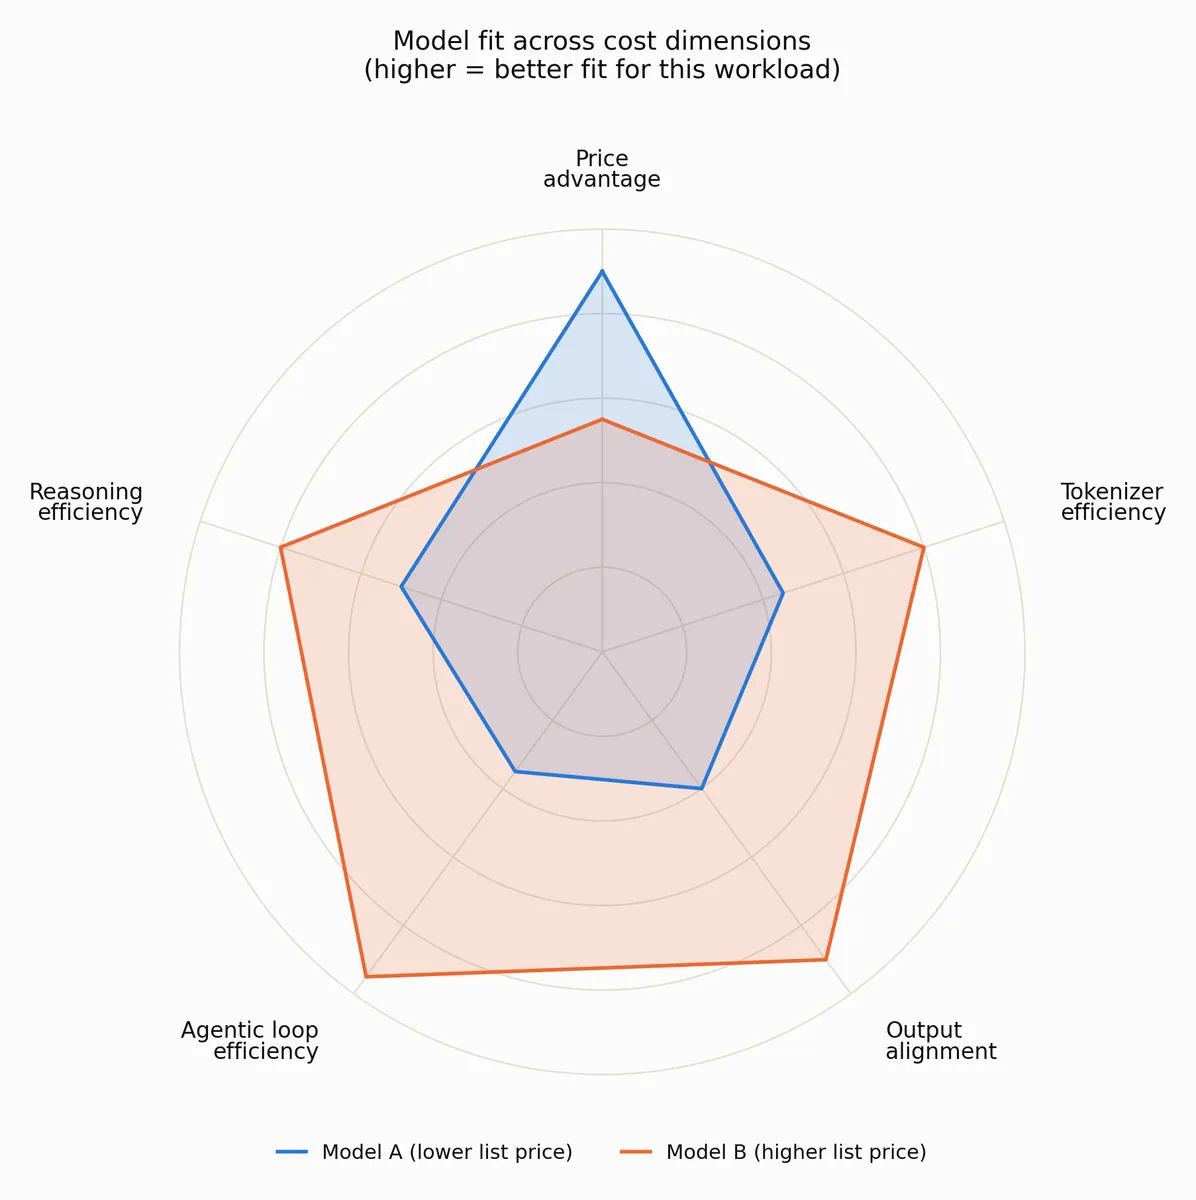
El modelo con menor precio de lista no es necesariamente el más barato de ejecutar. Un modelo nominalmente más barato puede fragmentar el texto en más tokens, rellenar las respuestas con palabras superfluas, interpretar mal el esquema de herramientas y entrar en bucles de corrección, o consumir miles de tokens de razonamiento antes de responder. Nada de esto aparece en la página de precios de Bedrock.
Los cuatro factores de coste ocultos
Cuatro características del modelo determinan lo que la tarifa publicada cuesta en realidad en cada carga de trabajo.
Eficiencia del tokenizador
Un token no es una palabra, ni los tokens son equivalentes entre modelos. Cada familia de modelos utiliza un tokenizador y un vocabulario distintos, de modo que el mismo texto, código o carga JSON se divide en un número diferente de tokens. Si el precio de lista del Modelo A es un 15 por ciento inferior, pero su tokenizador necesita un 40 por ciento más de tokens para sus datos —algo frecuente con esquemas estructurados y matrices numéricas—, el Modelo B resulta más barato. La diferencia se amplía con texto en idiomas distintos del inglés: muchos tokenizadores fragmentan las escrituras no latinas en dos o tres veces más tokens que el inglés equivalente.
Alineación de salida y verbosidad
Los tokens de salida suelen costar entre tres y cinco veces más que los de entrada, aunque la proporción varía según la familia (consúltese la página de precios de Bedrock). Un modelo que ignora restricciones de formato como "return only raw JSON" hace pagar esa prima de salida por palabras de relleno. Un modelo que sigue con precisión las instrucciones de formato genera menos de estos costosos tokens de salida y, por tanto, ahorra dinero.
Eficiencia del bucle agéntico
Los flujos de trabajo agénticos cambian por completo las cuentas. El uso de herramientas (function calling) permite al modelo invocar funciones externas en un bucle de varios turnos: analizar el prompt, decidir llamar a una herramienta, esperar la observación y generar la respuesta. Cada turno reenvía el historial completo de la conversación y los resultados de las herramientas como tokens de entrada. Un modelo que necesita cuatro turnos, cada uno reenviando un contexto cada vez mayor, cuesta mucho más que uno que termina en una sola pasada.
Sobrecoste del razonamiento
Muchos modelos admiten el pensamiento extendido, elaborando una cadena de pensamiento antes de la respuesta visible. Los tokens de razonamiento se facturan como tokens de salida, así que un modelo que piensa durante 2.000 tokens antes de una respuesta de 200 tokens cobra 2.200. Algunos modelos ocultan el razonamiento pero siguen cobrándolo. Conviene empezar con el razonamiento desactivado y activarlo solo cuando las pruebas comparativas muestren una diferencia de calidad que justifique el coste.
Un ejemplo resuelto
Considérese un flujo de trabajo agéntico que lee un correo de cliente de 750 palabras, extrae entidades, llama a una API para verificar el estado de la cuenta y devuelve JSON estricto. La comparación siguiente utiliza precios ilustrativos: hay que hacer las pruebas siempre con los datos propios y los precios vigentes de Bedrock.
| Métrica | Modelo A (menor precio de lista) | Modelo B (mayor precio de lista) |
|---|---|---|
| Precio de lista de entrada | $0.50 / 1M tokens | $1.00 / 1M tokens |
| Precio de lista de salida | $1.50 / 1M tokens | $3.00 / 1M tokens |
| Eficiencia del tokenizador (entrada del turno 1) | 1,500 tokens | 1,000 tokens |
| Verbosidad de salida (respuesta final) | 450 tokens | 150 tokens |
| Bucles agénticos necesarios | 3 turnos (corrección de errores) | 1 turno (zero-shot) |
| Tokens de entrada acumulados, todos los turnos | 6,150 | 1,000 |
| Tokens de salida acumulados, todos los turnos | 750 | 150 |
| Coste total por tarea | $0.0042 | $0.00145 |
Modelo A: (6,150 x $0.50 + 750 x $1.50) / 1,000,000 = $0.0042
Modelo B: (1,000 x $1.00 + 150 x $3.00) / 1,000,000 = $0.00145
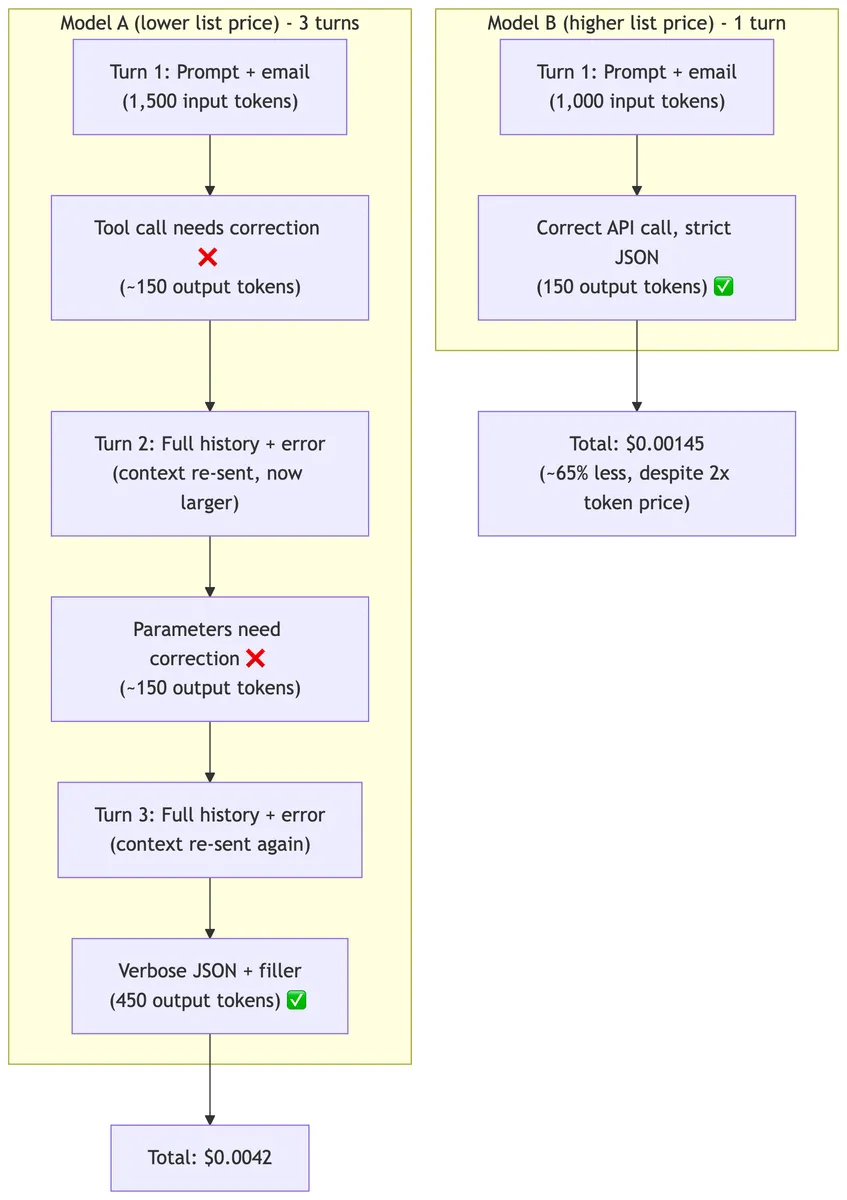
El modelo con el doble de precio resulta un 65 por ciento más barato por tres efectos que se acumulan: el tokenizador del Modelo A fragmenta el correo en un 50 por ciento más de tokens, lo que infla cada carga de entrada; añade relleno al JSON, triplicando los tokens de salida; y se desalinea con el esquema de herramientas, lo que exige dos turnos de corrección en los que se reenvía un historial cada vez mayor.
Coste por tarea exitosa
El ejemplo anterior supone que ambos modelos acaban teniendo éxito. En producción no será así, y un fallo rara vez es gratis. Para flujos de trabajo que reintentan hasta lograr el éxito:
coste por tarea exitosa = coste por intento / tasa de éxito
Para flujos que escalan cuando fallan:
coste por tarea exitosa = coste por intento + (1 - tasa de éxito) x coste de escalado
Con la caché de prompts activada, la entrada se divide además en tres categorías: entrada no almacenada en caché a la tarifa base, lecturas de caché por debajo de la tarifa base y escrituras de caché por encima de ella.
Cómo medirlo en la propia carga de trabajo
Qué modelo es realmente más barato solo se descubre al comparar con los datos propios. La evaluación de modelos de Amazon Bedrock es la función gestionada que cubre la mitad de calidad de ese trabajo: se definen criterios, se cargan conjuntos de datos de prompts y se obtienen resultados puntuados con métricas automáticas y revisión humana opcional, sin infraestructura propia.
Sin embargo, las puntuaciones de calidad por sí solas no generan una factura. Otras tres funciones de Bedrock aportan los recuentos de tokens y turnos con los que calcular el precio:
- CountTokens devuelve el número de tokens de entrada que un modelo cobraría por una carga determinada sin ejecutar inferencia. Es la forma más barata de comparar la eficiencia del tokenizador (el primer factor) entre candidatos antes de gastar nada en generación.
- La respuesta de invocación del modelo incluye un bloque usage con inputTokens, outputTokens, cacheReadInputTokens y cacheWriteInputTokens. Acumularlos a lo largo de los turnos de una misma tarea proporciona los cuatro términos de la fórmula de coste por intento anterior. Una advertencia: cuando la caché está activada, inputTokens solo cuenta los tokens no almacenados en caché, de modo que el volumen total de entrada es inputTokens + cacheReadInputTokens + cacheWriteInputTokens. Conviene sumarlos para conocer la huella, pero tarificarlos por separado, porque las tres categorías se facturan a precios distintos. Esta evaluación debe repetirse a lo largo del ciclo de vida y los puntos de control de caché deben ajustarse a la carga activa del momento: a medida que la aplicación evoluciona y las herramientas quedan desactualizadas, los puntos de control se desvían, por lo que dentro de tres meses se escribirá más en la caché. Evaluar continuamente el uso óptimo de la caché se convierte en una palanca principal de reducción de costes.
- El registro de invocaciones de modelos escribe los recuentos de tokens por invocación en Amazon Simple Storage Service (Amazon S3) o Amazon CloudWatch Logs, lo que permite medir los turnos hasta completar la tarea con tráfico real de producción en lugar de una muestra. Etiquetar las llamadas con metadatos de solicitud permite segmentar esos recuentos por equipo, función o experimento. No obstante, son campos de registro, no etiquetas de asignación de costes, y nunca aparecen en AWS Cost Explorer ni en el Cost and Usage Report. Los perfiles de inferencia de aplicaciones sí llegan a ambos, pero con una granularidad de un tipo de uso por día: adecuada para el chargeback, demasiado gruesa para el coste por tarea. Multiplicar los recuentos de tokens registrados por las tarifas publicadas produce una estimación casi en tiempo real, no una factura; no refleja compromisos, precios de lote ni throughput aprovisionado salvo que se modelen. Hay que reconciliarla con el Cost and Usage Report antes de tratarla como la factura.
Reducir el coste por tarea: cuatro palancas
Cada factor tiene su palanca, y todas están documentadas en profundidad. La caché de prompts elimina el contexto reenviado que encarecía al Modelo A, lo que la convierte en la mayor ganancia en las rutas agénticas. El enrutado inteligente de prompts envía las solicitudes fáciles a un modelo más barato de la misma familia. Un esquema de herramientas combinado con un límite de maxTokens controla la verbosidad de forma más fiable que las instrucciones en prosa, y el pensamiento extendido permanece desactivado hasta que una comparativa demuestre que recupera su coste. La inferencia por lotes reduce la tarifa a la mitad en trabajo masivo de un solo turno, aunque excluye las llamadas a herramientas y el intercambio multiturno.
Demostrar el ROI del agente: describir la línea de base humana
Eficiente no equivale a valioso. Un agente puede estar perfectamente optimizado y aun así no merecer la pena. La pregunta que decide los presupuestos es si el agente es mejor que las personas anteriores.
Documentar primero el proceso humano
El mayor error en el ROI de agentes es intentar demostrar valor sin describir antes el flujo de trabajo humano. Antes de construir o escalar un agente hay que anotar el proceso actual en términos operativos: qué desencadena el trabajo, qué roles humanos intervienen, dónde se producen los traspasos y cómo se define la finalización. Puede sonar a burocracia; en realidad es diseño de mediciones, porque todas las decisiones de instrumentación posteriores —qué cuenta como ejecución, qué cuenta como éxito, dónde se emplea el tiempo humano— se derivan de esta descripción.
Medir la línea de base antes de lanzar el agente
Con el proceso descrito, hay que medir la línea de base humana durante un periodo significativo: tiempo hasta completar, tiempo en cola, esfuerzo activo, tasa de reapertura, tasa de escalado, coste por tarea y calidad del resultado. Las líneas de base deben medirse antes de que el agente entre en producción, no reconstruirse de memoria después. Las líneas de base retrospectivas favorecen sistemáticamente al agente: la gente recuerda el caso medio y olvida los rápidos.
Instrumentar el flujo de trabajo como un experimento
Con la línea de base establecida, el flujo del agente se instrumenta como un experimento desde el primer día. Cada ejecución recibe un ID de traza y cada paso relevante es observable. Un registro de ejecución de flujo agrega todo lo que está por encima de la llamada al modelo en una única unidad analizable:
{
  "runId": "run-8f3a2c",
  "workflow": "renewal-risk-summary",
  "agent": "renewal-agent",
  "principalArn": "arn:aws:sts::123456789012:assumed-role/BedrockRuntimeRole/gw-alex",
  "team": "sales-ai",
  "costCenter": "CC-2041",
  "experiment": {
    "variant": "treatment",
    "holdout": False,
    "promptVersion": "v14",
    "policyVersion": "2026-07"
  },
  "ops": {
    "latencyMs": 41200,
    "retries": 1,
    "toolCalls": 6,
    "humanApprovals": 1,
    "humanMinutes": 35,
    "escalations": 0
  },
  "econ": {
    "inputTokens": 48210,
    "outputTokens": 3105,
    "cacheReadTokens": 31500,
    "estCostUsd": 0.87
  },
  "outcome": {
    "status": "success",
    "accepted": True,
    "reopened": False,
    "revenueEventId": "opp-44121"
  }
}
Tres campos merecen atención especial:
- Bloque experiment: se sella al crear la ejecución y se propaga a los metadatos de solicitud de Bedrock, de modo que los registros a nivel de modelo y de flujo se unen limpiamente.
- humanMinutes: lo que la mayoría de los equipos omite y más necesita. Sin él, "el agente hizo el trabajo" excluye silenciosamente los 35 minutos que una persona dedicó a revisarlo.
- revenueEventId: el gancho que hace posible la atribución de ingresos más adelante. Registrarlo no cuesta nada y no puede reconstruirse después.
La regla: si la telemetría del flujo no puede responder a la pregunta de negocio, la instrumentación está incompleta.
Unir costes y resultados
Con los registros de invocación en Amazon S3 (según la Parte 1) y los registros de ejecución en el almacén de análisis, una única unión produce las métricas que importan. Como los registros de Bedrock guardan tokens y no dólares, primero hay que construir una vista que valore cada invocación a partir de los recuentos de tokens y la hoja de tarifas del modelo, agregada por ID de ejecución, y después consultarla con Amazon Athena:
SELECT
  w.workflow,
  w.variant,
  COUNT(*) AS runs,
  SUM(IF(w.outcome_status = 'success', 1, 0)) AS successes,
  ROUND(SUM(c.est_cost_usd) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS cost_per_success,
  ROUND(SUM(w.retries) * 1.0 /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS retries_per_success,
  ROUND(SUM(w.human_minutes) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 1)
    AS human_min_per_success
FROM workflow_runs w
JOIN invocation_costs_by_run c ON c.run_id = w.run_id
GROUP BY w.workflow, w.variant
ORDER BY cost_per_success DESC
Los nombres de columnas y claves de unión de la consulta son ilustrativos; hay que verificarlos con el esquema real de los registros de invocación y el almacén de telemetría, que pueden variar según la implementación.
Coste por resultado exitoso, reintentos por éxito y minutos humanos por éxito son las tres cifras que resisten el escrutinio de un CFO escéptico. El coste por llamada favorece a los agentes que iteran en bucle; el coste por éxito, no. Nótese la agrupación por variante: la misma consulta dividida por brazo de experimento es la comparación de ROI.
Comparar agentes y personas correctamente
La evaluación más creíble es una prueba A/B o con grupo de reserva (holdout). Los grupos de tratamiento y control comparan el flujo asistido por agente con la línea de base humana sin confundir el resultado con cambios de mercado, estacionales u organizativos.
Para flujos de cara al cliente o vinculados a ingresos, la asignación aleatoria debe hacerse a nivel de visitante, lead, cuenta o caso. Para flujos internos, como operaciones de soporte o asistentes de código, se usan cohortes emparejadas: equipos, grupos de repositorios o pods.
La comparación cubre cuatro dimensiones:
- Eficiencia: tiempo hasta completar, horas recuperadas, reducción del tiempo en cola.
- Calidad: tasa de errores, tasa de aprobación, tasa de reapertura, tasa de escalado.
- Coste: coste por tarea, coste por resultado exitoso, coste total de servicio.
- Valor de negocio: aumento de conversión, aumento de retención, tasa de expansión, ingresos por representante o por flujo de trabajo.
Si el agente mejora una dimensión mientras degrada significativamente otra, el resultado es ambiguo y el despliegue necesita ajustes.
Ingresos: la métrica más difícil
Las ganancias de eficiencia son la parte más fácil de demostrar del ROI. El impacto en ingresos es más difícil, y es la métrica con la que la dirección decide la financiación. En flujos cercanos a los ingresos hay que medir si el agente mejora la conversión, el tiempo de respuesta, la progresión de oportunidades o los ingresos por representante. Las pruebas de holdout son la forma más fiable de separar los ingresos incrementales atribuibles al agente del impulso general del negocio.
Cuando el aumento de ingresos es real, la conversación cambia: la organización deja de preguntar si la factura de Bedrock subió y empieza a preguntar si el gasto adicional compra un aumento significativo de la producción del negocio.
El cuadro de mando
Según lo observado por los autores trabajando con clientes, un modelo operativo sólido no requiere cincuenta métricas. Lo que funciona es un cuadro de mando pequeño vinculado a decisiones, revisado con una cadencia regular para cada agente en producción. Los umbrales siguientes son puntos de partida, no prescripciones: hay que calibrarlos con los datos de la propia flota y el contexto organizativo.
| Dimensión | Métrica | Verde | Amarillo | Rojo |
|---|---|---|---|---|
| Adopción | Usuarios activos / usuarios previstos | >70% | 40-70% | <40% |
| Calidad | Tareas completadas sin retrabajo | >90% | 75-90% | <75% |
| Eficiencia | Horas recuperadas por semana | >objetivo | 50-100% del objetivo | <50% del objetivo |
| Coste | Coste por resultado exitoso | ≤presupuesto | 1-1.5x presupuesto | >1.5x presupuesto |
| Impacto en el negocio | Mejora del KPI frente a la línea de base | Significativa | Marginal | Nula o negativa |
Verde significa escalar: el agente supera la línea de base cumpliendo los umbrales de coste y calidad. Amarillo significa ajustar: prometedor, pero necesita trabajo. Rojo significa retirar o rediseñar: el agente consume coste sin suficiente valor medible, y la disposición a retirar de verdad un agente en rojo es lo que da credibilidad al resto del cuadro.
Conclusión
Calcular el coste real de un modelo exige tener en cuenta los cuatro factores ocultos: eficiencia del tokenizador, alineación de salida, eficiencia del bucle agéntico y sobrecoste del razonamiento. Reducir el coste por tarea pasa por la caché de prompts, el enrutado de modelos, las restricciones de salida y la inferencia por lotes. Demostrar el ROI pasa por medir las líneas de base humanas, instrumentar los flujos como experimentos, unir costes con resultados y ejecutar comparaciones con holdout.
La mitad de optimización de costes responde a por qué es caro y cómo arreglarlo; la mitad de ROI responde a si el agente es mejor que las personas. Junto con el modelo operativo de la Parte 1 —atribuir, observar, aplicar, optimizar, operar— forman un marco completo: se puede ver quién gastó, explicar por qué, reducir el desperdicio y justificar lo que queda.
Para empezar, hay que comparar los principales modelos candidatos con los prompts propios usando la evaluación de modelos de Amazon Bedrock, capturar tokens y turnos del bloque usage o de los registros de invocación, tarificarlos según los precios vigentes de Bedrock y dividir por la tasa de éxito. Para la medición del ROI, se recomienda consultar la Well-Architected Agentic AI Lens y sus prácticas recomendadas de gobernanza de costes de agentes. Los autores también invitan a los lectores a compartir en los comentarios otras técnicas para reducir el coste por tarea o medir el ROI de agentes en Amazon Bedrock.