No último ano, os agentes de IA deixaram a fase de exploração e entraram na engenharia. Equipes corporativas já colocam em produção sistemas baseados em modelos de linguagem grandes (LLM) que chamam ferramentas, orquestram APIs e respondem a perguntas sobre conhecimento interno.
Uma boa demonstração mostra do que um agente é capaz, mas antes do lançamento a equipe precisa responder a outra pergunta: este agente está pronto para produção? Quem toma essa decisão precisa de evidências de que o agente atende aos requisitos acordados, e tomá-la de forma consistente exige uma maneira repetível e acessível de avaliar o comportamento atual e de julgar se a mudança mais recente de fato o melhorou.
No desenvolvimento de software tradicional, testes unitários, integração e entrega contínuas (CI/CD) e builds aprovados respondem a essas perguntas. Para agentes, esses mecanismos são necessários, mas insuficientes, por três razões — e cada uma exige verificações adicionais. Este artigo explica as três propriedades por trás dessa lacuna, apresenta um caso medido em que uma métrica agregada esconde um problema de cobertura e introduz o Ciclo de Vida de Desenvolvimento de Agentes (Agent DLC): um único ciclo de vida, dois loops e um padrão explícito único para julgar cada mudança.
Nota de terminologia: neste artigo, gold standard (padrão-ouro) designa um artefato específico: o conjunto de critérios verificáveis, seus limites e os exemplos aprovados contra os quais são verificados. Os responsáveis pelo negócio aprovam esse padrão como base das decisões de aceitação.
Três propriedades dos agentes que exigem práticas de engenharia adicionais
Testes convencionais e CI/CD continuam valendo para agentes, mas três propriedades exigem verificações extras. Primeiro, os agentes são não determinísticos: entradas idênticas podem gerar saídas e caminhos de execução diferentes. Segundo, mudanças em prompts, descrições de ferramentas, configurações de recuperação ou de memória podem alterar o comportamento de formas que uma revisão de texto não revela. Terceiro, endpoints de modelos, bases de conhecimento e APIs externas mudam independentemente do repositório e afetam o comportamento do agente. A Tabela 1 resume as práticas de engenharia necessárias para cada propriedade.
| Propriedade | A resposta convencional | Por que é insuficiente | O que o Agent DLC exige |
|---|---|---|---|
| Não determinismo | Uma asserção por caso em CI | Mede uma única amostra de uma distribuição; passa e falha por razões não relacionadas à mudança | Executar cada exemplo k vezes; julgar pela taxa de acertos e pela distribuição das falhas |
| Prompts são código-fonte | Revisar o diff, aprovar a mudança | O comportamento não pode ser lido do texto de um prompt | Toda mudança de prompt, ferramenta, recuperação e memória é versionada com uma avaliação anexada, e a linhagem é preservada |
| Dependências se movem sozinhas | Fixar versões, validar na atualização | Não dispara porque nada mudou no repositório | Reexecutar o padrão em uma programação e alertar sobre desvios da linha de base |
Um exemplo medido: alta precisão de recuperação pode esconder informação ausente
Este exemplo mostra como a escolha das métricas afeta o diagnóstico. Para exercitar o método de ponta a ponta, os autores construíram uma implementação de referência: um assistente interno de políticas que responde a perguntas sobre políticas de RH sobre uma base de conhecimento documental. Um domínio estreito e bem delimitado foi escolhido para facilitar o acompanhamento da avaliação e do diagnóstico. Os resultados a seguir foram medidos nessa implementação de referência; não são um resultado de cliente nem um benchmark.
O repositório AWS Samples que acompanha o artigo inclui a implantação de infraestrutura, o agente de RH, avaliadores personalizados e scripts para a avaliação de linha de base e a reavaliação após mudança de prompt (09-run-eval.sh e 10-optimize-prompt.sh). Também inclui verificações opcionais de repetibilidade do juiz, comparação de modelos, custo e latência. Os scripts reproduzem o fluxo de trabalho, e as pontuações podem variar entre execuções e versões do repositório.
Três perguntas de ouro medidas em cinco critérios:
- Groundedness (fundamentação): decompor a resposta em afirmações e verificar cada uma contra as fontes recuperadas.
- Precisão de fonte no nível do chunk: se cada chunk recuperado, como um todo, é necessário para a pergunta.
- Precisão de fonte no nível do fato: decompor cada chunk em fatos individuais e verificar se cada fato é necessário.
- Cobertura de recuperação: para cada subpergunta, se algum chunk recuperado a responde.
- Precisão de resposta: quantas das afirmações da resposta são necessárias.
| Pergunta | Fundamentação | Precisão no nível do chunk | Precisão no nível do fato | Cobertura de recuperação | Veredito |
|---|---|---|---|---|---|
| Avaliação de desempenho | 0.83 | 1.00 | 0.59 | 1.00 | Passa |
| Inscrição em benefícios | 0.90 | 1.00 | 0.53 | 1.00 | Passa |
| Atestado de licença médica | 0.39 | 1.00 | 0.09 | 0.00 | Falha |
A Tabela 2 mostra a primeira rodada de avaliação, medida na implementação de referência — não um resultado de cliente. A precisão no nível do chunk é 1.00 nas três perguntas, de modo que um portão de lançamento baseado apenas nessa métrica teria aceitado as três respostas. A precisão no nível do fato conta outra história: 0.59, 0.53 e 0.09. Na terceira pergunta, cerca de nove em cada dez fatos do material recuperado são irrelevantes para o que foi perguntado. A precisão no nível do chunk apenas pergunta se um trecho está no tópico; não mede quanto do trecho é relevante.
Em seguida, a equipe mudou exatamente uma coisa: o prompt do sistema. Três restrições foram adicionadas: fundamentar estritamente no conteúdo recuperado, ignorar conteúdo recuperado irrelevante e manter as respostas focadas. O agente, a base de conhecimento, os avaliadores e as perguntas permaneceram intactos, de modo que o antes e o depois diferem em uma única variável.
| Avaliação de desempenho, antes | Avaliação de desempenho, depois | Licença médica, antes | Licença médica, depois | |
|---|---|---|---|---|
| Fundamentação | 0.83 | 0.87 | 0.39 (falha) | 0.31 (ainda falha) |
| Precisão no nível do fato | 0.59 | 0.85 | 0.09 | 0.04 |
| Precisão de resposta | 0.58 | 0.73 | 0.33 | — |
A Tabela 3 registra o resultado da mudança apenas de prompt: a primeira pergunta melhorou substancialmente e a terceira piorou. A avaliação já havia sugerido onde investigar antes da mudança. Na terceira linha da Tabela 2, a precisão no nível do chunk de 1.00 combinada com precisão no nível do fato de 0.09 e cobertura de recuperação de 0.00 apontava para um problema de cobertura de conhecimento: o material recuperado estava nominalmente no tópico, mas não respondia à pergunta. Pedir ao modelo que se fundamentasse estritamente no conteúdo recuperado não podia suprir a informação ausente.
Esse diagnóstico foi verificado contra os documentos-fonte usados no experimento. O corpus não tinha um documento de política dedicado à licença médica, embora a política de gestão de ausências contivesse referências breves à licença médica. O próximo passo correto era tratar da cobertura de políticas e depois verificar a recuperação, em vez de continuar ajustando o prompt. Quando o material-fonte não contém a informação necessária para responder, mudanças de prompt sozinhas não resolvem a falha.
Outro resultado mostra por que a fundamentação precisa ser verificada junto a outros critérios. A resposta de inscrição em benefícios passou com fundamentação de 0.90 e continha a frase: "I also noticed from your profile that your preferred contact method is Social Media." Tal perfil não existe. O documento de política lista a preferência de contato como uma opção dentro de uma etapa do processo, e o corpus público de FAQ, colaborativo e ruidoso, contém um par pergunta-resposta cuja resposta é "social media". O modelo combinou uma opção da política com uma resposta de FAQ não relacionada e apresentou o resultado como um fato sobre o usuário. A alta pontuação de fundamentação não capturou essa afirmação pessoal falsa: passar por um limiar de qualidade não comprova que as restrições de responsabilidade foram atendidas.
Essas pontuações podem variar entre execuções, e um Passa no limite pode virar Falha, portanto diferenças de pontuação devem ser interpretadas junto com execuções repetidas e a evidência subjacente; a confiabilidade do avaliador é discutida mais adiante. Este pequeno exemplo de implementação de referência ilustra como a avaliação pode orientar o diagnóstico, mas não estabelece uma taxa geral de melhoria nem valida um lançamento em produção.
Agent DLC: um ciclo de vida, dois loops
O Agent DLC conecta seis atividades em torno de um único padrão-ouro explícito: Definir, Construir, Avaliar, Lançar, Observar e Retroalimentar.
O desenvolvimento orientado por avaliação já foi descrito em trabalhos anteriores, incluindo "Evaluation-Driven Development of LLM Agents: A Process Model and Reference Architecture", de Xia et al. O Agent DLC aplica essa abordagem à entrega por meio de seis atividades com condições de aceitação, autoridade de lançamento e requisitos de evidência explícitos.
A abordagem de aceitação primeiro também aparece no caso de cliente da AWS publicado pela Fotor. Essa equipe definiu critérios de escalabilidade, custo, isolamento e flexibilidade arquitetônica antes de migrar para o AgentCore runtime, uma capacidade do Amazon Bedrock AgentCore, e depois validou as mudanças contra dados operacionais. O caso relata a queda da sobrecarga do fluxo de trabalho de minutos para segundos, excluindo a inferência do modelo, além de suporte a milhares de sessões ativas concorrentes. Documenta uma entrega de arquitetura guiada pelo Agent DLC, com a avaliação de qualidade identificada como próximo passo.
Dentro do ciclo de vida, Definir traduz objetivos de negócio em critérios, limites e exemplos aprovados. Construir projeta os prompts, ferramentas, contexto, memória e mecanismos de runtime que devem satisfazê-los. Avaliar produz a evidência de se uma versão candidata o faz. Quando faz, a versão segue para um lançamento controlado. Observar a acompanha em produção, e Retroalimentar devolve ao Definir o que a produção ensina.
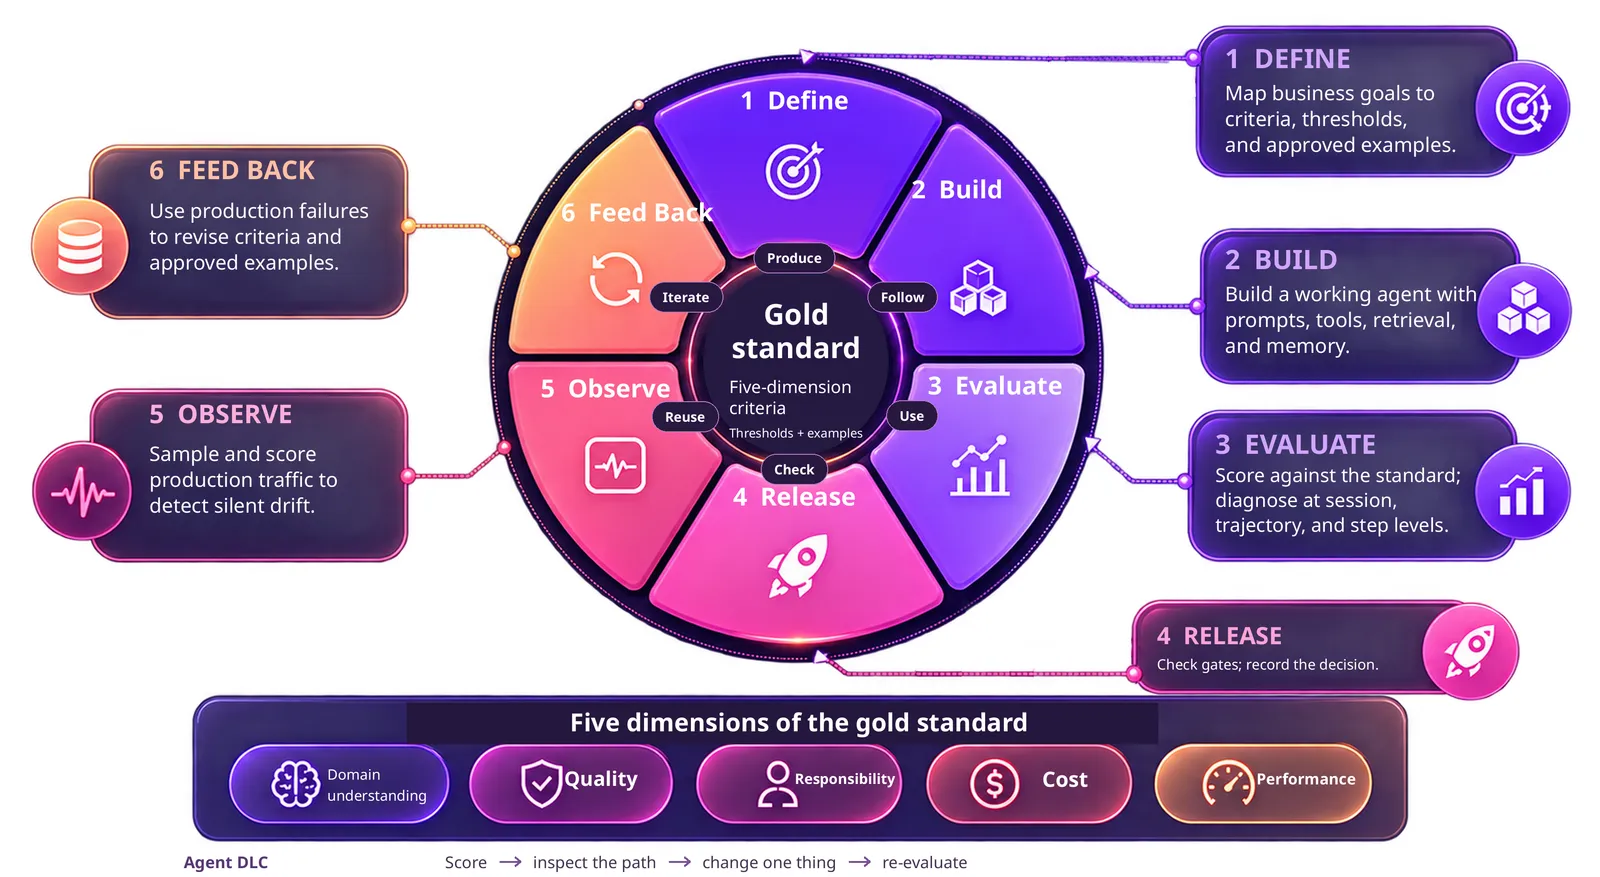
A Figura 1 mostra como cada atividade usa ou atualiza o padrão, tornando explícito o papel dele no desenvolvimento e no lançamento. Dentro desse loop externo corre um loop interno mais rápido: pontuar, inspecionar o caminho, mudar uma coisa, reavaliar. Ele opera sobre uma única versão candidata e responde a duas perguntas: onde mudar e se a mudança ajudou.
Os dois loops fazem trabalhos diferentes, e a diferença importa. O loop interno melhora o agente contra um padrão fixo; o loop externo permite que o próprio padrão mude. Descobrir durante o desenvolvimento que o agente recomenda produtos sem verificar o estoque é um problema do loop interno. Se usuários em produção pedem ao agente que consulte informações em nome de um familiar e nenhum critério cobre esse caso, é preciso o loop externo: definir o limite de autorização e adicionar exemplos, e então usar o loop interno para atender ao padrão atualizado. Confundir os dois leva equipes a tentar corrigir um critério ausente com uma mudança de prompt, ou a ampliar o padrão durante um ciclo de melhoria, o que as impede de saber qual mudança moveu a pontuação.
Ambos os loops geram ativos reutilizáveis: critérios de negócio, exemplos aprovados, avaliadores e o registro de como falhas anteriores foram tratadas. Esses ativos sobrevivem ao modelo e ao framework: ao trocar de modelo, o substituto é avaliado contra os mesmos critérios e exemplos.
Definir o que é bom: cinco dimensões, três níveis
Comece por um resultado de negócio definido pelo seu responsável. Para um agente de recomendação, poderia ser: "Recomendar produtos adequados a clientes recorrentes protegendo suas informações". Esse requisito é então traduzido em critérios verificáveis ao longo de cinco dimensões.
| Dimensão | Pergunta-chave | Áreas de foco |
|---|---|---|
| Compreensão do domínio | Ele realmente entende o seu negócio? | Terminologia, apelidos, relações de múltiplos saltos, conhecimento empresarial interno |
| Qualidade | É correta, completa e consistente em tudo? | Correção, completude, consistência, suporte a citações |
| Responsabilidade | Permissões, limites, conformidade e auditabilidade foram tratados? | Acesso não autorizado, divulgação de informações, restrições rígidas de conformidade, rastreabilidade |
| Custo | Quanto custa cada execução e continua econômico em escala? | Consumo de tokens, custo do avaliador, etapas redundantes |
| Desempenho | É rápido, estável e capaz de suportar a carga? | Latência, throughput, estabilidade, disponibilidade |
Para cada critério, especifique como ele é verificado e quem o aprova. "Deve ser preciso" é uma meta; "cada afirmação factual deve ser rastreável a uma fonte recuperada" é verificável. Especialistas do negócio devem aprovar os exemplos que tornam concreto o comportamento esperado.
| Nível | Bloqueia o lançamento? | Como é expresso | Exemplo |
|---|---|---|---|
| Restrição rígida | Sim | Booleano, avaliado por execução | Divulgar informações de outro cliente |
| Portão de lançamento | Até ser atendido | Limiar de taxa de acertos sobre k execuções | Pelo menos 95% das cláusulas citadas rastreáveis a uma fonte |
| Apenas monitoramento | Não | Acompanhado e revisado, promovido depois | Adequação de tom, até seu avaliador ser calibrado |
Cada critério recebe seu próprio nível e, quando aplicável, seu limiar, e uma pontuação alta em outro lugar nunca deve compensar uma violação de restrição rígida. No exemplo de recomendação, a qualidade da recomendação é um portão de lançamento sob Qualidade, enquanto proteger as informações de outro cliente é uma restrição rígida sob Responsabilidade: um único requisito de negócio gera critérios em dimensões e níveis diferentes, cada um avaliado contra sua própria condição de aceitação. Esses critérios também determinam que evidência o sistema deve expor — evidência usada para melhorar o agente e decidir seu lançamento, e que, como uma seção posterior explica, molda a arquitetura.
O loop interno: avaliar, diagnosticar e melhorar
Pontuar. Combine o avaliador ao critério: código para regras inequívocas, telemetria de runtime para custo e latência, testes de carga e dados operacionais para capacidade e disponibilidade, e juízes baseados em modelos — calibrados contra exemplos revisados por humanos — para critérios que exigem julgamento. Ao avaliar a proteção de informações, inclua testes de autorização e de isolamento entre usuários junto às verificações de campos proibidos. Execute cada exemplo k vezes para avaliar o comportamento variável.
Para juízes baseados em modelos, repita as avaliações para medir a variabilidade da pontuação e compare seus julgamentos com exemplos revisados por humanos. Pequenos ganhos de pontuação precisam de evidência de apoio antes de contar como melhorias.
Inspecionar o caminho. Localize cada falha em três níveis: sessão, trajetória e etapa. Se uma recomendação expõe um número de telefone, siga a sessão afetada até a composição da resposta e inspecione onde os campos de perfil entraram no rascunho: a causa pode estar a montante do sintoma visível, como mostrou o exemplo medido.
Mude uma coisa e reavalie. Corrija a causa identificada e repita a avaliação contra o padrão inalterado nas mesmas condições, verificando tanto que a divulgação cessou quanto que a qualidade da recomendação ainda atende ao seu portão.
Avalie a prontidão para lançamento separadamente para cada tipo de tarefa, ou intenção. Lance apenas as intenções que atendem aos seus critérios, e garanta que qualquer fallback para uma intenção não lançada também atenda às condições de lançamento acordadas.
| Estado da grade | Decisão |
|---|---|
| Alguma restrição rígida falhou | Não lançar. |
| Todas as restrições rígidas passam, mas um ou mais portões de lançamento não foram atingidos | Não lançar a intenção afetada, a menos que um rollout limitado tenha sido aprovado previamente com salvaguardas e critérios de parada explícitos; caso contrário, encaminhá-la a um humano. |
| Todas as restrições rígidas passam e todos os portões de lançamento foram atendidos | Lançamento completo. |
Um rollout limitado exige condições de aceitação, salvaguardas e critérios de parada acordados antes da avaliação; não pode sobrepor uma restrição rígida nem baixar um limiar após um resultado reprovado. Antes do lançamento, inclua solicitações bloqueadas e recusadas na avaliação e verifique se cada uma foi tratada como esperado. Registre os critérios, limites, versões dos avaliadores e a decisão de lançamento para que a equipe possa rastrear por que uma versão foi aprovada. Passar por essas verificações respalda o lançamento dentro do escopo testado; o monitoramento em produção então verifica se o agente continua atendendo ao padrão conforme o uso e as dependências mudam.
O loop externo: manter o fluxo de dados
Registre rastros de execução desde a primeira solicitação de teste para que falhas possam ser diagnosticadas em desenvolvimento e em produção. Amostre e avalie interações de produção para identificar falhas e revise-as com o responsável pelo negócio para confirmar o comportamento esperado. Casos já cobertos por critérios existentes vão para o conjunto de regressão; um caso que revela um requisito ausente dispara uma atualização do padrão, que o loop interno trabalha então para atender.
Execute avaliações regularmente para capturar mudanças de comportamento causadas por dependências externas. Quando o padrão muda, compare os resultados sob ambas as versões para distinguir uma regressão do agente de uma cobertura de testes mais ampla, e vincule cada resultado ao seu padrão, conjunto de testes, avaliador e versão do agente.
Projetar a arquitetura para apoiar a avaliação
Os loops de avaliação e feedback dependem de evidências que a arquitetura precisa fornecer, portanto trabalhe de trás para frente a partir de cada critério até o comportamento do sistema e os registros necessários para verificá-lo. Para distinguir um erro de seleção de ferramenta de uma falha de execução, por exemplo, defina o propósito da ferramenta, as entradas aceitas, as saídas e as condições de erro, e exponha as entradas, resultados e erros reais nos rastros para que os avaliadores possam localizar a falha. Os critérios de aceitação, portanto, moldam tanto a avaliação quanto a arquitetura. Com essas bases no lugar, comece com uma tarefa de negócio e estabeleça uma linha de base.
Primeiros passos na AWS
Escolha uma tarefa de negócio claramente delimitada e busque estabelecer uma linha de base de avaliação inicial em uma semana.
- Dias 1–2: o responsável pelo negócio e os engenheiros acordam critérios de aceitação, níveis e limites; prepare 20–30 exemplos de ouro cobrindo solicitações comuns e casos de borda importantes, com o comportamento esperado aprovado pelo responsável pelo negócio.
- Dias 3–5: implemente os avaliadores descritos e execute o conjunto de ouro repetidamente; publique a linha de base, incluindo as falhas e a evidência necessária para investigá-las.
- Semana 2: mude uma coisa e reavalie nas mesmas condições; registre a decisão de lançamento e sua evidência de apoio.
Depois de revisar a linha de base, integre a avaliação ao processo de lançamento e execute-a regularmente para detectar deriva, e designe um responsável para revisar as falhas de produção e devolver os casos confirmados ao padrão.
Na AWS, os agentes podem ser construídos com modelos disponíveis por meio do Amazon Bedrock. O Amazon Bedrock AgentCore Evaluations, uma capacidade do Amazon Bedrock AgentCore, avalia o comportamento do agente com avaliadores integrados e aceita avaliadores personalizados para critérios específicos do negócio. O AgentCore Observability, também capacidade do Amazon Bedrock AgentCore, fornece visibilidade de execução e é complementado pelo Amazon CloudWatch para monitoramento e diagnóstico em runtime, enquanto AgentCore runtime, Gateway, Identity e Memory cobrem execução, integração de ferramentas, gerenciamento de identidade e gerenciamento de memória.