Durante el último año, los agentes de IA han pasado de la exploración a la ingeniería. Los equipos empresariales ya despliegan sistemas basados en modelos de lenguaje grandes (LLM) que invocan herramientas, orquestan API y responden preguntas sobre conocimiento interno.
Una demostración lograda puede mostrar de lo que es capaz un agente, pero antes del lanzamiento el equipo debe responder otra pregunta: ¿está este agente listo para producción? Quien toma esa decisión necesita evidencia de que el agente cumple los requisitos acordados, y tomarla de forma consistente exige una manera repetible y asequible de evaluar el comportamiento actual y de juzgar si el último cambio realmente lo mejoró.
En el desarrollo de software tradicional, las pruebas unitarias, la integración y entrega continuas (CI/CD) y las compilaciones que pasan responden a esas preguntas. Para los agentes, esos mecanismos son necesarios pero insuficientes por tres razones, y cada una exige comprobaciones adicionales. Este artículo explica las tres propiedades detrás de esa brecha, presenta un caso medido en el que una métrica agregada oculta un problema de cobertura e introduce el Ciclo de Vida de Desarrollo de Agentes (Agent DLC): un solo ciclo de vida, dos bucles y un estándar explícito único para juzgar cada cambio.
Nota terminológica: en este artículo, gold standard (estándar de oro) designa un artefacto concreto: el paquete de criterios verificables, sus umbrales y los ejemplos aprobados contra los que se comprueban. Los responsables de negocio aprueban este estándar como base de las decisiones de aceptación.
Tres propiedades de los agentes que exigen prácticas de ingeniería adicionales
Las pruebas convencionales y CI/CD siguen aplicándose a los agentes, pero tres propiedades requieren verificaciones adicionales. Primero, los agentes son no deterministas: entradas idénticas pueden producir salidas y rutas de ejecución distintas. Segundo, los cambios en prompts, descripciones de herramientas, ajustes de recuperación o configuración de memoria pueden alterar el comportamiento de formas que una revisión de texto no puede revelar. Tercero, los endpoints de modelos, las bases de conocimiento y las API externas cambian con independencia del repositorio y afectan al comportamiento del agente. La Tabla 1 resume las prácticas de ingeniería necesarias para cada propiedad.
| Propiedad | La respuesta convencional | Por qué se queda corta | Lo que exige Agent DLC |
|---|---|---|---|
| No determinismo | Una aserción por caso en CI | Mide una sola muestra de una distribución; pasa y falla por razones ajenas al cambio | Ejecutar cada ejemplo k veces; juzgar por la tasa de aciertos y la distribución de fallos |
| Los prompts son código fuente | Revisar el diff, aprobar el cambio | El comportamiento no se deduce del texto de un prompt | Cada cambio de prompt, herramienta, recuperación y memoria se versiona con una evaluación adjunta y se conserva el linaje |
| Las dependencias se mueven por sí solas | Fijar versiones, validar al actualizar | No se dispara porque nada cambió en el repositorio | Volver a ejecutar el estándar de forma programada y alertar sobre desviaciones respecto a la línea base |
Un ejemplo medido: una alta precisión de recuperación puede ocultar información que falta
Este ejemplo muestra cómo la elección de métricas afecta al diagnóstico. Para ejercitar el método de extremo a extremo, los autores construyeron una implementación de referencia: un asistente interno de políticas que responde preguntas de políticas de RR. HH. sobre una base de conocimiento documental. Se eligió un dominio estrecho y bien delimitado para que la evaluación y el diagnóstico fueran fáciles de seguir. Los resultados siguientes se midieron sobre esta implementación de referencia; no son un resultado de cliente ni un benchmark.
El repositorio AWS Samples que lo acompaña incluye el despliegue de infraestructura, el agente de RR. HH., evaluadores personalizados y scripts para la evaluación de línea base y la reevaluación tras un cambio de prompt (09-run-eval.sh y 10-optimize-prompt.sh). También incluye comprobaciones opcionales de repetibilidad del juez, comparación de modelos, coste y latencia. Los scripts reproducen el flujo de trabajo, y las puntuaciones pueden variar entre ejecuciones y versiones del repositorio.
Tres preguntas doradas medidas en cinco criterios:
- Groundedness (fundamentación): descomponer la respuesta en afirmaciones y comprobar cada una contra las fuentes recuperadas.
- Precisión de fuente a nivel de chunk: si cada chunk recuperado, en su conjunto, es necesario para la pregunta.
- Precisión de fuente a nivel de hecho: descomponer cada chunk en hechos individuales y comprobar si cada hecho es necesario.
- Cobertura de recuperación: para cada subpregunta, si algún chunk recuperado la responde.
- Precisión de respuesta: cuántas de las afirmaciones de la respuesta son necesarias.
| Pregunta | Fundamentación | Precisión a nivel de chunk | Precisión a nivel de hecho | Cobertura de recuperación | Veredicto |
|---|---|---|---|---|---|
| Evaluación de desempeño | 0.83 | 1.00 | 0.59 | 1.00 | Pasa |
| Inscripción de beneficios | 0.90 | 1.00 | 0.53 | 1.00 | Pasa |
| Certificado de baja por enfermedad | 0.39 | 1.00 | 0.09 | 0.00 | Falla |
La Tabla 2 muestra la primera ronda de evaluación, medida sobre la implementación de referencia, no un resultado de cliente. La precisión a nivel de chunk es 1.00 en las tres preguntas, de modo que una puerta de lanzamiento basada solo en esa métrica habría aceptado las tres respuestas. La precisión a nivel de hecho cuenta otra historia: 0.59, 0.53 y 0.09. En la tercera pregunta, aproximadamente nueve de cada diez hechos del material recuperado son irrelevantes para lo preguntado. La precisión a nivel de chunk solo pregunta si un pasaje está en tema; no mide cuánto del pasaje es relevante.
Después el equipo cambió exactamente una cosa: el prompt del sistema. Añadieron tres restricciones: fundamentar estrictamente en el contenido recuperado, ignorar el contenido recuperado irrelevante y mantener respuestas enfocadas. El agente, la base de conocimiento, los evaluadores y las preguntas quedaron intactos, de modo que el antes y el después difieren en una sola variable.
| Evaluación de desempeño, antes | Evaluación de desempeño, después | Baja por enfermedad, antes | Baja por enfermedad, después | |
|---|---|---|---|---|
| Fundamentación | 0.83 | 0.87 | 0.39 (falla) | 0.31 (sigue fallando) |
| Precisión a nivel de hecho | 0.59 | 0.85 | 0.09 | 0.04 |
| Precisión de respuesta | 0.58 | 0.73 | 0.33 | — |
La Tabla 3 recoge el resultado del cambio solo de prompt: la primera pregunta mejoró sustancialmente y la tercera empeoró. La evaluación ya había sugerido dónde investigar antes del cambio. En la tercera fila de la Tabla 2, la precisión a nivel de chunk de 1.00 junto con una precisión a nivel de hecho de 0.09 y una cobertura de recuperación de 0.00 apuntaban a un problema de cobertura de conocimiento: el material recuperado estaba nominalmente en tema pero no respondía a la pregunta. Pedir al modelo que se fundamentara estrictamente en el contenido recuperado no podía aportar la información ausente.
Ese diagnóstico se verificó contra los documentos fuente usados en el experimento. El corpus carecía de un documento de política dedicado a la baja por enfermedad, aunque la política de gestión de ausencias contenía referencias breves a la baja por enfermedad. El siguiente paso correcto era abordar la cobertura de políticas y después revisar la recuperación, en lugar de seguir cambiando el prompt. Cuando el material fuente carece de la información necesaria para responder, los cambios de prompt por sí solos no pueden resolver el fallo.
Otro resultado muestra por qué la fundamentación debe comprobarse junto a otros criterios. La respuesta de inscripción de beneficios pasó con una fundamentación de 0.90 y contenía esta frase: "I also noticed from your profile that your preferred contact method is Social Media." No existe tal perfil. El documento de política lista la preferencia de contacto como una opción dentro de un paso del proceso, y el corpus público de FAQ, colaborativo y ruidoso, contiene un par pregunta-respuesta cuya respuesta es "social media". El modelo combinó una opción de la política con una respuesta de FAQ no relacionada y la presentó como un hecho sobre el usuario. La alta puntuación de fundamentación no detectó esta afirmación personal falsa: superar un umbral de calidad no demuestra que se cumplan las restricciones de responsabilidad.
Estas puntuaciones pueden variar entre ejecuciones, y un Pasa ajustado puede convertirse en Falla, por lo que las diferencias de puntuación deben interpretarse junto con ejecuciones repetidas y la evidencia subyacente; la fiabilidad del evaluador se trata más adelante. Este pequeño ejemplo de implementación de referencia ilustra cómo la evaluación puede guiar el diagnóstico, pero no establece una tasa general de mejora ni valida un lanzamiento a producción.
Agent DLC: un ciclo de vida, dos bucles
Agent DLC conecta seis actividades alrededor de un único estándar de oro explícito: Definir, Construir, Evaluar, Lanzar, Observar y Retroalimentar.
El desarrollo guiado por evaluación ya se describió en trabajos anteriores, entre ellos "Evaluation-Driven Development of LLM Agents: A Process Model and Reference Architecture" de Xia et al. Agent DLC aplica ese enfoque a la entrega mediante seis actividades con condiciones de aceptación, autoridad de lanzamiento y requisitos de evidencia explícitos.
El enfoque de aceptación primero también aparece en el caso de cliente de AWS publicado por Fotor. Ese equipo definió criterios de escalabilidad, coste, aislamiento y flexibilidad arquitectónica antes de migrar a AgentCore runtime, una capacidad de Amazon Bedrock AgentCore, y después validó los cambios contra datos operativos. El caso reporta que la sobrecarga del flujo de trabajo bajó de minutos a segundos, excluyendo la inferencia del modelo, y soporte para miles de sesiones activas concurrentes. Documenta una entrega de arquitectura guiada por Agent DLC, con la evaluación de calidad identificada como siguiente paso.
Dentro del ciclo de vida, Definir traduce los objetivos de negocio en criterios, umbrales y ejemplos aprobados. Construir diseña los prompts, herramientas, contexto, memoria y mecanismos de runtime que deben satisfacerlos. Evaluar produce la evidencia que indica si una versión candidata lo hace. Cuando lo hace, la versión pasa a un lanzamiento controlado. Observar la vigila en producción y Retroalimentar devuelve a Definir lo que enseña la producción.
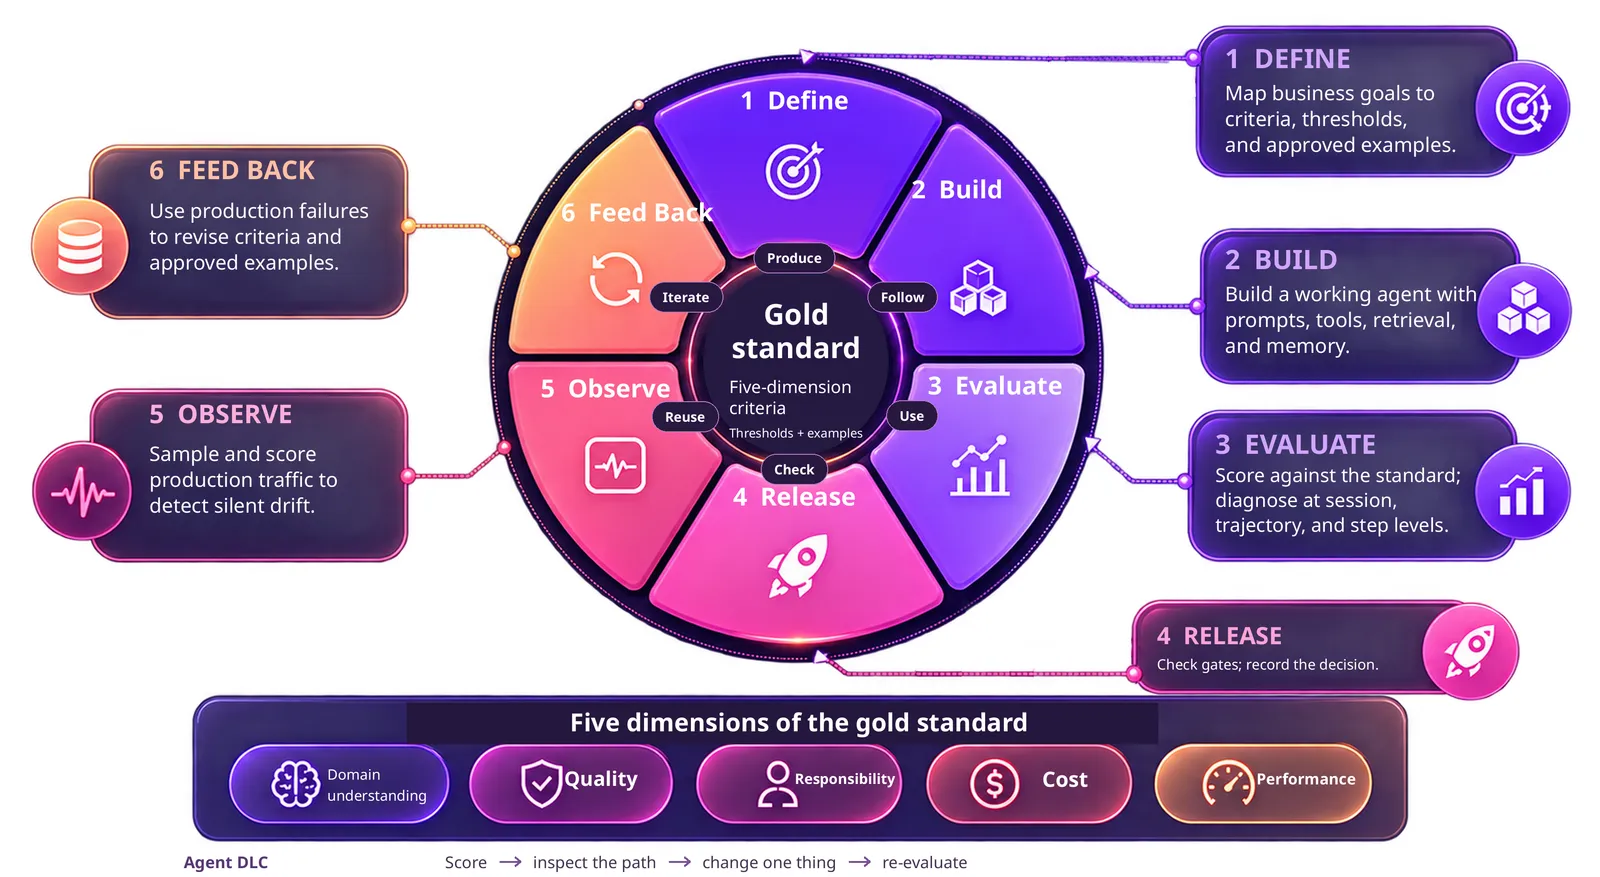
La Figura 1 muestra cómo cada actividad usa o actualiza el estándar, haciendo explícito su papel en desarrollo y lanzamiento. Dentro de ese bucle exterior corre un bucle interior más rápido: puntuar, inspeccionar la ruta, cambiar una cosa, reevaluar. Opera sobre una sola versión candidata y responde dos preguntas: dónde cambiar y si el cambio ayudó.
Los dos bucles hacen trabajos distintos, y la diferencia importa. El bucle interior mejora al agente contra un estándar fijo; el bucle exterior permite que el estándar cambie. Descubrir durante el desarrollo que el agente recomienda productos sin comprobar inventario es un problema del bucle interior. Si los usuarios en producción piden al agente consultar información a nombre de un familiar y ningún criterio cubre ese caso, hace falta el bucle exterior: definir el límite de autorización y añadir ejemplos, y luego usar el bucle interior para cumplir el estándar actualizado. Confundir ambos lleva a intentar arreglar un criterio ausente con un cambio de prompt, o a ampliar el estándar durante un ciclo de mejora, lo que impide saber qué cambio movió la puntuación.
Ambos bucles generan activos reutilizables: criterios de negocio, ejemplos aprobados, evaluadores y el registro de cómo se gestionaron fallos anteriores. Estos activos sobreviven al modelo y al framework: al cambiar de modelo, el reemplazo se evalúa contra los mismos criterios y ejemplos.
Definir lo bueno: cinco dimensiones, tres niveles
Se parte de un resultado de negocio definido por su responsable. Para un agente de recomendación podría ser: "Recomendar productos adecuados a clientes recurrentes protegiendo su información". Ese requisito se traduce en criterios verificables a lo largo de cinco dimensiones.
| Dimensión | Pregunta clave | Áreas de enfoque |
|---|---|---|
| Comprensión del dominio | ¿Comprende realmente tu negocio? | Terminología, alias, relaciones de varios saltos, conocimiento empresarial interno |
| Calidad | ¿Es correcta, completa y consistente en todo? | Corrección, completitud, consistencia, soporte de citas |
| Responsabilidad | ¿Se abordan permisos, límites, cumplimiento y auditabilidad? | Acceso no autorizado, divulgación de información, restricciones duras de cumplimiento, trazabilidad |
| Coste | ¿Cuánto cuesta cada ejecución y sigue siendo económico a escala? | Consumo de tokens, coste del evaluador, pasos redundantes |
| Rendimiento | ¿Es rápido, estable y capaz de soportar la carga? | Latencia, rendimiento, estabilidad, disponibilidad |
Para cada criterio hay que especificar cómo se verifica y quién lo aprueba. "Debe ser preciso" es una meta; "cada afirmación factual debe ser trazable a una fuente recuperada" es verificable. Los expertos de negocio deben aprobar los ejemplos que hacen concreto el comportamiento esperado.
| Nivel | ¿Bloquea el lanzamiento? | Cómo se expresa | Ejemplo |
|---|---|---|---|
| Restricción dura | Sí | Booleano, evaluado por ejecución | Divulgar información de otro cliente |
| Puerta de lanzamiento | Hasta cumplirse | Umbral de tasa de aciertos sobre k ejecuciones | Al menos el 95% de las cláusulas citadas trazables a una fuente |
| Solo monitorización | No | Seguimiento y revisión, promovido después | Adecuación del tono, hasta calibrar su evaluador |
Cada criterio recibe su propio nivel y, cuando aplica, su umbral, y una puntuación alta en otra parte nunca debe compensar una violación de restricción dura. En el ejemplo de recomendación, la calidad de recomendación es una puerta de lanzamiento bajo Calidad, mientras que proteger la información de otro cliente es una restricción dura bajo Responsabilidad: un único requisito de negocio produce criterios en distintas dimensiones y niveles, cada uno evaluado contra su propia condición de aceptación. Estos criterios también determinan qué evidencia debe exponer el sistema, evidencia que se usa para mejorar el agente y decidir su lanzamiento y que, como explica una sección posterior, da forma a la arquitectura.
El bucle interior: evaluar, diagnosticar y mejorar
Puntuar. Hay que ajustar el evaluador al criterio: código para reglas inequívocas, telemetría de runtime para coste y latencia, pruebas de carga y datos operativos para capacidad y disponibilidad, y jueces basados en modelos —calibrados contra ejemplos revisados por humanos— para los criterios que requieren juicio. Al evaluar la protección de información, incluir pruebas de autorización y de aislamiento entre usuarios junto a comprobaciones de campos prohibidos. Ejecutar cada ejemplo k veces para evaluar el comportamiento variable.
Para los jueces basados en modelos, repetir las evaluaciones para medir la variabilidad de puntuación y comparar sus juicios con ejemplos revisados por humanos. Las mejoras de puntuación pequeñas necesitan evidencia de respaldo antes de contar como mejoras.
Inspeccionar la ruta. Localizar cada fallo en tres niveles: sesión, trayectoria y paso. Si una recomendación expone un número de teléfono, seguir la sesión afectada hasta la composición de la respuesta e inspeccionar dónde entraron los campos de perfil en el borrador: la causa puede estar río arriba del síntoma visible, como mostró el ejemplo medido.
Cambiar una cosa y reevaluar. Corregir la causa identificada y repetir la evaluación contra el estándar sin cambios en las mismas condiciones, verificando tanto que la divulgación cesó como que la calidad de recomendación sigue cumpliendo su puerta.
Evaluar la preparación para lanzamiento por separado para cada tipo de tarea, o intención. Lanzar solo las intenciones que cumplen sus criterios, y asegurar que cualquier fallback para una intención no lanzada también cumpla las condiciones de lanzamiento acordadas.
| Estado de la cuadrícula | Decisión |
|---|---|
| Alguna restricción dura falló | No lanzar. |
| Todas las restricciones duras pasan, pero una o más puertas de lanzamiento no se cumplieron | No lanzar la intención afectada salvo que se aprobara de antemano un despliegue limitado con salvaguardas y criterios de parada explícitos; si no, derivarla a un humano. |
| Todas las restricciones duras pasan y todas las puertas de lanzamiento se cumplen | Lanzamiento completo. |
Un despliegue limitado requiere condiciones de aceptación, salvaguardas y criterios de parada acordados antes de la evaluación; no puede anular una restricción dura ni bajar un umbral tras un resultado fallido. Antes del lanzamiento, incluir las solicitudes bloqueadas y rechazadas en la evaluación y comprobar que cada una se gestionó como se esperaba. Registrar los criterios, umbrales, versiones de evaluador y la decisión de lanzamiento para que el equipo pueda rastrear por qué se aprobó una versión. Superar estas comprobaciones respalda el lanzamiento dentro del ámbito probado; la monitorización en producción verifica después que el agente sigue cumpliendo el estándar a medida que cambian el uso y las dependencias.
El bucle exterior: mantener el flujo de datos
Registrar trazas de ejecución desde la primera solicitud de prueba para poder diagnosticar fallos en desarrollo y en producción. Muestrear y evaluar interacciones de producción para identificar fallos y revisarlos con el responsable de negocio para confirmar el comportamiento esperado. Los casos ya cubiertos por criterios existentes pasan al conjunto de regresión; un caso que revela un requisito ausente provoca una actualización del estándar, que el bucle interior trabaja luego por cumplir.
Ejecutar evaluaciones con regularidad para detectar cambios de comportamiento causados por dependencias externas. Cuando el estándar cambia, comparar los resultados bajo ambas versiones para distinguir una regresión del agente de una cobertura de pruebas más amplia, y vincular cada resultado a su estándar, conjunto de pruebas, evaluador y versión del agente.
Diseñar la arquitectura para soportar la evaluación
Los bucles de evaluación y retroalimentación dependen de evidencia que la arquitectura debe proporcionar, así que hay que trabajar hacia atrás desde cada criterio hasta el comportamiento del sistema y los registros necesarios para verificarlo. Para distinguir un error de selección de herramienta de un fallo de ejecución, por ejemplo, hay que definir el propósito de la herramienta, las entradas aceptadas, las salidas y las condiciones de error, y exponer las entradas, resultados y errores reales en las trazas para que los evaluadores puedan localizar el fallo. Los criterios de aceptación, por tanto, dan forma tanto a la evaluación como a la arquitectura. Con esos cimientos en su lugar, se empieza con una tarea de negocio y se establece una línea base.
Primeros pasos en AWS
Elegir una tarea de negocio claramente delimitada y aspirar a establecer una línea base de evaluación inicial en una semana.
- Días 1–2: el responsable de negocio y los ingenieros acuerdan criterios de aceptación, niveles y umbrales; preparar 20–30 ejemplos dorados que cubran solicitudes comunes y casos límite importantes, con el comportamiento esperado aprobado por el responsable de negocio.
- Días 3–5: implementar los evaluadores descritos y ejecutar el conjunto dorado repetidamente; publicar la línea base, incluidos los fallos y la evidencia necesaria para investigarlos.
- Semana 2: cambiar una cosa y reevaluar en las mismas condiciones; registrar la decisión de lanzamiento y su evidencia de respaldo.
Tras revisar la línea base, integrar la evaluación en el proceso de lanzamiento y ejecutarla con regularidad para detectar deriva, y asignar un responsable para revisar los fallos de producción y devolver los casos confirmados al estándar.
En AWS, los agentes pueden construirse con modelos disponibles a través de Amazon Bedrock. Amazon Bedrock AgentCore Evaluations, una capacidad de Amazon Bedrock AgentCore, evalúa el comportamiento del agente con evaluadores integrados y admite evaluadores personalizados para criterios específicos del negocio. AgentCore Observability, también capacidad de Amazon Bedrock AgentCore, aporta visibilidad de ejecución y se complementa con Amazon CloudWatch para monitorización y diagnóstico en runtime, mientras que AgentCore runtime, Gateway, Identity y Memory cubren ejecución, integración de herramientas, gestión de identidad y gestión de memoria.