A Natera, empresa especializada em testes de DNA livre de células (cfDNA), depende da disponibilidade contínua de seus instrumentos de laboratório, porque falhas nos equipamentos interrompem o processamento de amostras. A equipe de engenharia de laboratório da companhia, liderada por Ariel Jirau, trabalhou com a AWS para criar o SWARM (Systematic Workflow Analytics and Resolutions Manager), um sistema de IA agêntica para operações de laboratório construído sobre o Amazon Bedrock AgentCore. O sistema entrega uma primeira resposta cerca de 130 vezes mais rápida e alcança cobertura automatizada de 96,2% dos tickets de suporte, colocando o conhecimento institucional nas mãos dos engenheiros no momento em que um ticket chega. Este relato percorre a arquitetura completa, da construção da base de conhecimento à implantação automatizada e à avaliação.
O problema da continuidade do conhecimento
As operações de laboratório da Natera dependem de uma ampla variedade de instrumentos de precisão distribuídos em várias famílias de equipamentos, cada uma com seus próprios modos de falha, documentação de fornecedor e padrões de resolução. A equipe de engenharia de serviço responsável por manter essa infraestrutura era organizada em torno de conhecimento individual profundo, e não de procedimentos padronizados. Quando um técnico sênior que havia passado anos diagnosticando uma determinada família de instrumentos saiu da empresa, o conhecimento que ele carregava foi efetivamente perdido, e não existia nenhum sistema para capturar, organizar ou implantar essa experiência em escala.
A operação lida com mais de 65 tickets por dia em três filas do Jira, com tempo médio de primeira resposta de 17,4 horas, e o tempo de inatividade dos instrumentos atrasava amostras de laboratório e relatórios de pacientes. Contratar mais engenheiros não acompanhava o ritmo. O SWARM precisava responder em minutos, produzir diagnósticos precisos para uma grande variedade de equipamentos e melhorar continuamente por meio de um ciclo de avaliação estruturado.
Por que o Amazon Bedrock AgentCore
A equipe optou por construir o SWARM sobre o Amazon Bedrock AgentCore, um serviço da AWS totalmente gerenciado e extensível, projetado para criar, implantar, conectar, proteger e operar agentes de IA em escala. Três requisitos centrais orientaram a decisão:
- Processamento autônomo de grandes volumes de tickets de suporte sem intervenção humana.
- Integração profunda com ferramentas operacionais já em uso, como Jira e Confluence.
- Segurança e observabilidade integradas — criptografia, integração com o AWS Identity and Access Management (IAM) e rastreamento distribuído — sem que a equipe precisasse construir e manter infraestrutura própria.
"Precisávamos de um ambiente de execução gerenciado que nos permitisse concentrar o esforço de engenharia na precisão do diagnóstico, e não em infraestrutura: o AgentCore nos deu isso, junto com gerenciamento de identidade integrado e a flexibilidade de trocar de modelo sem reescrever a lógica do agente", disse Jirau.
O AgentCore oferece integração nativa com o Amazon DynamoDB, um serviço de banco de dados NoSQL totalmente gerenciado, o Amazon Simple Queue Service (Amazon SQS) e o AWS X-Ray, um recurso do Amazon CloudWatch.
Dois agentes, uma biblioteca de habilidades compartilhada
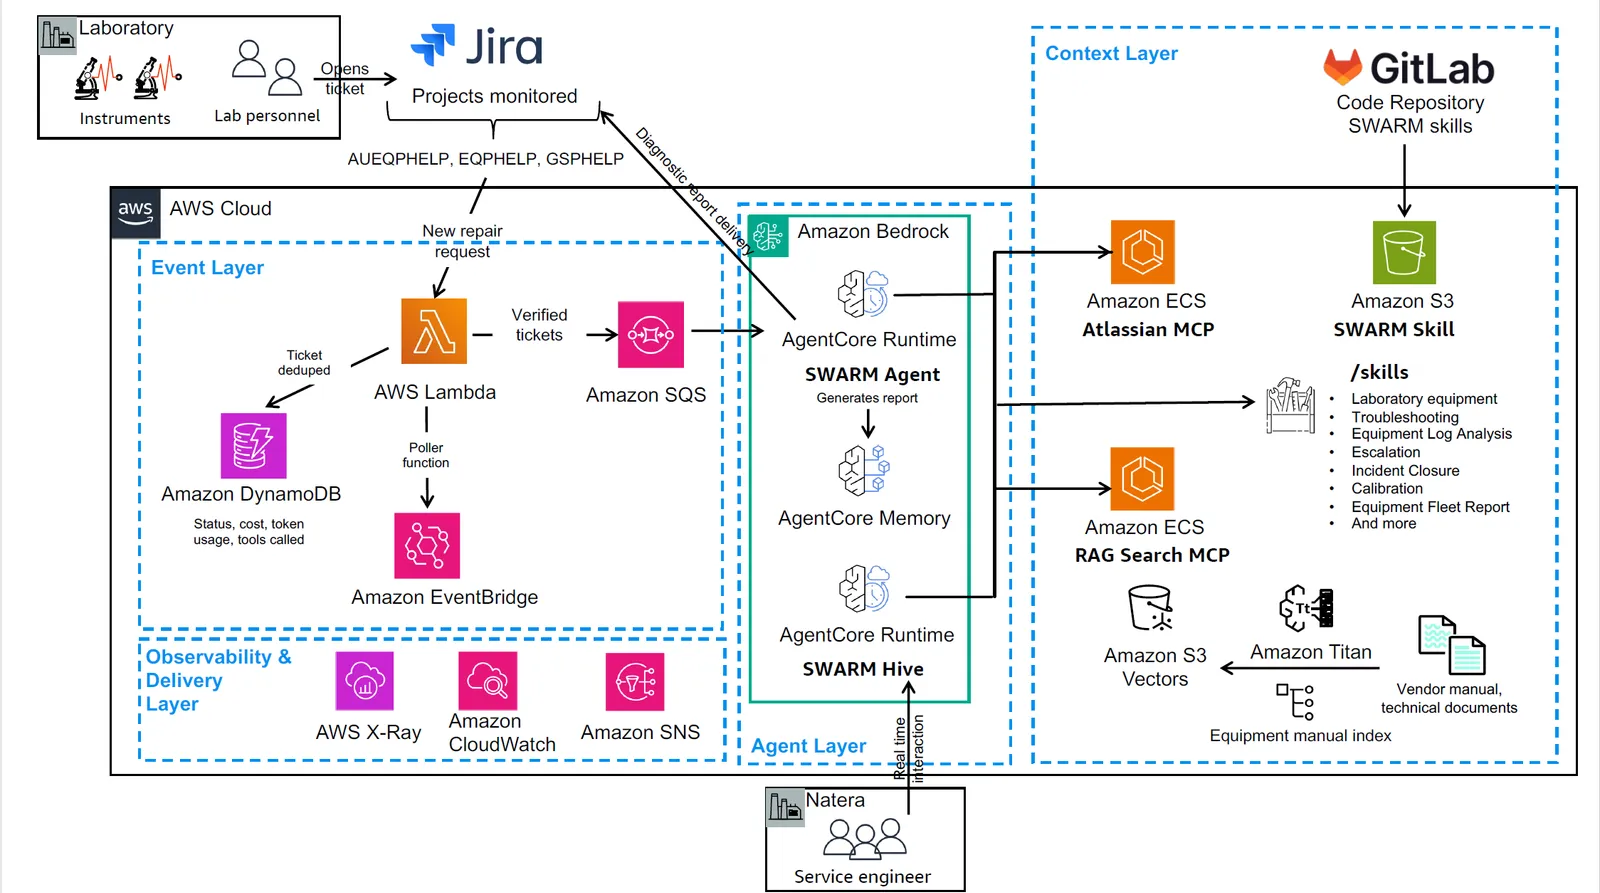
O SWARM combina dois ambientes de execução complementares que compartilham uma única biblioteca de habilidades. O componente swarm-agent gera de forma autônoma relatórios de diagnóstico estruturados antes que um engenheiro abra um ticket, enquanto os engenheiros usam o swarm-hive para interagir em tempo real, enviar imagens e explorar caminhos alternativos de solução de problemas.
"O sistema não substitui os engenheiros: dá a eles acesso a toda a profundidade do conhecimento institucional no momento em que um ticket chega", afirmou Jirau.
Quatro camadas conectam a arquitetura:
- A camada de eventos roteia os tickets do Jira por meio do Amazon EventBridge e do Amazon SQS.
- A camada de agentes hospeda o swarm-agent, o swarm-hive e a biblioteca de habilidades, e devolve os relatórios de diagnóstico aos engenheiros.
- A camada de contexto se apoia em manuais de fornecedores, tickets históricos e dados operacionais.
- A camada de observabilidade e entrega captura rastros, logs e métricas.
Arquitetura de segurança
Decidir onde os agentes seriam executados foi a primeira escolha arquitetônica da equipe. Eles precisavam de um ambiente de execução gerenciado capaz de cuidar da orquestração de contêineres, da escalabilidade e da segurança sem manter infraestrutura própria, e escolheram o AgentCore runtime, um recurso do Amazon Bedrock AgentCore. Ele hospeda tanto o swarm-agent quanto o swarm-hive em um ambiente seguro e gerenciado, com gerenciamento de identidade e monitoramento integrados, eliminando a necessidade de construir e operar uma camada própria de execução de agentes. O padrão pode ser adotado independentemente do framework escolhido.
Como o SWARM opera em um ambiente clínico onde a exposição de credenciais é inaceitável, a equipe adotou um modelo de implantação sem chaves. O OpenID Connect (OIDC) e o AWS Security Token Service (AWS STS) geram credenciais temporárias com escopo por implantação, sem chaves de longa duração no pipeline. O IAM aplica o privilégio mínimo no nível do componente. O Amazon Virtual Private Cloud (Amazon VPC) com sub-redes privadas e endpoints de VPC mantém o tráfego fora da internet pública, enquanto o AWS Secrets Manager rotaciona automaticamente as poucas credenciais existentes em um ciclo de 30 dias.
Os runners do GitLab CI se autenticam na AWS apresentando um token OIDC a um provedor de identidade do IAM configurado na conta, e o AWS STS troca o token por credenciais de curta duração com escopo no papel de implantação, de modo que nenhuma chave de acesso de longa duração fica armazenada no pipeline. A política de confiança OIDC do IAM para o GitLab CI segue esta estrutura:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Federated": "arn:aws:iam::ACCOUNT_ID:oidc-provider/gitlab.com"
      },
      "Action": "sts:AssumeRoleWithWebIdentity",
      "Condition": {
        "StringEquals": {
          "gitlab.com:sub": "project_path:YOUR_PROJECT:ref_type:branch:ref:main"
        }
      }
    }
  ]
}
Esses controles no nível da infraestrutura funcionam em conjunto com as políticas de governança de dados do SWARM, formando a postura de conformidade completa exigida para operar um sistema de IA em um ambiente clínico regulado.
Conformidade e governança de dados
O SWARM roda em serviços da AWS elegíveis para HIPAA sob um Business Associate Agreement (BAA), em consonância com as obrigações da Natera como operadora de laboratório clínico. Cada invocação do agente é registrada em um log de auditoria que constitui um registro pesquisável e atende aos requisitos de rastreabilidade de acesso a dados. Nenhuma informação identificável de pacientes chega ao índice vetorial ou ao modelo de linguagem; os tickets contêm apenas metadados de equipamentos e fluxos de trabalho. Equipes que constroem sob HIPAA ou marcos regulatórios semelhantes devem confirmar a cobertura do BAA e os requisitos de separação de dados antes de projetar o pipeline da base de conhecimento.
Base de conhecimento e pipeline de documentos
Os primeiros protótipos que usavam recuperação de propósito geral sem metadados específicos de equipamentos produziam resultados inconsistentes, então a equipe construiu um pipeline personalizado de processamento de documentos adaptado à documentação técnica dos equipamentos. O Amazon Titan Text Embeddings gera as representações vetoriais para busca semântica, e o Amazon Bedrock Knowledge Bases fornece Retrieval Augmented Generation (RAG) totalmente gerenciado. Os documentos são convertidos em embeddings em lotes de 100, tamanho escolhido para equilibrar a vazão de indexação com os limites de taxa da API. Para documentos de origem muito estruturados, com tabelas e diagramas, a equipe constatou que investir em um pipeline de análise personalizado, em vez de depender da fragmentação padrão, multiplica os ganhos de precisão em cada diagnóstico.
Os serviços do Amazon Bedrock, incluindo o Amazon Titan Text Embeddings e o Amazon Bedrock AgentCore, estão disponíveis em várias regiões da AWS.
A equipe usa o tokenizador tiktoken com a codificação cl100k_base para medir os limites dos fragmentos:
# Document chunking configuration
chunk_size = 1000  # tokens
chunk_overlap = 150  # tokens
encoding = tiktoken.get_encoding("cl100k_base")
batch_size = 100  # documents per embedding API call
"A precisão do diagnóstico é, antes de tudo, um problema de qualidade de dados", disse Jirau. "Adicionar os manuais de fornecedor que faltavam para a família de instrumentos com pior pontuação elevou a precisão de 71% para 75% sem nenhuma mudança no modelo."
Isso moldou a abordagem de melhoria da equipe: quando a precisão estagna, a cobertura de dados é verificada antes do ajuste do modelo, porque lacunas na documentação de fornecedores são a causa mais comum de diagnósticos perdidos. O pipeline reprocessa documentos novos ou atualizados e atualiza o índice vetorial sem interromper as operações ativas.
Arquitetura da biblioteca de habilidades
A equipe enfrentou uma escolha arquitetônica importante: embutir a lógica diretamente nos prompts do agente ou construir uma biblioteca de habilidades separada e versionada, e optou pela biblioteca porque ela torna o SWARM auditável e passível de melhoria.
"Quando um diagnóstico está errado, precisamos apontar uma habilidade específica em vez de depurar o sistema inteiro; foi por isso que construímos uma biblioteca de habilidades versionada desde o início", explicou Jirau.
A biblioteca contém 33 habilidades: 24 específicas de instrumentos, cobrindo toda a gama de famílias de equipamentos que a Natera atende, mais 9 habilidades transversais de fluxo de trabalho aplicáveis a diversos tipos de tickets. Cada habilidade tem uma interface definida, pode ser testada de forma independente e é avaliada pelos mesmos padrões do sistema completo — tratada como software de produção, e não como lógica embutida em prompts.
A arquitetura de habilidades segue uma divisão clara: o Python cuida das tarefas determinísticas, como analisar campos do Jira ou formatar relatórios HTML, enquanto as habilidades baseadas em modelos de linguagem de grande porte (LLM) tratam do raciocínio linguístico, como interpretar sintomas, corresponder documentação de fornecedores e gerar narrativas de diagnóstico. Para equipes que constroem um agente com múltiplas habilidades, essa divisão entre habilidades determinísticas em Python e habilidades de raciocínio com LLM é uma das decisões de maior impacto.
Implantação do ambiente de execução dos agentes
A Natera dividiu o trabalho de diagnóstico em dois ambientes de execução distintos porque a análise autônoma em segundo plano e a colaboração interativa com engenheiros têm requisitos de latência e contexto fundamentalmente diferentes. O swarm-agent é otimizado para vazão: seleciona habilidades conforme o tipo de equipamento e os sintomas, consulta a base de conhecimento e produz um relatório HTML estruturado com uma hipótese de causa principal, etapas de solução classificadas e um rótulo de confiança. O relatório é entregue ao Amazon Simple Storage Service (Amazon S3) e vinculado ao ticket do Jira em poucos minutos.
O swarm-hive é projetado para profundidade: os engenheiros podem conduzir conversas interativas de acompanhamento, enviar imagens e explorar caminhos alternativos, enquanto o AgentCore memory, um recurso do Amazon Bedrock AgentCore, mantém o contexto conversacional de cada engenheiro entre sessões. Como o swarm-hive aceita entradas de texto livre dos engenheiros, os prompts passam pelo Amazon Bedrock Guardrails para filtragem de conteúdo.
Integração com o Jira orientada a eventos
O SWARM se integra ao Jira por meio do Amazon EventBridge Scheduler e de uma função de sondagem do AWS Lambda — um serviço de computação sem servidor que executa código em resposta a eventos —, evitando a configuração de webhooks. Os tickets verificados entram em uma fila do Amazon SQS para entrega confiável. O DynamoDB cuida da desduplicação usando o ID do ticket como chave de partição com expiração baseada em tempo de vida (TTL), e armazena metadados por execução, como status, custo e uso de tokens, para alimentar o ciclo de avaliação. Esse padrão do EventBridge para o SQS desacopla o ambiente de execução do agente da disponibilidade do sistema de tickets. A tabela de desduplicação usa um esquema mínimo com expiração por TTL:
dynamodb.create_table(
    TableName='swarm-deduplication',
    KeySchema=[
        {'AttributeName': 'ticket_id', 'KeyType': 'HASH'}
    ],
    AttributeDefinitions=[
        {'AttributeName': 'ticket_id', 'AttributeType': 'S'}
    ],
    TimeToLiveSpecification={
        'Enabled': True,
        'AttributeName': 'ttl'
    }
)
Projeto de observabilidade
Sistemas agênticos com muitos componentes interagentes são difíceis de depurar sem rastros por invocação, por isso a equipe incorporou a observabilidade ao SWARM antes da primeira implantação em produção. Em um ambiente de laboratório clínico, onde o tempo de inatividade dos instrumentos afeta diretamente os relatórios de pacientes, a capacidade de rastrear, alertar e auditar cada ação do agente é um requisito regulatório e operacional, e não um recurso opcional.
A pilha de observabilidade usa o Amazon CloudWatch para capturar logs pesquisáveis de cada execução. O AWS X-Ray rastreia cada execução desde a entrada do ticket até o relatório de diagnóstico, registrando tempo e custo por chamada de ferramenta, de modo que a equipe possa identificar a habilidade específica responsável quando algo fica lento ou caro. O Amazon Simple Notification Service envia alertas de falha por e-mail, enquanto um rastreador no Slack dá a toda a equipe visibilidade em tempo real da atividade do agente.
Metodologia de avaliação contínua
O SWARM usa um ciclo de avaliação contínua em vez de um único teste na implantação, algo especialmente crítico para sistemas que lidam com documentação em mudança ou fluxos de trabalho em evolução. Em cada ticket processado, o agente entrega uma hipótese de causa principal, etapas de solução classificadas e um rótulo de confiança autoavaliado. Os engenheiros registram o que encontraram e corrigiram, e um avaliador classifica cada resposta como Accurate, Partial ou Wrong, com detalhamento por família de instrumentos. Os resultados são revisados para identificar onde o agente está com desempenho inferior, a correção é aplicada — normalmente uma atualização da base de conhecimento — e o conjunto de avaliação é executado novamente para confirmar a melhoria.
Os rótulos de confiança autoavaliados do SWARM mostram uma relação direcional com a precisão real. Tickets com confiança High alcançam 74% de precisão em 154 casos avaliados, enquanto tickets com confiança Moderate e Low alcançam ambos 65% em 78 e 37 casos, respectivamente. A amostra de 37 casos com confiança Low é pequena demais para conclusões estatisticamente significativas, e a equipe espera que os dois níveis divirjam à medida que o conjunto de dados de avaliação cresça. Ainda assim, a separação entre High e os demais níveis dá aos engenheiros um sinal útil sobre o peso que devem atribuir a cada diagnóstico ao ler um relatório.
Desempenho
A equipe avaliou o SWARM em 524 tickets de suporte para estabelecer uma linha de base. Desses, 269 receberam um rótulo de confiança High, Moderate ou Low e tinham uma resolução verificada por engenheiro disponível para comparação; os demais estavam rotulados como none ou não tinham resolução verificada no momento da análise.
O tempo médio de primeira resposta caiu de 17,4 horas para cerca de 8 minutos, aproximadamente 130 vezes mais rápido, medido a partir dos metadados dos tickets do Jira ao longo de um período de avaliação em produção de 90 dias. A cobertura importa igualmente: 96,2% dos tickets recebem uma primeira resposta automatizada sem que um engenheiro precise iniciar o processo de diagnóstico, medida como a porcentagem de tickets recebidos que obtiveram um relatório de diagnóstico gerado pelo SWARM antes da revisão do engenheiro.
Lições de quem construiu IA agêntica em produção
Várias decisões arquitetônicas do SWARM se aplicam diretamente a equipes que constroem sistemas semelhantes:
- Tratar o tamanho e a sobreposição dos fragmentos como parâmetros ajustáveis; os valores corretos dependem de como os documentos de origem estão estruturados.
- Incorporar rastreabilidade à biblioteca de habilidades desde o início, para que um diagnóstico errado possa ser atribuído a uma habilidade específica sem depurar o sistema inteiro.
- Se uma carga de trabalho mistura processamento em lote com consultas interativas, separá-las em ambientes de execução distintos.
Primeiros passos
A equipe direciona os interessados ao repositório de exemplos do AgentCore, ao Building Agentic Systems on AWS e ao guia Getting Started with Amazon Bedrock AgentCore para implantar agentes com segurança em escala. Organizações de saúde e ciências da vida que enfrentem perda de conhecimento institucional, fluxos de trabalho operacionais de alto volume ou requisitos de conformidade clínica encontrarão nos padrões arquitetônicos do SWARM uma base replicável e testada em produção para construir sistemas de IA agêntica na AWS.