Natera, una empresa especializada en pruebas de ADN libre de células (cfDNA), depende de la disponibilidad continua de sus instrumentos de laboratorio porque las averías interrumpen el procesamiento de muestras. El equipo de ingeniería de laboratorio de la compañía, dirigido por Ariel Jirau, trabajó con AWS para crear SWARM (Systematic Workflow Analytics and Resolutions Manager), un sistema de IA agéntica para operaciones de laboratorio construido sobre Amazon Bedrock AgentCore. El sistema ofrece una primera respuesta unas 130 veces más rápida y alcanza una cobertura automatizada del 96,2 % de los tickets de soporte, poniendo el conocimiento institucional en manos de los ingenieros en el momento en que llega un ticket. Este artículo describe la arquitectura completa, desde la construcción de la base de conocimiento hasta el despliegue automatizado y la evaluación.
El problema de la continuidad del conocimiento
Las operaciones de laboratorio de Natera dependen de una amplia gama de instrumentos de precisión distribuidos en varias familias de equipos, cada una con sus propios modos de fallo, documentación de proveedor y patrones de resolución. El equipo de ingeniería de servicio encargado de mantener esta infraestructura se organizaba en torno a la experiencia individual profunda, no a procedimientos estandarizados. Cuando un técnico sénior que llevaba años diagnosticando una familia de instrumentos concreta dejó la empresa, el conocimiento que poseía se perdió de forma efectiva, y no existía ningún sistema para capturar, organizar y desplegar esa experiencia a escala.
La operación gestiona más de 65 tickets al día repartidos en tres colas de Jira, con un tiempo medio de primera respuesta de 17,4 horas, y el tiempo de inactividad de los instrumentos retrasaba las muestras de laboratorio y los informes de pacientes. Contratar más ingenieros no era suficiente. SWARM tenía que responder en minutos, producir diagnósticos precisos para una gran variedad de equipos y mejorar de forma continua mediante un bucle de evaluación estructurado.
Por qué Amazon Bedrock AgentCore
El equipo eligió construir SWARM sobre Amazon Bedrock AgentCore, un servicio de AWS totalmente gestionado y extensible diseñado para crear, desplegar, conectar, proteger y operar agentes de IA a escala. Tres requisitos fundamentales guiaron la decisión:
- Procesamiento autónomo de grandes volúmenes de tickets de soporte sin intervención humana.
- Integración profunda con las herramientas operativas existentes, como Jira y Confluence.
- Seguridad y observabilidad integradas —cifrado, integración con AWS Identity and Access Management (IAM) y trazado distribuido— sin que el equipo tuviera que construir y mantener infraestructura propia.
"Necesitábamos un entorno de ejecución gestionado que nos permitiera centrar el esfuerzo de ingeniería en la precisión diagnóstica en lugar de en la infraestructura: AgentCore nos dio eso, junto con gestión de identidades integrada y la flexibilidad de cambiar de modelo sin reescribir la lógica del agente", afirmó Jirau.
AgentCore se integra de forma nativa con Amazon DynamoDB, un servicio de base de datos NoSQL totalmente gestionado, Amazon Simple Queue Service (Amazon SQS) y AWS X-Ray, una capacidad de Amazon CloudWatch.
Dos agentes, una biblioteca de habilidades compartida
SWARM combina dos entornos de ejecución complementarios que comparten una única biblioteca de habilidades. El componente swarm-agent genera de forma autónoma informes de diagnóstico estructurados antes de que un ingeniero abra un ticket, mientras que los ingenieros utilizan swarm-hive para interactuar en tiempo real, subir imágenes y explorar rutas alternativas de resolución de problemas.
"El sistema no sustituye a los ingenieros: les da acceso a toda la profundidad del conocimiento institucional en el momento en que llega un ticket", señaló Jirau.
Cuatro capas conectan la arquitectura:
- La capa de eventos enruta los tickets de Jira a través de Amazon EventBridge y Amazon SQS.
- La capa de agentes aloja swarm-agent, swarm-hive y la biblioteca de habilidades, y devuelve los informes de diagnóstico a los ingenieros.
- La capa de contexto se apoya en manuales de proveedores, tickets históricos y datos operativos.
- La capa de observabilidad y entrega captura trazas, registros y métricas.
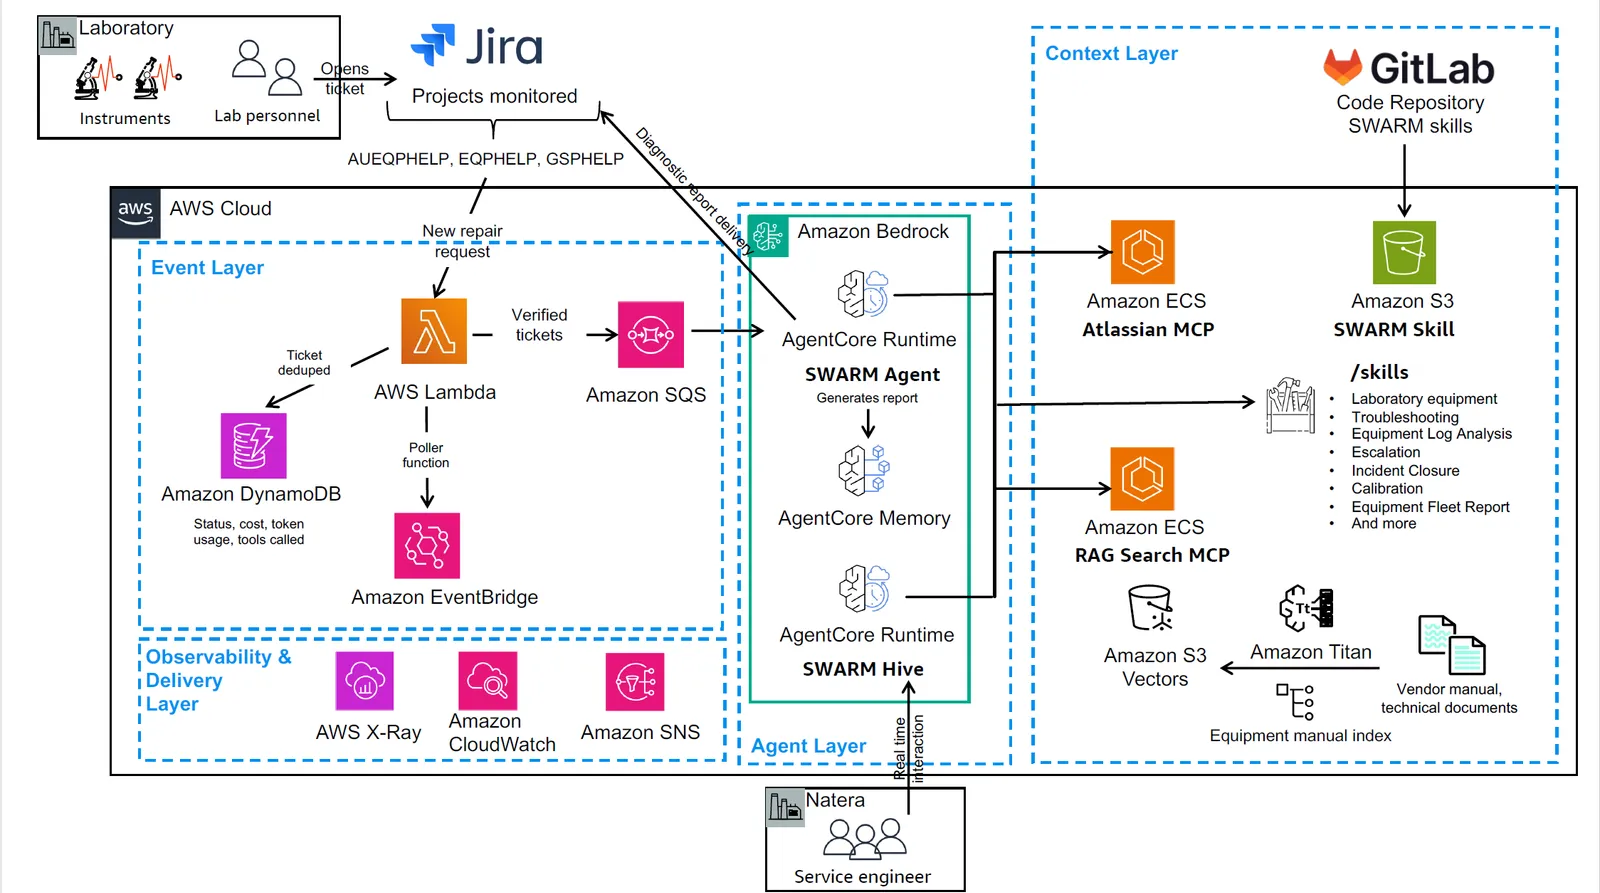
Arquitectura de seguridad
Decidir dónde se ejecutarían los agentes fue la primera elección arquitectónica del equipo. Necesitaban un entorno de ejecución gestionado capaz de encargarse de la orquestación de contenedores, el escalado y la seguridad sin mantener infraestructura propia, y eligieron AgentCore runtime, una capacidad de Amazon Bedrock AgentCore. Aloja tanto swarm-agent como swarm-hive en un entorno seguro y gestionado con gestión de identidades y monitorización integradas, lo que elimina la necesidad de construir y operar una capa de ejecución de agentes propia. Este patrón puede adoptarse con independencia del framework elegido.
Como SWARM opera en un entorno clínico donde la exposición de credenciales es inaceptable, el equipo adoptó un modelo de despliegue sin claves. OpenID Connect (OIDC) y AWS Security Token Service (AWS STS) generan credenciales temporales con alcance por despliegue, sin claves de larga duración en el pipeline. IAM aplica el principio de mínimo privilegio a nivel de componente. Amazon Virtual Private Cloud (Amazon VPC) con subredes privadas y endpoints de VPC mantiene el tráfico fuera de la internet pública, mientras que AWS Secrets Manager rota automáticamente las pocas credenciales existentes en un ciclo de 30 días.
Los ejecutores de GitLab CI se autentican en AWS presentando un token OIDC a un proveedor de identidad de IAM configurado en la cuenta, y AWS STS intercambia ese token por credenciales de corta duración con el alcance del rol de despliegue, por lo que no se almacenan claves de acceso de larga duración en el pipeline. La política de confianza OIDC de IAM para GitLab CI sigue esta estructura:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Federated": "arn:aws:iam::ACCOUNT_ID:oidc-provider/gitlab.com"
      },
      "Action": "sts:AssumeRoleWithWebIdentity",
      "Condition": {
        "StringEquals": {
          "gitlab.com:sub": "project_path:YOUR_PROJECT:ref_type:branch:ref:main"
        }
      }
    }
  ]
}
Estos controles de infraestructura actúan en conjunto con las políticas de gobernanza de datos de SWARM, formando la postura de cumplimiento completa necesaria para operar un sistema de IA en un entorno clínico regulado.
Cumplimiento y gobernanza de datos
SWARM se ejecuta sobre servicios de AWS elegibles para HIPAA en el marco de un Business Associate Agreement (BAA), en coherencia con las obligaciones de Natera como operador de laboratorio clínico. Cada invocación del agente queda registrada en un log de auditoría que constituye un registro consultable y satisface los requisitos de trazabilidad del acceso a datos. Ninguna información identificable de pacientes llega al índice vectorial ni al modelo de lenguaje; los tickets contienen únicamente metadatos de equipos y flujos de trabajo. Los equipos que construyan bajo HIPAA o marcos regulatorios similares deben confirmar la cobertura del BAA y los requisitos de separación de datos antes de diseñar el pipeline de la base de conocimiento.
Base de conocimiento y pipeline de documentos
Los primeros prototipos que utilizaban recuperación de propósito general sin metadatos específicos de equipos producían resultados inconsistentes, por lo que el equipo construyó un pipeline personalizado de procesamiento de documentos adaptado a la documentación técnica de los equipos. Amazon Titan Text Embeddings genera las representaciones vectoriales para la búsqueda semántica, y Amazon Bedrock Knowledge Bases proporciona Retrieval Augmented Generation (RAG) totalmente gestionado. Los documentos se convierten en embeddings en lotes de 100, un tamaño elegido para equilibrar el rendimiento de indexación con los límites de tasa de la API. Para documentos fuente muy estructurados, con tablas y diagramas, el equipo comprobó que invertir en un pipeline de análisis personalizado, en lugar de depender del fragmentado predeterminado, multiplica las ganancias de precisión en cada diagnóstico.
Los servicios de Amazon Bedrock, incluidos Amazon Titan Text Embeddings y Amazon Bedrock AgentCore, están disponibles en varias regiones de AWS.
El equipo utiliza el tokenizador tiktoken con la codificación cl100k_base para medir los límites de los fragmentos:
# Document chunking configuration
chunk_size = 1000  # tokens
chunk_overlap = 150  # tokens
encoding = tiktoken.get_encoding("cl100k_base")
batch_size = 100  # documents per embedding API call
"La precisión diagnóstica es ante todo un problema de calidad de datos", afirmó Jirau. "Añadir los manuales de proveedor que faltaban para la familia de instrumentos con peor puntuación elevó la precisión del 71 % al 75 % sin ningún cambio en el modelo."
Esto dio forma al enfoque de mejora del equipo: cuando la precisión se estanca, se revisa la cobertura de datos antes de ajustar el modelo, porque las lagunas en la documentación de proveedores son la causa más frecuente de diagnósticos fallidos. El pipeline reprocesa documentos nuevos o actualizados y refresca el índice vectorial sin interrumpir las operaciones activas.
Arquitectura de la biblioteca de habilidades
El equipo se enfrentó a una decisión arquitectónica clave: integrar la lógica directamente en los prompts del agente o construir una biblioteca de habilidades independiente y versionada, y optó por la biblioteca porque hace que SWARM sea auditable y mejorable.
"Cuando un diagnóstico es incorrecto, necesitamos poder señalar una habilidad concreta en lugar de depurar todo el sistema; por eso construimos una biblioteca de habilidades versionada desde el principio", explicó Jirau.
La biblioteca contiene 33 habilidades: 24 específicas de instrumentos que cubren toda la gama de familias de equipos que Natera mantiene, más 9 habilidades transversales de flujo de trabajo aplicables a distintos tipos de tickets. Cada habilidad tiene una interfaz definida, puede probarse de forma independiente y se evalúa con los mismos estándares que el sistema completo: se trata como software de producción, no como lógica incrustada en prompts.
La arquitectura de habilidades sigue una división clara: Python se encarga de las tareas deterministas, como analizar campos de Jira o formatear informes HTML, mientras que las habilidades basadas en modelos de lenguaje de gran tamaño (LLM) gestionan el razonamiento lingüístico, como interpretar síntomas, hacer corresponder documentación de proveedores y generar narrativas de diagnóstico. Para los equipos que construyen un agente con múltiples habilidades, esta división entre habilidades deterministas en Python y habilidades de razonamiento con LLM es una de las decisiones de mayor impacto.
Despliegue del entorno de ejecución de agentes
Natera dividió el trabajo de diagnóstico en dos entornos de ejecución distintos porque el análisis autónomo en segundo plano y la colaboración interactiva con ingenieros tienen requisitos de latencia y contexto fundamentalmente diferentes. swarm-agent está optimizado para el rendimiento: selecciona habilidades según el tipo de equipo y los síntomas, consulta la base de conocimiento y produce un informe HTML estructurado con una hipótesis de causa principal, pasos de resolución ordenados y una etiqueta de confianza. El informe se entrega en Amazon Simple Storage Service (Amazon S3) y se vincula al ticket de Jira en cuestión de minutos.
swarm-hive está diseñado para la profundidad: los ingenieros pueden mantener conversaciones interactivas de seguimiento, subir imágenes y explorar rutas alternativas, mientras que AgentCore memory, una capacidad de Amazon Bedrock AgentCore, conserva el contexto conversacional de cada ingeniero entre sesiones. Como swarm-hive acepta entradas de texto libre de los ingenieros, los prompts se enrutan a través de Amazon Bedrock Guardrails para el filtrado de contenido.
Integración con Jira basada en eventos
SWARM se integra con Jira a través de Amazon EventBridge Scheduler y una función de sondeo de AWS Lambda —un servicio de computación sin servidor que ejecuta código en respuesta a eventos—, lo que evita configurar webhooks. Los tickets verificados entran en una cola de Amazon SQS para una entrega fiable. DynamoDB gestiona la deduplicación utilizando el ID del ticket como clave de partición con expiración basada en tiempo de vida (TTL), y almacena metadatos por ejecución como el estado, el coste y el uso de tokens para alimentar el bucle de evaluación. Este patrón de EventBridge a SQS desacopla el entorno de ejecución del agente de la disponibilidad del sistema de tickets. La tabla de deduplicación usa un esquema mínimo con expiración por TTL:
dynamodb.create_table(
    TableName='swarm-deduplication',
    KeySchema=[
        {'AttributeName': 'ticket_id', 'KeyType': 'HASH'}
    ],
    AttributeDefinitions=[
        {'AttributeName': 'ticket_id', 'AttributeType': 'S'}
    ],
    TimeToLiveSpecification={
        'Enabled': True,
        'AttributeName': 'ttl'
    }
)
Diseño de la observabilidad
Los sistemas agénticos con muchos componentes que interactúan son difíciles de depurar sin trazas por invocación, por lo que el equipo incorporó la observabilidad en SWARM antes del primer despliegue en producción. En un entorno de laboratorio clínico, donde el tiempo de inactividad de los instrumentos afecta directamente a los informes de pacientes, la capacidad de trazar, alertar y auditar cada acción del agente es un requisito regulatorio y operativo, no una característica opcional.
La pila de observabilidad utiliza Amazon CloudWatch para capturar registros consultables de cada ejecución. AWS X-Ray traza cada ejecución desde la recepción del ticket hasta el informe de diagnóstico, registrando el tiempo y el coste por llamada a herramienta, de modo que el equipo puede identificar la habilidad concreta responsable cuando algo es lento o costoso. Amazon Simple Notification Service envía alertas de fallos por correo electrónico, mientras que un rastreador de Slack da a todo el equipo visibilidad en tiempo real de la actividad del agente.
Metodología de evaluación continua
SWARM utiliza un bucle de evaluación continua en lugar de una única prueba en el despliegue, algo especialmente crítico para sistemas que manejan documentación cambiante o flujos de trabajo en evolución. En cada ticket procesado, el agente entrega una hipótesis de causa principal, pasos de resolución ordenados y una etiqueta de confianza autoevaluada. Los ingenieros registran lo que encontraron y corrigieron, y un evaluador califica cada respuesta como Accurate, Partial o Wrong, desglosado por familia de instrumentos. Los resultados se revisan para identificar dónde rinde peor el agente, se aplica la corrección —normalmente una actualización de la base de conocimiento— y se vuelve a ejecutar el conjunto de evaluación para confirmar la mejora.
Las etiquetas de confianza autoevaluadas de SWARM muestran una relación direccional con la precisión real. Los tickets con confianza High alcanzan un 74 % de precisión en 154 casos evaluados, mientras que los de confianza Moderate y Low alcanzan ambos un 65 % en 78 y 37 casos respectivamente. La muestra de 37 casos de confianza Low es demasiado pequeña para extraer conclusiones estadísticamente significativas, y el equipo espera que los dos niveles diverjan a medida que crezca el conjunto de datos de evaluación. Aun así, la separación entre High y los demás niveles da a los ingenieros una señal útil sobre el peso que deben dar a cada diagnóstico al leer un informe.
Rendimiento
El equipo evaluó SWARM en 524 tickets de soporte para establecer una línea de base. De ellos, 269 recibieron una etiqueta de confianza High, Moderate o Low y contaban con una resolución verificada por un ingeniero disponible para la comparación; el resto estaba etiquetado como none o carecía de resolución verificada en el momento del análisis.
El tiempo medio de primera respuesta cayó de 17,4 horas a unos 8 minutos, aproximadamente 130 veces más rápido, medido a partir de los metadatos de los tickets de Jira durante un periodo de evaluación en producción de 90 días. La cobertura importa igualmente: el 96,2 % de los tickets recibe una primera respuesta automatizada sin que un ingeniero tenga que iniciar el proceso de diagnóstico, medida como el porcentaje de tickets entrantes que recibió un informe de diagnóstico generado por SWARM antes de la revisión del ingeniero.
Lecciones de construir IA agéntica en producción
Varias decisiones arquitectónicas de SWARM se trasladan directamente a equipos que construyen sistemas similares:
- Tratar el tamaño y el solapamiento de los fragmentos como parámetros ajustables; los valores correctos dependen de cómo estén estructurados los documentos fuente.
- Incorporar trazabilidad en la biblioteca de habilidades desde el principio, de modo que un diagnóstico incorrecto pueda atribuirse a una habilidad concreta sin depurar todo el sistema.
- Si una carga de trabajo mezcla procesamiento por lotes con consultas interactivas, separarlas en entornos de ejecución distintos.
Primeros pasos
El equipo remite a quienes construyen a los repositorios de ejemplos de AgentCore, a Building Agentic Systems on AWS y a la guía Getting Started with Amazon Bedrock AgentCore para desplegar agentes de forma segura a escala. Las organizaciones sanitarias y de ciencias de la vida que afronten pérdida de conocimiento institucional, flujos de trabajo operativos de gran volumen o requisitos de cumplimiento clínico encontrarán en los patrones arquitectónicos de SWARM una base replicable y probada en producción para construir sistemas de IA agéntica en AWS.