A Amazon anunciou em 12.11.2026 que o SGLang-Neuron já está disponível publicamente por meio de um AWS Deep Learning Container. O lançamento é da RadixArk em colaboração com a Annapurna Labs. O plugin permite servir modelos e gerar rollouts de aprendizado por reforço (RL) com o SGLang no AWS Trainium, mantendo a mesma interface do SGLang que os usuários já utilizam. Trainium é um portfólio de chips de IA da AWS que, segundo a empresa, oferece economia sólida para treinamento e inferência de IA em escala.
Com o SGLang-Neuron, executar o SGLang no Trainium segue o fluxo de trabalho habitual do SGLang: os modelos são lançados pela interface de servidor do SGLang e o endpoint é invocado com as mesmas APIs de geração. Por baixo dessa interface, o SGLang-Neuron roda sobre PyTorch nativo. Por ser um plugin out-of-tree, o suporte ao Trainium e o núcleo do SGLang podem ser desenvolvidos de forma independente e evoluir com mais rapidez.
Como o SGLang funciona no Trainium
O SGLang-Neuron conecta o SGLang ao AWS Trainium como um plugin out-of-tree. Ao instalá-lo, a plataforma neuron é registrada por meio dos pontos de entrada de plugins do SGLang, e a variável SGLANG_PLATFORM=neuron a seleciona quando o servidor é iniciado. O núcleo do SGLang continua fornecendo o servidor de API, o ciclo de vida das requisições, o RadixAttention e o gerenciamento do cache de prefixos, enquanto o plugin implementa os modelos específicos do Trainium, a atenção, a mistura de especialistas (MoE) e o executor de grafos (graph runner).
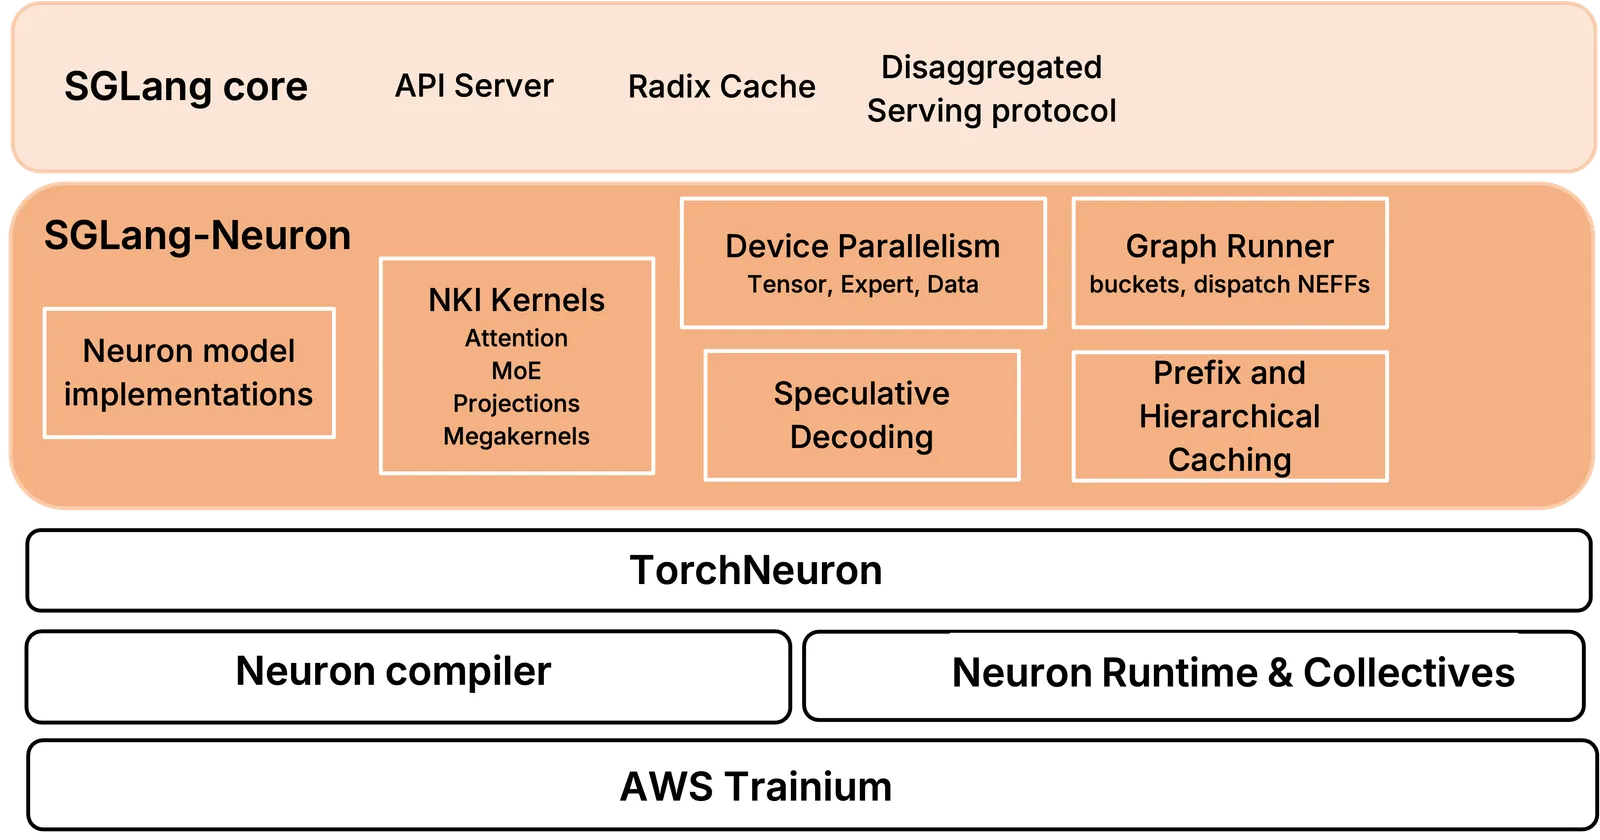
O TorchNeuron registra o Trainium como um dispositivo nativo do PyTorch. O caminho de execução do modelo no SGLang-Neuron usa operações padrão do PyTorch e incorpora kernels escritos com a Neuron Kernel Interface (NKI) para desempenho. Essas operações e kernels são compilados em programas executáveis com o torch.compile, que o executor de grafos prepara e executa durante o serviço.
O plugin também oferece suporte à desagregação PD. Nessa configuração, um servidor de prefill calcula o cache KV do prompt e o transfere para um servidor de decode usando NIXL sobre o Elastic Fabric Adapter (EFA). Em seguida, o servidor de decode gera os tokens restantes. Os dois servidores continuam usando o escalonador e o ciclo de vida de requisições do SGLang, enquanto o plugin gerencia a execução no Trainium e o caminho de transferência do cache KV.
Servindo modelos no AWS Trainium com o SGLang-Neuron
O passo a passo do anúncio usa uma instância Trainium3 do Amazon Elastic Compute Cloud (Amazon EC2) junto com um contêiner pytorch-inference-sglang-neuronx. As etapas são:
- Iniciar o contêiner.
docker run --rm -it \
--privileged --ipc=host \
-v /path/to/work:/work \
public.ecr.aws/neuron/pytorch-inference-sglang-neuron:v0.1.0-neuron-py314-sdk-2.33.0-ubuntu26.04 \
/bin/bash
- Iniciar o servidor de modelos do SGLang dentro do contêiner.
SGLANG_PLATFORM=neuron \
python -m sglang.launch_server \
--model-path openai/gpt-oss-120b \
--tp-size 8 \
--ep-size 8 \
--kv-cache-dtype fp8_e4m3 \
--context-length 10240 \
--chunked-prefill-size 8192 \
--max-running-requests 64 \
--max-total-tokens 655360 \
--mem-fraction-static 0.8 \
--host 127.0.0.1 \
--port 30000
- Enviar uma requisição ao servidor de modelos.
curl -s http://127.0.0.1:30000/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{
"model": "openai/gpt-oss-120b",
"messages": [
{"role": "user", "content": "Explain why the sky appears blue."}
],
"temperature": 0,
"max_tokens": 128
}'
Para mais informações, a AWS indica o guia de introdução do SGLang-Neuron para instruções de configuração e a documentação do repositório para modelos compatíveis, recursos e configurações validadas.
Conclusão
O SGLang-Neuron leva o conhecido fluxo de trabalho de serviço do SGLang ao AWS Trainium sobre PyTorch nativo. Para começar, basta lançar o contêiner do SGLang-Neuron e seguir o quickstart para servir um modelo compatível; o anúncio também convida os leitores a testá-lo com suas próprias cargas de trabalho, contribuir pelo repositório do projeto e compartilhar feedback para ajudar a moldar o suporte futuro a modelos e recursos.