Amazon anunció el 12.11.2026 que SGLang-Neuron ya está disponible de forma pública a través de un AWS Deep Learning Container. La publicación corre a cargo de RadixArk en colaboración con Annapurna Labs. El plugin permite servir modelos y generar rollouts de aprendizaje por refuerzo (RL) con SGLang en AWS Trainium manteniendo la misma interfaz de SGLang que los usuarios ya emplean. Trainium es una cartera de chips de IA de AWS que, según la compañía, ofrece una economía sólida para el entrenamiento y la inferencia de IA a escala.
Con SGLang-Neuron, ejecutar SGLang en Trainium sigue el flujo de trabajo habitual de SGLang: los modelos se lanzan a través de la interfaz de servidor de SGLang y el endpoint se invoca con las mismas API de generación. Por debajo de esa interfaz, SGLang-Neuron se ejecuta sobre PyTorch nativo. Al tratarse de un plugin out-of-tree, el soporte de Trainium y el núcleo de SGLang pueden desarrollarse de forma independiente e iterar con mayor rapidez.
Cómo funciona SGLang en Trainium
SGLang-Neuron conecta SGLang con AWS Trainium como un plugin out-of-tree. Al instalarlo se registra la plataforma neuron a través de los puntos de entrada de plugins de SGLang, y la variable SGLANG_PLATFORM=neuron la selecciona cuando arranca el servidor. El núcleo de SGLang sigue aportando el servidor de API, el ciclo de vida de las solicitudes, RadixAttention y la gestión de la caché de prefijos, mientras que el plugin implementa los modelos específicos de Trainium, la atención, la mezcla de expertos (MoE) y el ejecutor de grafos (graph runner).
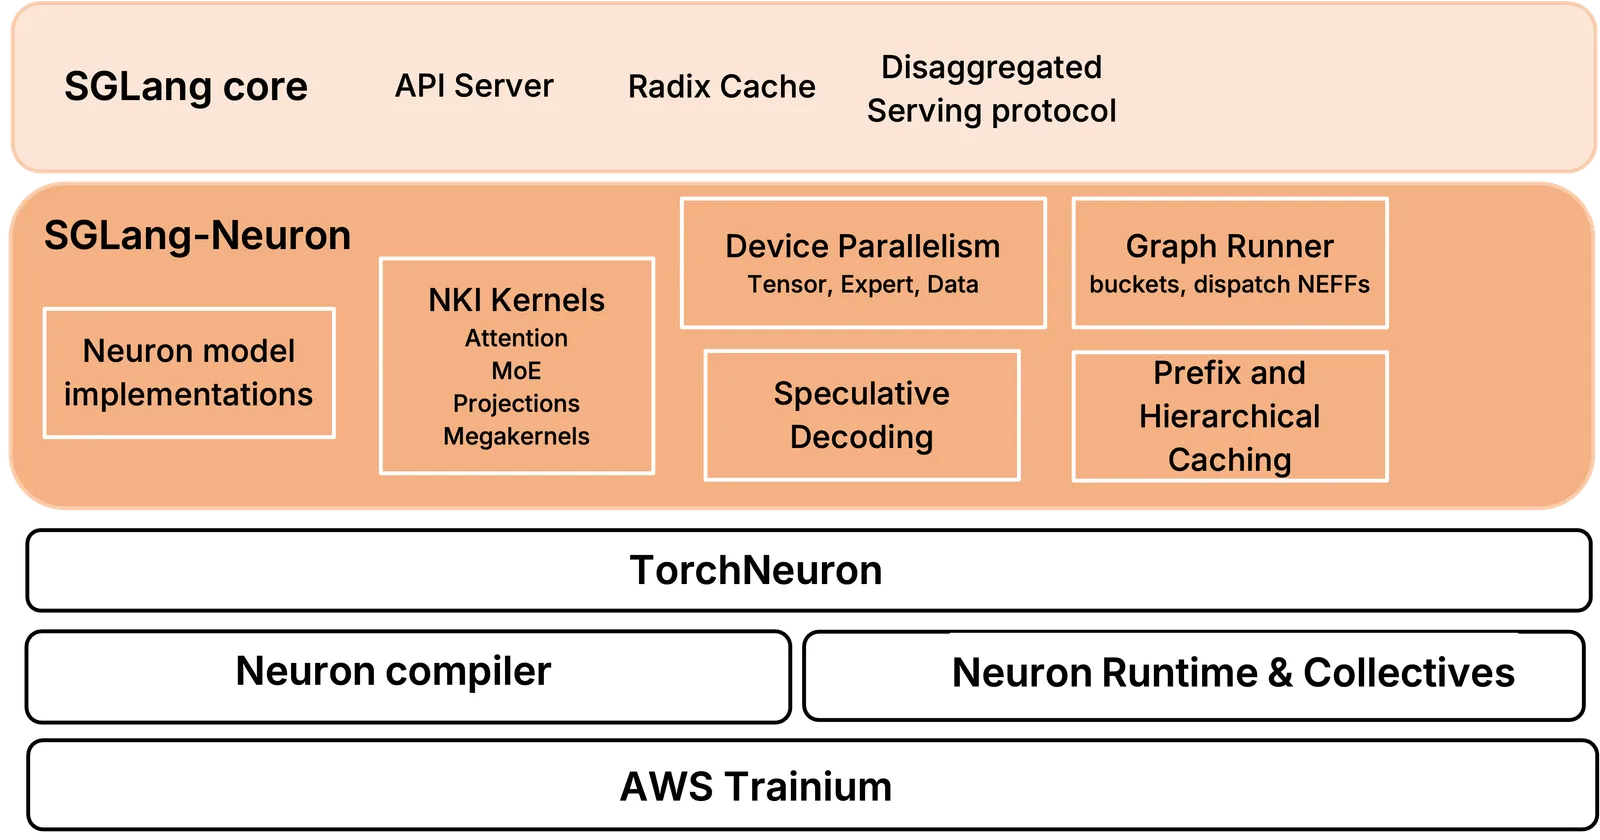
TorchNeuron registra Trainium como un dispositivo nativo de PyTorch. La ruta de ejecución del modelo en SGLang-Neuron utiliza operaciones estándar de PyTorch e incorpora kernels escritos con la Neuron Kernel Interface (NKI) para mejorar el rendimiento. Estas operaciones y kernels se compilan en programas ejecutables mediante torch.compile, que el ejecutor de grafos prepara y ejecuta durante el servicio.
El plugin también admite la desagregación PD. En esta configuración, un servidor de prefill calcula la caché KV del prompt y la transfiere a un servidor de decode mediante NIXL sobre Elastic Fabric Adapter (EFA). A continuación, el servidor de decode genera los tokens restantes. Ambos servidores siguen usando el planificador y el ciclo de vida de solicitudes de SGLang, mientras que el plugin gestiona la ejecución en Trainium y la ruta de transferencia de la caché KV.
Servicio de modelos en AWS Trainium con SGLang-Neuron
El recorrido del anuncio utiliza una instancia Trainium3 de Amazon Elastic Compute Cloud (Amazon EC2) junto con un contenedor pytorch-inference-sglang-neuronx. Los pasos son los siguientes:
- Iniciar el contenedor.
docker run --rm -it \
--privileged --ipc=host \
-v /path/to/work:/work \
public.ecr.aws/neuron/pytorch-inference-sglang-neuron:v0.1.0-neuron-py314-sdk-2.33.0-ubuntu26.04 \
/bin/bash
- Lanzar el servidor de modelos de SGLang dentro del contenedor.
SGLANG_PLATFORM=neuron \
python -m sglang.launch_server \
--model-path openai/gpt-oss-120b \
--tp-size 8 \
--ep-size 8 \
--kv-cache-dtype fp8_e4m3 \
--context-length 10240 \
--chunked-prefill-size 8192 \
--max-running-requests 64 \
--max-total-tokens 655360 \
--mem-fraction-static 0.8 \
--host 127.0.0.1 \
--port 30000
- Enviar una solicitud al servidor de modelos.
curl -s http://127.0.0.1:30000/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{
"model": "openai/gpt-oss-120b",
"messages": [
{"role": "user", "content": "Explain why the sky appears blue."}
],
"temperature": 0,
"max_tokens": 128
}'
Para más información, AWS remite a la guía de inicio de SGLang-Neuron para las instrucciones de configuración y a la documentación del repositorio para conocer los modelos compatibles, las funciones y las configuraciones validadas.
Conclusión
SGLang-Neuron lleva el conocido flujo de trabajo de servicio de SGLang a AWS Trainium sobre PyTorch nativo. Para empezar, basta con lanzar el contenedor de SGLang-Neuron y seguir la guía rápida para servir un modelo compatible; el anuncio también invita a probarlo con cargas de trabajo propias, contribuir a través del repositorio del proyecto y compartir comentarios que ayuden a definir el soporte futuro de modelos y funciones.