Una publicación de Show HN del 12.11.2026 presenta datatomcp, un servicio alojado que su creador describe como una capa de datos nativa de IA dirigida a equipos sin un equipo de datos propio. La idea es que el equipo conecte sus bases de datos, aplicaciones y hojas de cálculo una sola vez; el producto vincula las fuentes, registra lo que significa cada cifra y permite que cada agente de IA del equipo pida respuestas exactas. Según el sitio, cada pregunta queda registrada, cada número puede verificarse y la respuesta puede devolverse como un gráfico. El nivel gratuito cubre 3 conjuntos de datos y 2 personas, no pide tarjeta, es de solo lectura para los agentes y está alojado en la UE.
Configuración
El servicio puede añadirse desde el Claude Directory pulsando Connect e iniciando sesión, y el mismo conector funciona en escritorio y móvil. Para Claude Code, el agente de Cursor y Codex, el sitio indica apuntar el agente a https://datatomcp.com/install.md y seguir sus instrucciones. También hay un espacio de demostración en vivo disponible sin registro.
El argumento contra pegar hojas de cálculo
El argumento central del sitio es que pegar una hoja en el chat introduce cada fila en la ventana de contexto del modelo y consume tokens, mientras que con datatomcp el agente consulta una base de datos y recibe solo el resultado. En el archivo de prueba de pedidos de 50.000 filas del propio creador, reportan aproximadamente 475 veces menos tokens: pegar envía el archivo completo de 4.118.185 bytes, mientras que una sesión completa de datatomcp (lista de herramientas, esquema, consulta y resultado) envía 8.663 bytes. La comparación asume unos 4 bytes por token, valora la entrada de Claude Opus 5.5 en $4 por millón de tokens (octubre de 2026) y señala que Opus 5.5 tiene una ventana de contexto de 1M de tokens. Son mediciones del propio proveedor, no pruebas independientes. El sitio también afirma que los totales los calcula la base de datos en lugar de estimarlos el modelo.
Cinco pasos
El flujo del producto se presenta en cinco etapas: Connect, Link, Define, Ask y Audit.
Connect. Las fuentes admitidas son PostgreSQL, MySQL, Stripe (clientes, suscripciones con MRR, facturas, pagos), HubSpot (contactos, empresas, tratos) y Airtable; las hojas de Google se eligen en el selector de archivos de Google, que limita el acceso a los archivos elegidos y no a todo Drive; y se pueden subir archivos Excel y CSV. Cada fuente se convierte en un conjunto de datos que se mantiene sincronizado y guarda una versión por actualización. Cada importación genera un informe con las líneas que no pudieron leerse, los números guardados como texto y los formatos de fecha mezclados, y nada se convierte hasta que una persona lo confirma.
Link. La herramienta detecta los identificadores y códigos compartidos entre conjuntos de datos, como un customer_id presente tanto en orders como en customers, y dibuja un mapa de las relaciones. Los vínculos se encadenan, de modo que un agente puede totalizar pedidos por la región de un cliente en una sola consulta. Un vínculo solo se confirma automáticamente cuando todos los valores coinciden; en caso contrario se muestran las diferencias para que una persona decida. Las preguntas frecuentes añaden que los totales de un conjunto vinculado cuentan cada una de sus filas una vez, de modo que un objetivo nunca se suma dos veces.
Define. Datatomcp redacta definiciones a partir de las columnas, por ejemplo paid revenue como la suma de amount donde el status es paid. Una persona aprueba o edita cada definición y los agentes solo usan las aprobadas. Toda respuesta que emplea una definición lo indica, y un nombre desconocido devuelve las definiciones más cercanas en lugar de adivinar. Un glosario explica del mismo modo el vocabulario del equipo, como "active customer".
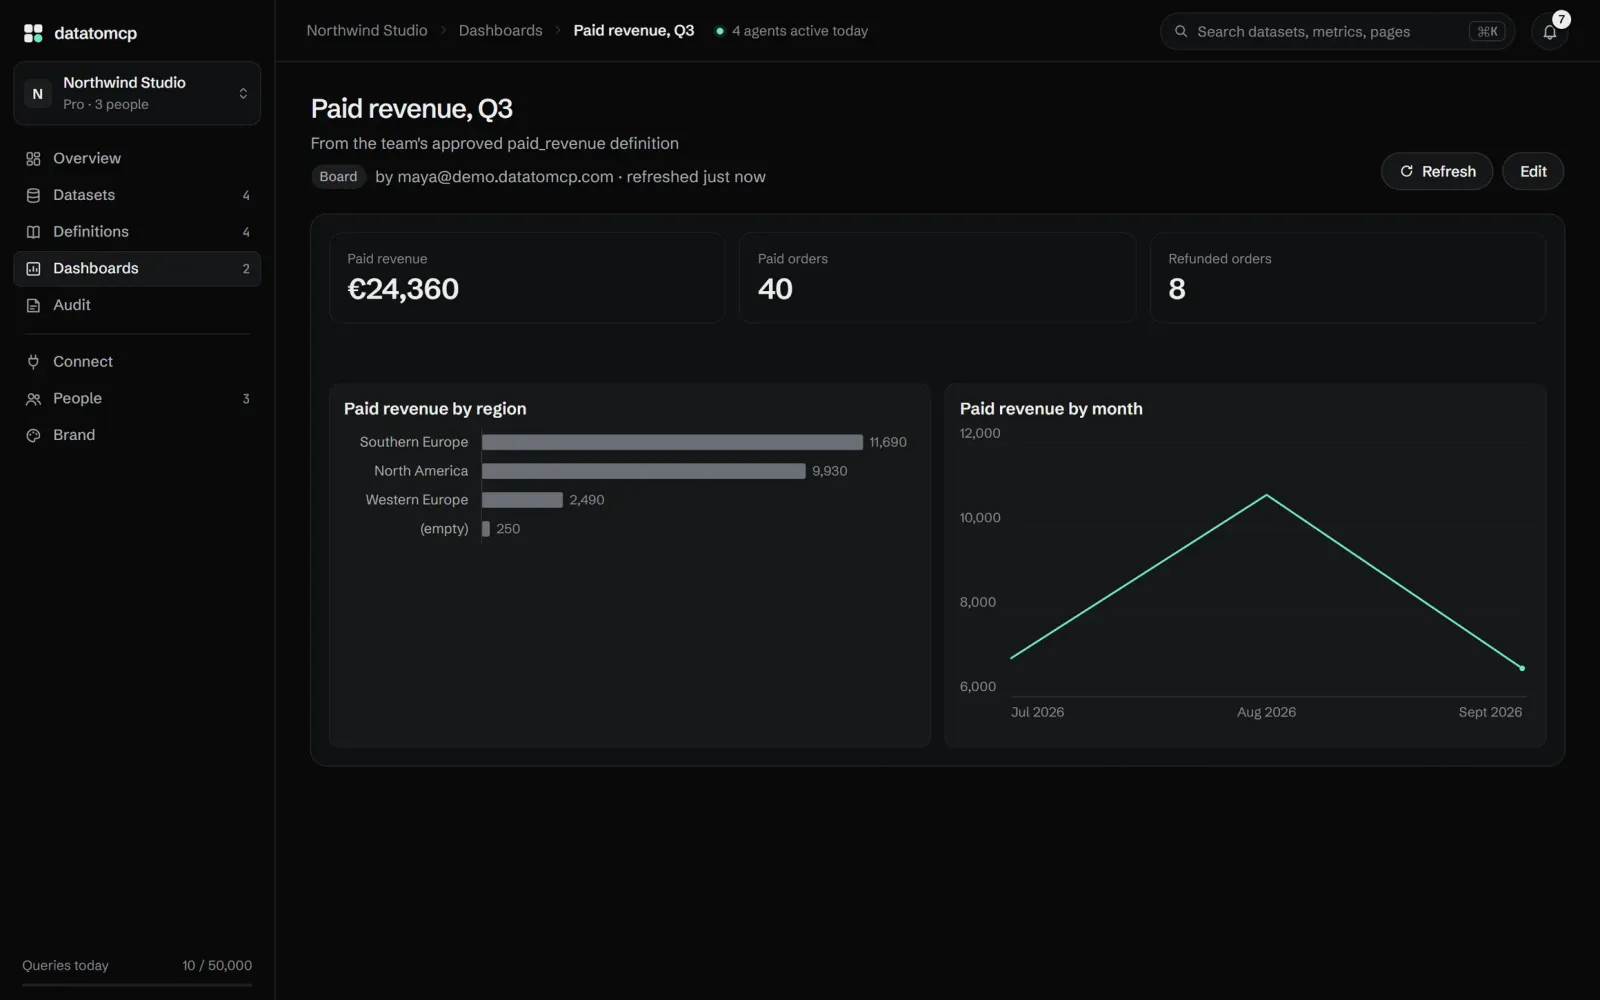
Ask. Una URL conecta Claude, ChatGPT, Cursor o cualquier cliente compatible con servidores MCP remotos; los agentes sin soporte MCP, los flujos de n8n y las aplicaciones propias usan la API REST con una clave, y ambas vías devuelven los mismos resultados. Como una base de datos cuenta las filas, los totales son exactos y cada respuesta nombra la versión del conjunto de datos de la que procede. Cuando una imagen resulta más clara, el agente dibuja un gráfico o crea un panel en el chat que cualquiera puede actualizar después.
Audit. Cada pregunta de un agente se conserva con quién la hizo, desde qué agente, sobre qué conjunto de datos, la consulta, el tiempo que tardó y cualquier error. Cuando dos agentes hacen la misma pregunta, la auditoría muestra si obtuvieron la misma respuesta. La retención es de 90 días en Pro y 30 días en Free, y el registro puede exportarse como hoja de cálculo.
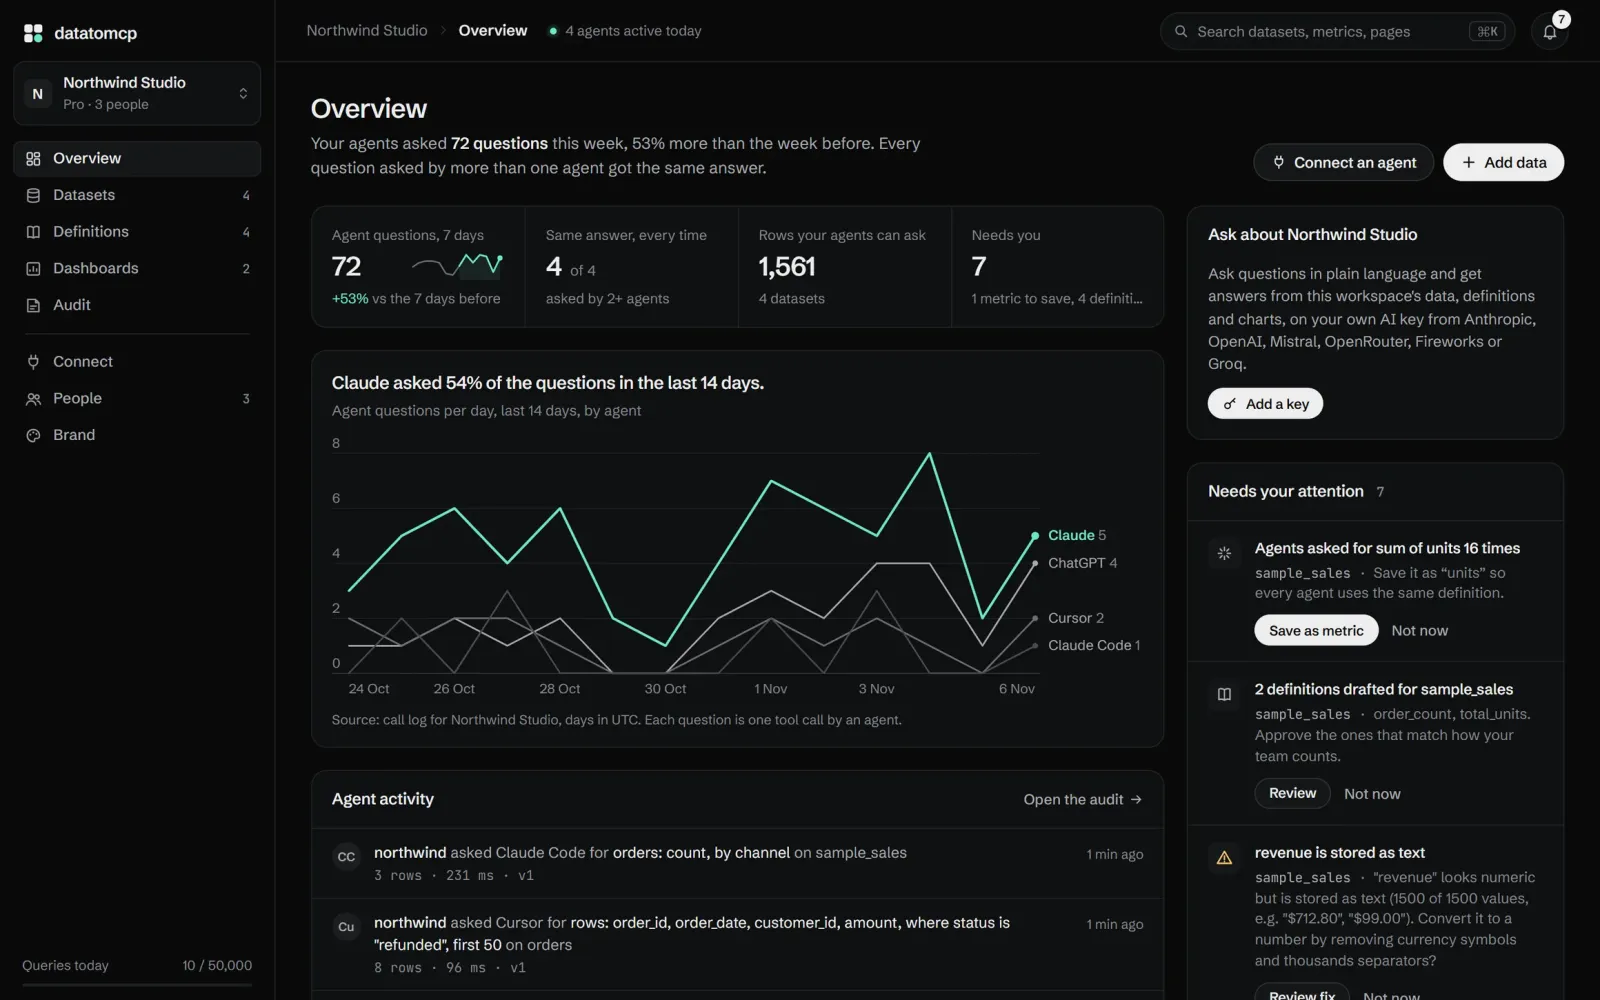
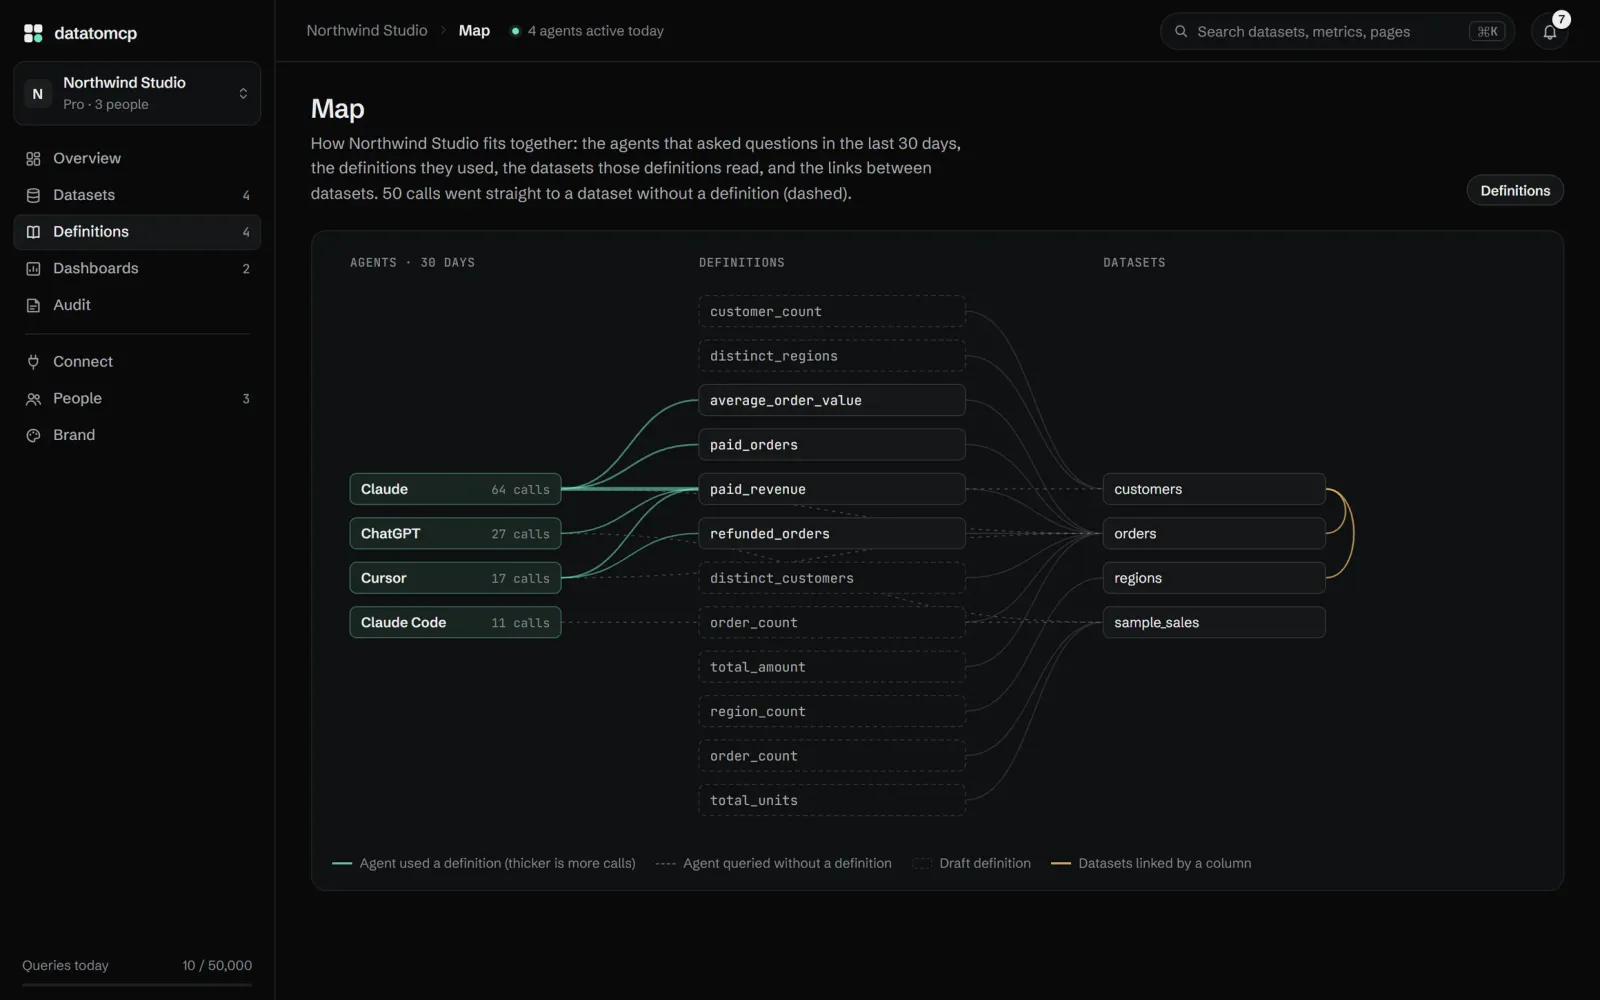
Qué pueden hacer los agentes
Por MCP, los agentes disponen de un conjunto fijo de herramientas: workspace_overview, list_datasets, describe_dataset, distinct_values, query_rows y aggregate para leer y contar; chart para dibujar la respuesta; create_dashboard, list_dashboards y refresh_dashboard para paneles; report_issue para señalar un problema de datos; y propose_definition, propose_link, propose_term y propose_brief para sugerir una definición, un vínculo, un término del glosario o el brief de negocio, que una persona debe aprobar en la aplicación antes de que cualquier agente lo use. connect_source inicia una nueva conexión y activity muestra lo que hicieron los agentes. Los datos permanecen de solo lectura por MCP, un propietario puede poner a cualquier agente en modo Analyze para que solo lea, y los agentes deliberadamente no pueden ejecutar SQL, para que un agente confundido no lance algo lento o inesperado.
La biblioteca de gráficos tiene 52 tipos (tendencias, comparaciones, cascadas, embudos, cohortes, scorecards y más) en variantes clara y oscura, que se dibujan dentro de las conversaciones de Claude y ChatGPT, por el asistente integrado y a través de la API REST. Si se le pide un panel, el agente produce un tablero o una breve historia de diapositivas en el espacio de trabajo, actualizable con los datos más recientes.
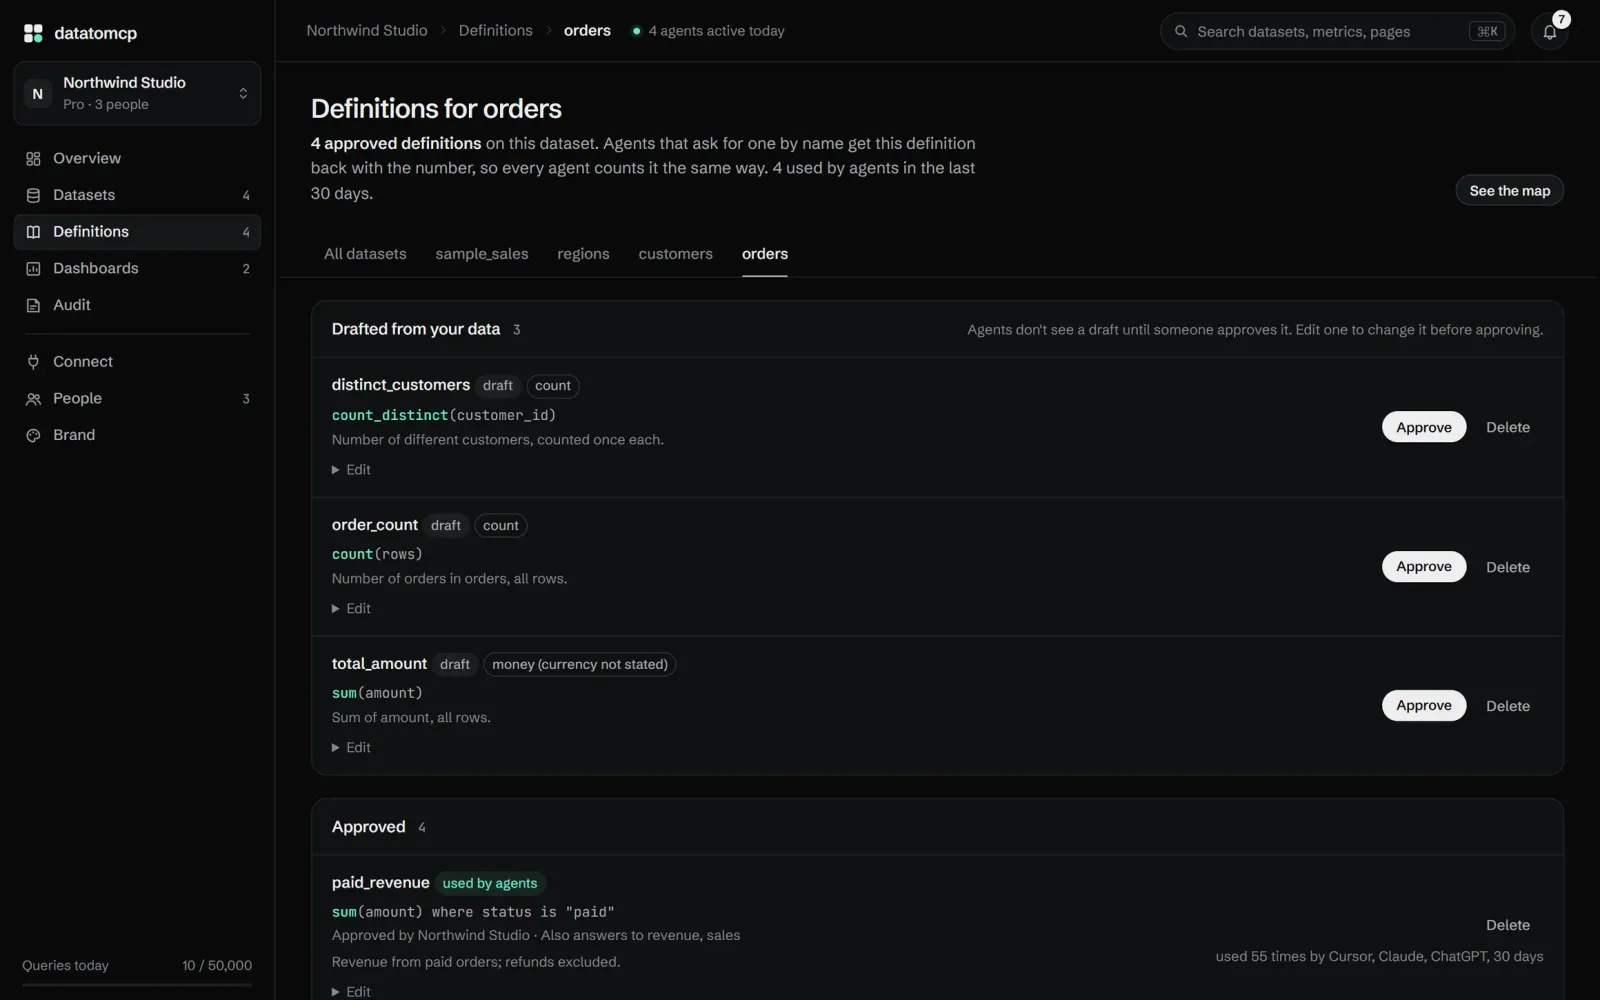
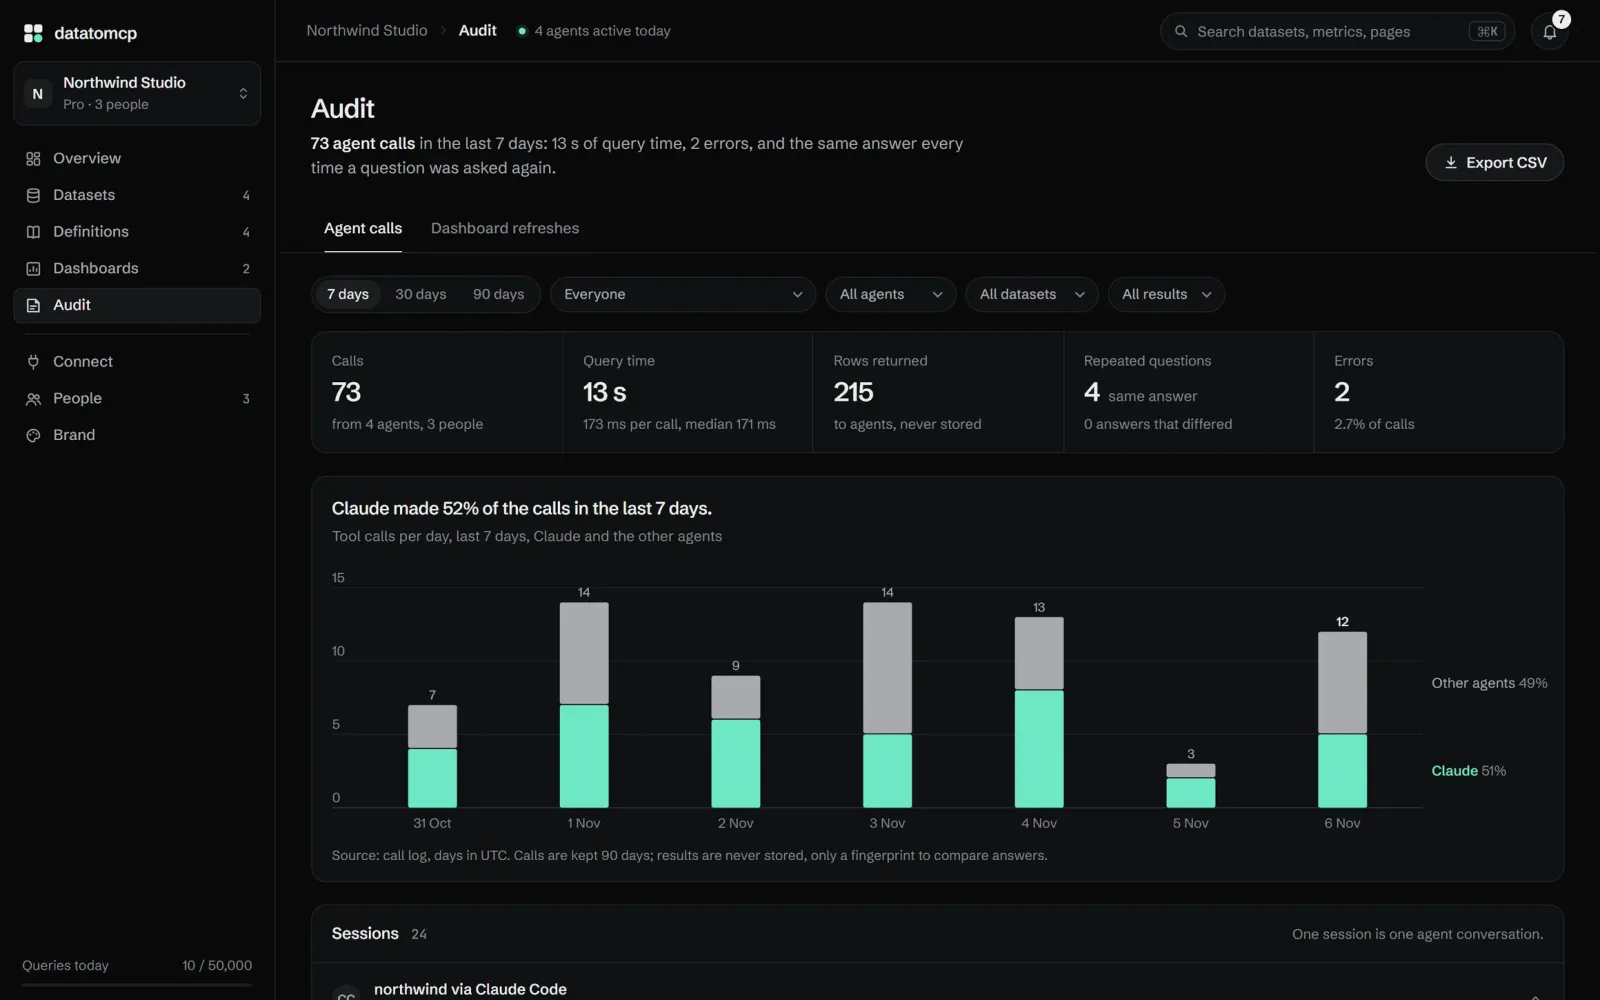
Trayectoria del fundador y funciones de equipo
El fundador Killian Helf escribe que ayuda a unas 300 personas de finanzas a usar agentes de IA en una empresa de Fortune 100, y que casi todas chocan con el mismo muro: pegan un CSV o una hoja de Google entera en el chat, el contexto se llena, los tokens se acumulan y los totales salen aproximados pero no exactos. Describe datatomcp como la herramienta que quería para ellos, de solo lectura para los agentes, alojada en la UE y honesta sobre sus límites; son afirmaciones suyas.
Los espacios de trabajo admiten editores, que añaden y actualizan datos, y visualizadores, que hacen preguntas. Cada persona conecta su propio agente una vez y ve los mismos conjuntos de datos en la misma versión, de modo que todos citan la misma cifra, y un registro de actividad muestra quién cambió qué y qué agente preguntó qué para quién. Los consultores y agencias pueden dar a cada cliente un espacio propio, limitar un agente a los datos de ese cliente y entregar el espacio; los planes Business amplían los límites de equipo. El espacio de demostración público, llamado Northwind Studio, contiene cifras reales y puede recorrerse sin cuenta.
Precios
El plan Free cuesta 0 € e incluye 3 conjuntos de datos, 100.000 filas por conjunto, 1.000 consultas al día, un espacio de trabajo con 2 personas, conjuntos vinculados, actualización a demanda y el servidor MCP y la API REST. Pro aparece a 12 €/mes, o $12, con 25 conjuntos de datos, 2.000.000 de filas por conjunto, 50.000 consultas al día, 3 espacios de trabajo con 5 personas cada uno, conjuntos vinculados, sincronización a los pocos minutos de una edición y el mismo acceso MCP y REST. Las mejoras se hacen en la aplicación y Pro puede cancelarse en cualquier momento desde el portal de facturación, manteniéndose hasta el final del periodo; al volver a Free, los conjuntos siguen siendo legibles pero no se pueden añadir más allá de los límites gratuitos. El uso no es silencioso: llega un correo al 80% del límite diario de consultas, los agentes reciben un error claro al 100%, el contador se reinicia a medianoche UTC y los conjuntos que superan el límite de filas se rechazan en la importación con el motivo.
Tratamiento de datos
El sitio afirma que los agentes leen solo mediante herramientas validadas de solo lectura y reciben únicamente los resultados que piden; los resultados de las consultas nunca se almacenan. Una copia de cada fuente conectada, un archivo por versión, junto con las copias de seguridad y las cuentas, se guarda en servidores de la UE, y los datos nunca se usan para entrenamiento. Dos funciones de IA son opcionales: las sugerencias de limpieza, que envían un resumen de columna y como máximo 50 filas de muestra a Mistral (UE) cuando un editor lo pide, y el asistente integrado, que funciona con la propia clave de IA del cliente. Cada solicitud exige inicio de sesión o una clave de API, las credenciales de bases de datos y aplicaciones están cifradas y nunca se muestran a los agentes, y al eliminar un conjunto de datos o una cuenta los datos desaparecen al instante y de las copias de seguridad en un plazo de 14 días. En los archivos desordenados, las filas que no se pueden analizar se listan con sus números de línea mientras el resto se importa, las columnas numéricas o de fecha inconsistentes se marcan, y las reglas de limpieza aprobadas por una persona se vuelven a ejecutar en cada actualización.
Datatomcp afirma estar listado en el Official MCP Registry, el Claude Directory y el Cursor Directory, además de en Glama y mcpservers.org.