ElevenLabs ha presentado dos nuevos modelos de reconocimiento de voz. Scribe v3 está pensado para archivos de audio grabados, mientras que Scribe v3 Live está orientado a aplicaciones en tiempo real con baja latencia. Ambos están diseñados para condiciones de audio difíciles, como conversaciones en las que varias personas hablan a la vez durante reuniones o llamadas telefónicas con ruido de fondo, y ya están disponibles a través de la interfaz para desarrolladores ElevenAPI y de la plataforma ElevenAgents.
Según la empresa, Scribe v3 reduce los errores de palabra en torno a un 25 por ciento respecto a su predecesor en 102 idiomas, y afirma que la precisión en alemán mejora de forma significativa. La diarización de hablantes también funciona con mayor fiabilidad en conversaciones con grupos más grandes, según ElevenLabs, y Scribe v3 Live la incorpora por primera vez a la transcripción en tiempo real.
Resultados de los benchmarks
Las pruebas independientes de Artificial Analysis sitúan a Scribe v3 entre los modelos de transcripción más precisos del mercado. Supera a los modelos competidores de Microsoft, Mistral, xAI, Google y OpenAI, y solo queda por detrás de un modelo en versión preliminar de Alibaba.
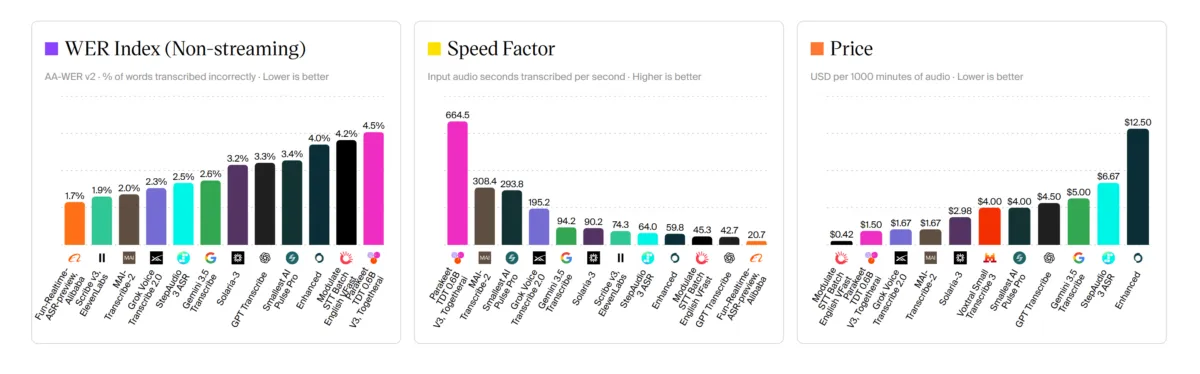
Sin embargo, el mismo benchmark refleja desventajas. Con un precio de referencia de 3,33 dólares por cada 1.000 minutos, ElevenLabs se sitúa en una posición intermedia tanto en velocidad como en precio: los modelos de Microsoft y xAI son muchas veces más rápidos, con tasas de error solo ligeramente superiores, y cuestan aproximadamente la mitad. Quien necesite procesar grandes volúmenes de audio de forma rápida y económica encontrará, por tanto, opciones más adecuadas en otros proveedores.
Además, la prueba mide únicamente los errores de palabra en archivos grabados. No recoge las mejoras que ElevenLabs destaca en la diarización de hablantes, en los idiomas menos comunes ni el comportamiento en tiempo real de Scribe v3 Live.
Un modelo en tiempo real para agentes de voz
En los agentes de voz, Scribe v3 Live pretende corregir un defecto habitual: los sistemas actuales suelen basarse en temporizadores de pausa rígidos y cortan a los interlocutores a media frase cuando hacen una pausa breve para pensar o dictan despacio una serie de números. El nuevo modelo analiza el contexto de la conversación junto con la señal de audio para determinar cuándo ha terminado realmente de hablar la persona.
ElevenLabs también ofrece a los desarrolladores un mayor control sobre la transcripción final. Los modelos pueden precargarse con miles de términos especializados, como nombres de marcas o medicamentos, para evitar que se malinterprete el vocabulario propio de cada ámbito. Las reglas de formato para números o fechas pueden definirse en lenguaje natural, y un modo multilingüe gestiona los cambios de idioma en mitad de una frase. Los clientes empresariales disponen de servidores aislados en la UE y de un modo de retención cero que elimina los datos inmediatamente después de cada solicitud.
Expansión empresarial
Junto a los nuevos modelos, ElevenLabs amplía su negocio empresarial. En el marco de una asociación ampliada con Nvidia, la empresa integra el modelo de lenguaje abierto Nemotron 3.5 Super VL en ElevenAgents, asegura capacidad de computación adicional sobre infraestructura de Nvidia, desarrolla control por voz local para robots y opera un agente telefónico para el sistema de salud pública de Polonia. La compañía también anunció una alianza con la consultora McKinsey, un programa de socios ampliado para integradores de sistemas y un marketplace propio en el que empresas como Salesforce, IBM y Zendesk ofrecen agentes de voz listos para usar.